Partager la publication "Les humanités numériques vues par Wikipédia : décrire et analyser un corpus avec IRaMuTeQ"
Dans l’article précédent, nous avions construit avec wiki2iramuteq un corpus IRaMuTeQ à partir d’une catégorie de Wikipédia. Il reste à s’en servir. Cet article prend un exemple concret, les 45 notices/articles de la catégorie « Humanités numériques » de Wikipédia en français, et le suit jusqu’à la classification de Reinert.
Le sujet a un petit côté vertigineux : on va analyser avec un outil des humanités numériques ce que Wikipédia dit des humanités numériques :-). Mais l’intérêt est surtout méthodologique. Entre le fichier brut et les classes lexicales, il y a trois étapes que les tutoriels sautent souvent : décrire le corpus, le nettoyer et relire les résultats d’un œil critique. C’est sur elles que porte cet article.
Le code et toutes les données sont dans le dépôt GitHub Anakeyn/wiki-hn-iramuteq. Il s’agit d’un exercice didactique : les résultats disent quelque chose de Wikipédia, pas de l’état de la recherche en humanités numériques.
Sommaire
- 1. Le corpus
- 2. Décrire avant d’analyser
- 3. Les premières statistiques révèlent le bruit
- 4. Le corpus nettoyé dans IRaMuTeQ
- 5. La classification de Reinert
- 6. Lecture critique des résultats
- Conclusion
1. Le corpus
Le corpus a été extrait le 20 octobre 2026 avec wiki2iramuteq. Il contient les 45 articles classés directement dans la catégorie « Humanités numériques », sans descendre dans les sous-catégories : tous portent la variable *prof_0, qui indique la profondeur dans l’arborescence.
Chaque article commence par une ligne étoilée, que IRaMuTeQ lit comme un ensemble de variables :
**** *art_Lexicometrie *id_Lexicometrie *cat_Humanites_numeriques *prof_0 *lang_fr
wiki2iramuteq produit aussi un fichier de métadonnées, wikipedia_fr_humanites_numeriques_metadonnees.csv, avec pour chaque article son titre, son URL, son numéro de révision et son nombre de mots. C’est ce fichier que nous allons exploiter d’abord.
Les textes viennent de Wikipédia et restent sous licence CC BY-SA 4.0. Leurs auteurs sont les contributeurs et contributrices de Wikipédia. Les extraits cités dans ce billet relèvent de la même licence.
2. Décrire avant d’analyser
Pourquoi décrire ?
La classification de Reinert ne travaille pas sur les articles, mais sur des segments de texte d’environ 40 mots. Un article de 6 500 mots fournit donc environ 160 segments, un article de 60 mots un seul. Avant de lancer le moindre calcul, il faut savoir si quelques articles risquent d’écraser les autres. C’est le rôle du script decrire_corpus.py.
Il n’a besoin que de deux bibliothèques, pandas et matplotlib pour la visualisation. Il est découpé en huit blocs notés « # %% x. nom du bloc » (par exemple ci-dessous « # %% 1. Charger les métadonnées », que l’on peut exécuter un par un dans Spyder ou VS Code ou Jupyter.
Charger les métadonnées
Le premier bloc lit le fichier de métadonnées. Le CSV de wiki2iramuteq liste aussi les articles écartés lors de la constitution du corpus : on ne garde que ceux dont la colonne retenu vaut 1.
# -*- coding: utf-8 -*-
"""
Décrire un corpus IRaMuTeQ avant de l'analyser, puis lui ajouter
une variable étoilée *taille_ (courte / moyenne / longue).

Fonctionne avec tout corpus produit par wiki2iramuteq :
le fichier .txt et son fichier _metadonnees.csv, dans le même dossier.

Usage :
    python3 decrire_corpus.py                       (corpus des humanités numériques)
    python3 decrire_corpus.py chemin/vers/corpus.txt

Sorties, dans le dossier resultats/ :
  - <corpus>_longueurs.png : graphique des longueurs
  - <corpus>_taille.txt    : corpus enrichi de la variable *taille_
"""
# %% 1. Charger les métadonnées
import sys
from pathlib import Path

import pandas as pd
import matplotlib.pyplot as plt

# Corpus à décrire : celui des humanités numériques par défaut,
# ou celui passé en argument sur la ligne de commande.
FICHIER_CORPUS = Path(sys.argv[1] if len(sys.argv) > 1
                      else "corpus/hn_fr/wikipedia_fr_humanites_numeriques.txt")
# wiki2iramuteq range les métadonnées à côté du corpus, avec le suffixe _metadonnees.csv
FICHIER_META = FICHIER_CORPUS.with_name(FICHIER_CORPUS.stem + "_metadonnees.csv")

DOSSIER_RESULTATS = Path("resultats")
DOSSIER_RESULTATS.mkdir(exist_ok=True)
FICHIER_GRAPHIQUE = DOSSIER_RESULTATS / (FICHIER_CORPUS.stem + "_longueurs.png")
FICHIER_SORTIE = DOSSIER_RESULTATS / (FICHIER_CORPUS.stem + "_taille.txt")

meta = pd.read_csv(FICHIER_META, encoding="utf-8")
# Le CSV liste aussi les articles écartés lors de la constitution du corpus
# (colonne retenu = 0) : on ne garde que ceux présents dans le corpus.
meta = meta[meta["retenu"] == 1].reset_index(drop=True)
print(f"Nombre d'articles : {len(meta)}")
print(meta[["titre", "mots"]].head())
Mesurer les longueurs et la concentration
Les blocs 2 et 3 calculent les statistiques de base, puis la part cumulée du texte, de l’article le plus long au plus court.
# %% 2. Statistiques descriptives sur la longueur des articles
print("\nLongueur des articles (en mots) :")
print(meta["mots"].describe().round(0))
print(f"Total : {meta['mots'].sum()} mots")

# Une moyenne très supérieure à la médiane signale une distribution
# asymétrique : quelques articles très longs tirent la moyenne vers le haut.
print(f"Moyenne : {meta['mots'].mean():.0f} - Médiane : {meta['mots'].median():.0f}")
# %% 3. Mesurer la concentration : quelle part du texte font les plus longs articles ?
tri = meta.sort_values("mots", ascending=False).reset_index(drop=True)
tri["part_%"] = 100 * tri["mots"] / tri["mots"].sum()
tri["part_cumulee_%"] = tri["part_%"].cumsum()
print("\nLes articles les plus longs :")
print(tri[["titre", "mots", "part_%", "part_cumulee_%"]].head(6).round(1))

# Nombre d'articles nécessaires pour atteindre la moitié du texte
n_moitie = (tri["part_cumulee_%"] < 50).sum() + 1
print(f"\n{n_moitie} articles sur {len(tri)} font la moitié du corpus.")
Sur le corpus d’origine, le résultat est net : la moyenne (966 mots) est très supérieure à la médiane (538 mots), signe de quelques articles très longs. 7 articles sur 45 font la moitié du texte, et l’article « Humanités numériques » en fait à lui seul 15 %.
Estimer le poids de chaque article dans la classification
Le bloc 4 traduit les longueurs en nombre de segments. Quatre articles fournissent moins de cinq segments : ENCCRE (un seul), Lou Burnard, TXM et le Centre pour les humanités numériques et l’histoire de la justice. Leur voix comptera très peu dans la classification.
# %% 4. Estimer le poids de chaque article dans une classification Reinert
# IRaMuTeQ découpe les textes en segments d'environ 40 mots, et c'est sur
# ces segments que travaille la classification. Un article long fournit
# donc beaucoup plus de segments qu'un article court.
TAILLE_SEGMENT = 40
meta["segments_estimes"] = (meta["mots"] / TAILLE_SEGMENT).round().astype(int)
courts = meta[meta["segments_estimes"] < 5]
print(f"\nArticles de moins de 5 segments ({len(courts)}) :")
print(courts[["titre", "mots", "segments_estimes"]].to_string(index=False))
Visualiser la distribution
Le bloc 5 trace un diagramme en barres avec, sur un second axe, la courbe de part cumulée. La ligne pointillée marque la moitié du corpus.
# %% 5. Visualiser la distribution des longueurs
fig, ax = plt.subplots(figsize=(11, 5))
ax.bar(range(len(tri)), tri["mots"], color="#4C78A8")
ax.set_xlabel("Articles, du plus long au plus court")
ax.set_ylabel("Nombre de mots")
ax.set_title(f"Longueur des {len(tri)} articles du corpus {FICHIER_CORPUS.stem}")
ax.set_xticks(range(len(tri)))
# Les titres trop longs sont raccourcis pour garder le graphique lisible
etiquettes = [t if len(t) <= 35 else t[:33] + "…" for t in tri["titre"]]
ax.set_xticklabels(etiquettes, rotation=90, fontsize=7)

# Courbe de part cumulée sur un second axe
ax2 = ax.twinx()
ax2.plot(range(len(tri)), tri["part_cumulee_%"], color="#E45756", marker=".")
ax2.axhline(50, color="#E45756", linestyle=":", linewidth=1)
ax2.set_ylabel("Part cumulée du corpus (%)", color="#E45756")
ax2.set_ylim(0, 105)
fig.tight_layout()
fig.savefig(FICHIER_GRAPHIQUE, dpi=150)
print(f"\nGraphique enregistré : {FICHIER_GRAPHIQUE}")
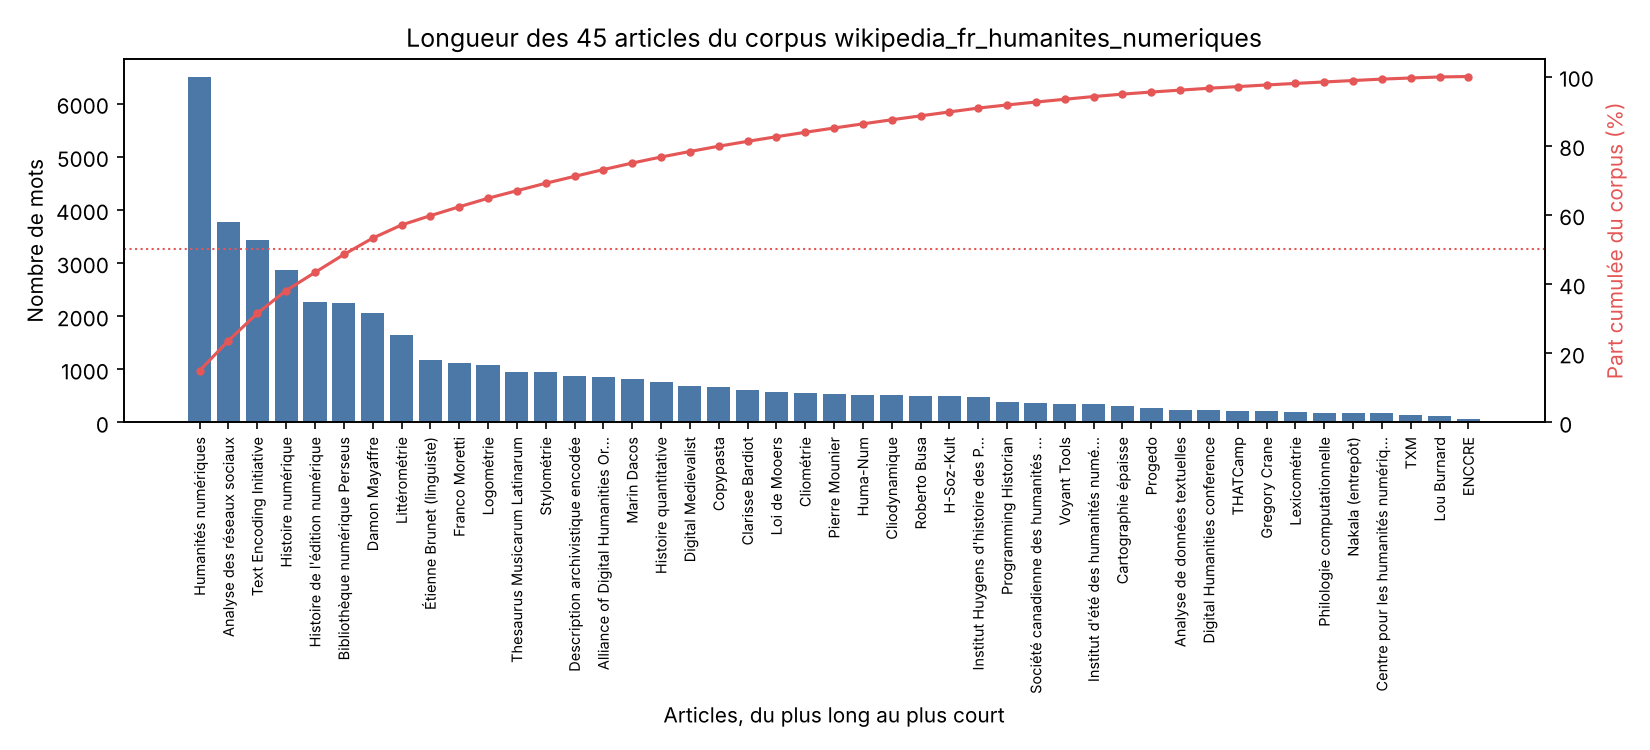
La forme est typique d’un corpus encyclopédique : une longue traîne d’articles courts et une poignée d’articles de synthèse qui portent l’essentiel du texte.
Construire une variable de taille
Les blocs 6 et 7 transforment cette observation en outil. On découpe la longueur en terciles, c’est-à-dire en trois groupes de 15 articles, puis on ajoute la variable *taille_courte, *taille_moyenne ou *taille_longue à la ligne étoilée de chaque article.
# %% 6. Découper la longueur en trois classes : les terciles
# On coupe à 1/3 et 2/3 de la distribution, ce qui donne trois groupes
# d'effectifs égaux. Ce choix est justifié plus bas dans l'article.
seuil_bas, seuil_haut = meta["mots"].quantile([1 / 3, 2 / 3])
print(f"\nSeuils des terciles : {seuil_bas:.0f} mots et {seuil_haut:.0f} mots")

meta["taille"] = pd.qcut(meta["mots"], q=3, labels=["courte", "moyenne", "longue"])

# Vérification : effectifs et part du texte par classe
bilan = meta.groupby("taille", observed=True).agg(
    articles=("titre", "count"),
    mots_min=("mots", "min"),
    mots_max=("mots", "max"),
    mots_total=("mots", "sum"),
)
bilan["part_du_texte_%"] = (100 * bilan["mots_total"] / meta["mots"].sum()).round(1)
print(bilan)
# %% 7. Ajouter la variable étoilée *taille_ dans le corpus IRaMuTeQ
# Chaque texte commence par une ligne "**** *var_modalite ...".
# On retrouve l'article grâce à sa variable *id_, puis on ajoute
# *taille_courte, *taille_moyenne ou *taille_longue en fin de ligne.
taille_par_id = dict(zip(meta["id"], meta["taille"].astype(str)))

lignes_sorties = []
modifiees = 0
with open(FICHIER_CORPUS, encoding="utf-8") as f:
    for ligne in f:
        if ligne.startswith("****"):
            variables = ligne.split()
            # On cherche la variable *id_ et on extrait l'identifiant
            ident = next(v[len("*id_"):] for v in variables if v.startswith("*id_"))
            # On supprime une éventuelle ancienne variable *taille_
            variables = [v for v in variables if not v.startswith("*taille_")]
            variables.append(f"*taille_{taille_par_id[ident]}")
            ligne = " ".join(variables) + "\n"
            modifiees += 1
        lignes_sorties.append(ligne)

with open(FICHIER_SORTIE, "w", encoding="utf-8") as f:
    f.writelines(lignes_sorties)

print(f"\n{modifiees} en-têtes enrichis -> {FICHIER_SORTIE}")
Pourquoi des terciles plutôt que des seuils ronds ? Pour trois raisons :
- des effectifs équilibrés : 15 articles par modalité, ce qui garde interprétables les tests du χ² d’IRaMuTeQ ;
- pas de seuil arbitraire : les bornes viennent de la distribution elle-même et se recalculent sur n’importe quel autre corpus ;
- une robustesse aux valeurs extrêmes : un découpage par rangs n’est pas tiré vers le haut par l’article de 6 500 mots, contrairement à la moyenne.
La limite est connue d’avance : les trois groupes ont le même nombre d’articles, mais pas le même poids. Les 15 articles longs font près des trois quarts du texte. C’est précisément ce déséquilibre que la variable rendra visible dans les résultats : si une classe est associée à *taille_longue, elle traduit peut-être un effet de volume plutôt qu’un thème partagé.
Le dernier bloc vérifie le fichier produit :
# %% 8. Vérifier le résultat
with open(FICHIER_SORTIE, encoding="utf-8") as f:
    entetes = [l.strip() for l in f if l.startswith("****")]
print(f"Nombre de textes : {len(entetes)}")
for e in entetes[:3]:
    print(e)
La ligne étoilée devient :
**** *art_Lexicometrie *id_Lexicometrie *cat_Humanites_numeriques *prof_0 *lang_fr *taille_courte
3. Les premières statistiques révèlent le bruit
Ce que montre IRaMuTeQ
Le corpus enrichi s’ouvre dans IRaMuTeQ par Fichier → Ouvrir un corpus. Une fenêtre de paramètres apparaît : on choisit l’encodage utf-8 et la langue french. C’est aussi à ce moment que se règle la taille des segments de texte, ici 40 occurrences, et non au lancement de la classification. La case Utiliser le dictionnaire des expressions est cochée : c’est elle qui soude des expressions comme c’est-à-dire en une seule forme, c_est_à_dire.
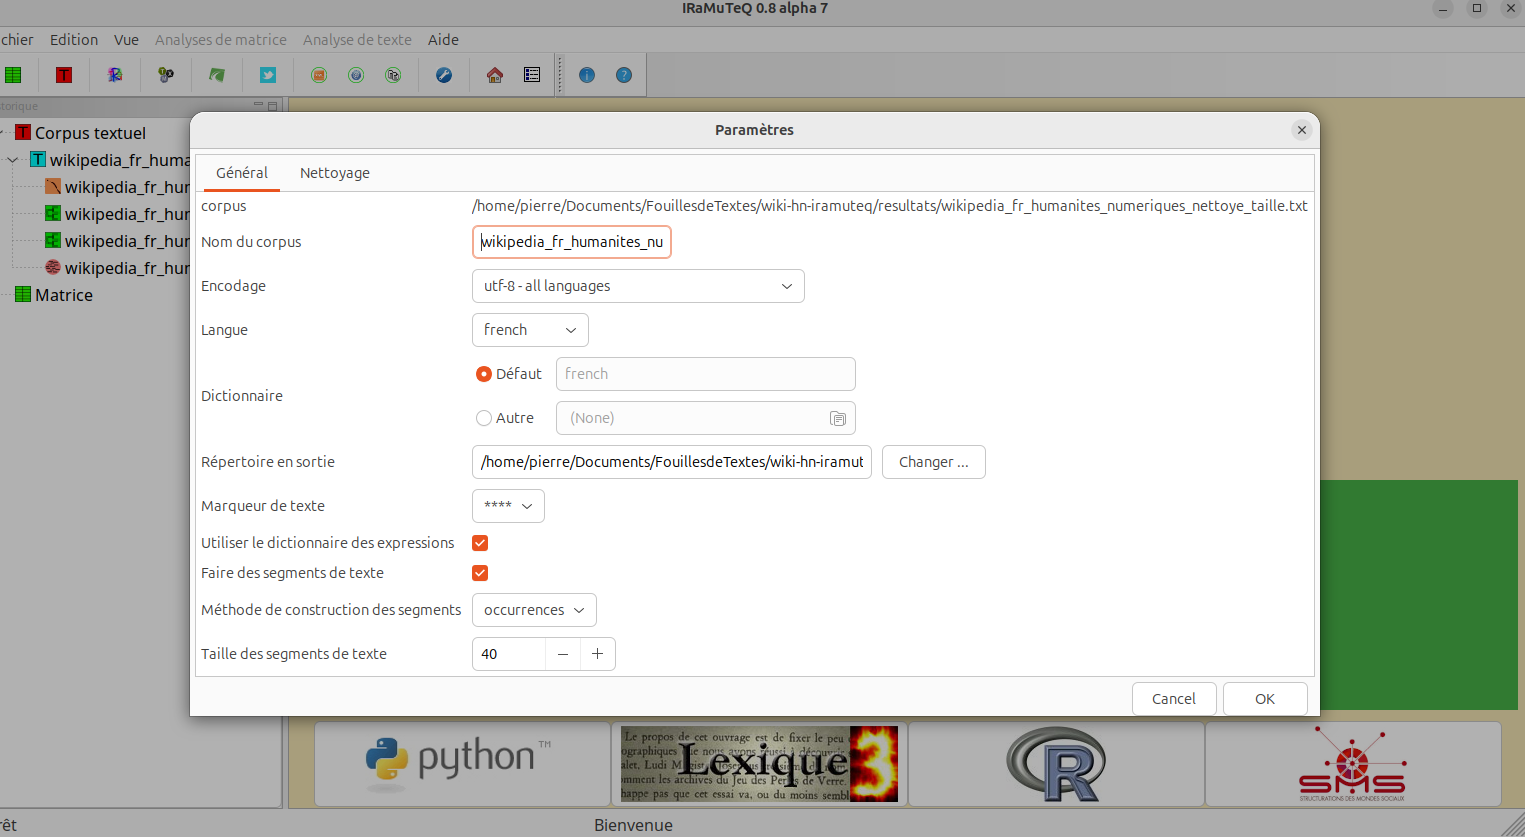
**** et taille des segments. La capture montre le corpus nettoyé ; les réglages sont les mêmes pour le corpus d’origine.Le premier réflexe est ensuite de lancer les statistiques (Analyse de texte → Statistiques) et de parcourir l’onglet Formes actives, en le triant par fréquence.
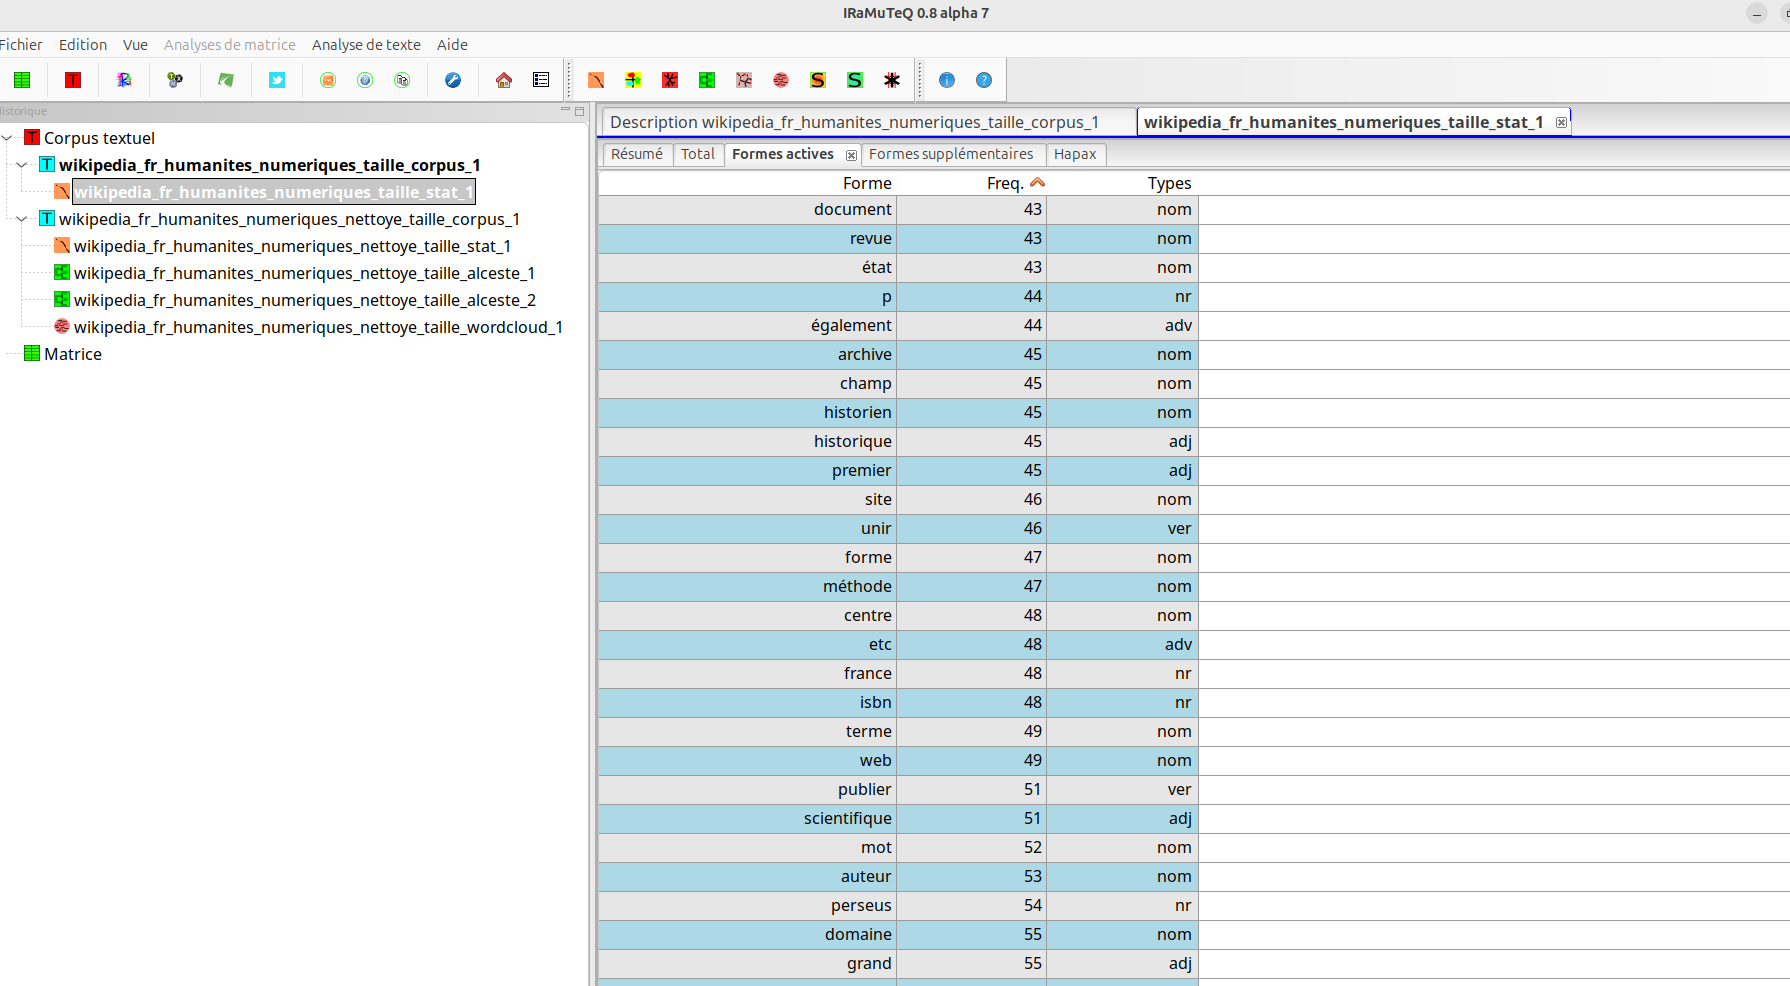
p (44), unir (46) et isbn (48) se glissent entre revue, champ et centre.C’est là que le corpus montre ses défauts. Parmi les formes fréquentes, on trouve :
isbn(48 occurrences) etp(44), ainsi que des numéros ISBN : ce sont les bibliographies des articles biographiques, qui listent les publications de chercheurs ;unir(46 occurrences), qui vient de États-Unis : le lemmatiseur coupe au trait d’union et ramène Unis au verbe unir ;marin, qui vient de Marin Dacos : le prénom devient un nom commun ;paripour Paris,sentirpour sens,approcherpour approche : des erreurs de lemmatisation, inévitables avec un dictionnaire sans contexte.
Rien de tout cela n’est dramatique pris isolément. Mais une classification de Reinert repose sur la cooccurrence des formes dans les segments : quelques dizaines de lignes de bibliographie suffisent à créer une classe artificielle, et un nom propre éclaté pollue deux mondes lexicaux à la fois. D’où un second script, nettoyer_corpus.py.
Le script de nettoyage
Il n’utilise que la bibliothèque standard de Python. Il prend en argument le corpus d’entrée et le corpus de sortie :
python3 nettoyer_corpus.py corpus/hn_fr/wikipedia_fr_humanites_numeriques.txt corpus/hn_fr/wikipedia_fr_humanites_numeriques_nettoye.txt
# -*- coding: utf-8 -*-
"""
nettoyer_corpus.py — Nettoie un corpus IRaMuTeQ issu de wiki2iramuteq
avant l'analyse.

Deux opérations :
1. supprimer les lignes de bibliographie (listes de publications des
   articles biographiques : ISBN, paginations « 368 p. ») ;
2. souder les noms composés et les noms de personnes avec un tiret bas,
   pour qu'IRaMuTeQ les traite comme une seule forme
   (« États-Unis » ne devient plus « unir », « Marin Dacos » ne donne
   plus le nom commun « marin »).

Usage :
    python3 nettoyer_corpus.py corpus/hn_fr/corpus.txt corpus/hn_fr/corpus_nettoye.txt

Licence du code : celle du dépôt. Textes : Wikipédia, CC BY-SA 4.0.
"""
# %% 1. Imports et arguments
import re
import sys
from pathlib import Path

if len(sys.argv) != 3:
    sys.exit("Usage : python3 nettoyer_corpus.py ENTREE.txt SORTIE.txt")

entree = Path(sys.argv[1])
sortie = Path(sys.argv[2])
lignes = entree.read_text(encoding="utf-8").splitlines()
print(f"{len(lignes)} lignes lues dans {entree}")
Repérer les lignes de bibliographie
Le bloc 2 définit ce qu’est une ligne de bibliographie. La règle est simple : une ligne qui contient « ISBN », ou une ligne courte qui contient à la fois une pagination (« 368 p. », « pp. 465-476 ») et une année.
# %% 2. Repérer les lignes de bibliographie
# Une ligne est considérée comme une référence bibliographique si :
# - elle contient « ISBN » ;
# - ou elle contient une pagination (« 368 p. », « pp.465-476 »)
#   ET une année (1800-2099), et reste courte (moins de 400 caractères).
# Les lignes d'en-tête IRaMuTeQ (« **** *art_... ») ne sont jamais touchées.

RE_ISBN = re.compile(r"\bISBN\b", re.IGNORECASE)
RE_PAGES = re.compile(r"\b\d{1,4}\s?p\.|\bpp\.\s?\d")
RE_ANNEE = re.compile(r"\b(18|19|20)\d{2}\b")


RE_PARENTHESES = re.compile(r"\([^()]*\)")


def ressemble_a_une_reference(texte: str) -> bool:
    return (
        bool(RE_PAGES.search(texte))
        and bool(RE_ANNEE.search(texte))
        and len(texte) < 400
    )


def est_bibliographique(ligne: str) -> bool:
    if ligne.startswith("****"):
        return False
    if RE_ISBN.search(ligne):
        return True
    if not ressemble_a_une_reference(ligne):
        return False
    # Cas d'une phrase de prose qui cite un ouvrage entre parenthèses :
    # si, une fois les parenthèses retirées, la ligne ne ressemble plus
    # à une référence, ce n'est pas une ligne de bibliographie.
    return ressemble_a_une_reference(RE_PARENTHESES.sub("", ligne))


def retirer_references_entre_parentheses(ligne: str) -> str:
    """Dans une ligne de prose, supprime les parenthèses qui contiennent
    une référence (année + pagination), et garde le reste."""
    def remplacer(m):
        return "" if ressemble_a_une_reference(m.group(0)) else m.group(0)
    return re.sub(r"\s?\([^()]*\)", remplacer, ligne)
La deuxième fonction, retirer_references_entre_parentheses, n’était pas dans la première version du script. Elle a été ajoutée après un faux positif : une phrase de prose de l’article consacré à Étienne Brunet citait un ouvrage entre parenthèses, avec son année et sa pagination. La règle la prenait pour une ligne de bibliographie et supprimait toute la phrase. Désormais, si la ligne ne ressemble plus à une référence une fois les parenthèses retirées, on garde la prose et on n’enlève que la référence.
C’est la leçon principale de cette étape : un nettoyage par règles se relit. C’est pourquoi le script écrit un journal de tout ce qu’il supprime.
Souder les noms composés
Le bloc 3 remplace les espaces et les traits d’union de quelques expressions par un tiret bas. IRaMuTeQ traite le tiret bas comme un caractère de mot : Marin_Dacos reste une seule forme, que le lemmatiseur ne reconnaît pas et laisse intacte. IRaMuTeQ procède d’ailleurs de la même façon avec son propre dictionnaire d’expressions : on voit passer c_est_à_dire ou baby_booms dans les segments.
# %% 3. Souder les expressions à garder en une seule forme
# IRaMuTeQ considère le tiret bas comme un caractère de mot :
# « Marin_Dacos » reste une seule forme, classée « nr » (non reconnue).
# La liste est volontairement courte : on ne soude que ce que les
# statistiques ont montré comme mal lemmatisé.

A_SOUDER = [
    "États-Unis",
    "Marin Dacos",
    "Pierre Mounier",
    "Damon Mayaffre",
    "Étienne Brunet",
    "Clarisse Bardiot",
    "Franco Moretti",
    "Roberto Busa",
]


def souder(ligne: str) -> str:
    for expr in A_SOUDER:
        soude = re.sub(r"[\s\-]+", "_", expr)
        ligne = re.sub(re.escape(expr), soude, ligne)
    return ligne
La liste est volontairement courte. On ne soude que ce que les statistiques ont montré comme mal traité. Allonger la liste au hasard, c’est décider à la place du corpus de ce qui fait une unité.
Appliquer, journaliser, recompter
Les blocs 4 et 5 appliquent les règles ligne par ligne et écrivent deux fichiers : le corpus nettoyé et le journal des lignes supprimées. Le bloc 6 recompte les mots de chaque article et réécrit le fichier de métadonnées, pour que decrire_corpus.py puisse ensuite travailler sur le texte réellement analysé.
# %% 4. Appliquer et compter
gardees, supprimees = [], []
article = None
par_article = {}

for ligne in lignes:
    if ligne.startswith("****"):
        article = ligne.split()[1] if len(ligne.split()) > 1 else ligne
        gardees.append(ligne)
        continue
    if est_bibliographique(ligne):
        supprimees.append(ligne)
        par_article[article] = par_article.get(article, 0) + 1
    else:
        gardees.append(souder(retirer_references_entre_parentheses(ligne)))
# %% 5. Écrire le corpus nettoyé et un journal des suppressions
sortie.write_text("\n".join(gardees) + "\n", encoding="utf-8")
journal = sortie.with_name(sortie.stem + "_lignes_supprimees.txt")
journal.write_text("\n".join(supprimees) + "\n", encoding="utf-8")
# %% 6. Écrire les métadonnées du corpus nettoyé
# decrire_corpus.py lit la longueur des articles dans la colonne « mots »
# du fichier <corpus>_metadonnees.csv. On recompte donc les mots de chaque
# article dans le texte nettoyé, pour que les terciles portent sur le texte
# réellement analysé. Le comptage (mots séparés par des espaces) est le même
# pour tous les articles, ce qui garde les longueurs comparables entre elles.
import csv

meta_entree = entree.with_name(entree.stem + "_metadonnees.csv")
meta_sortie = sortie.with_name(sortie.stem + "_metadonnees.csv")

mots_par_id, ident = {}, None
for ligne in gardees:
    if ligne.startswith("****"):
        ident = next((v[len("*id_"):] for v in ligne.split()
                      if v.startswith("*id_")), None)
        mots_par_id[ident] = 0
    elif ident is not None:
        mots_par_id[ident] += len(ligne.split())

if meta_entree.exists():
    with meta_entree.open(encoding="utf-8", newline="") as f:
        lecteur = csv.DictReader(f)
        champs = lecteur.fieldnames
        lignes_meta = list(lecteur)
    for m in lignes_meta:
        if m["id"] in mots_par_id:
            m["mots"] = mots_par_id[m["id"]]
    with meta_sortie.open("w", encoding="utf-8", newline="") as f:
        ecrivain = csv.DictWriter(f, fieldnames=champs)
        ecrivain.writeheader()
        ecrivain.writerows(lignes_meta)
    total = sum(mots_par_id.values())
    print(f"Métadonnées recalculées ({total} mots) : {meta_sortie}")
else:
    print(f"Attention : {meta_entree} introuvable, métadonnées non écrites.")

print(f"{len(supprimees)} lignes bibliographiques supprimées :")
for art, n in sorted(par_article.items(), key=lambda x: -x[1]):
    print(f"  {art} : {n}")
print(f"Corpus nettoyé : {sortie}")
print(f"Lignes supprimées (à relire) : {journal}")
Le bilan
Le script supprime 40 lignes, toutes dans quatre articles biographiques :
40 lignes bibliographiques supprimées :
  *art_Franco_Moretti : 15
  *art_Etienne_Brunet_linguiste : 13
  *art_Damon_Mayaffre : 7
  *art_Clarisse_Bardiot : 5
On relance ensuite decrire_corpus.py sur le corpus nettoyé :
python3 decrire_corpus.py corpus/hn_fr/wikipedia_fr_humanites_numeriques_nettoye.txt
| Corpus d’origine | Corpus nettoyé | |
|---|---|---|
| Mots (comptage du script) | 43 461 | 42 396 |
| Moyenne / médiane par article | 966 / 538 | 942 / 522 |
| Seuils des terciles | 360 et 832 mots | 360 et 791 mots |
| Occurrences (IRaMuTeQ) | 45 360 | 44 141 |
| Lemmes (IRaMuTeQ) | 5 607 | 5 401 |
Le seuil haut des terciles baisse de 832 à 791 mots : les biographies nettoyées ont raccourci, et certains articles changent de modalité de taille. C’est une bonne raison de nettoyer avant de construire les variables, et non l’inverse.
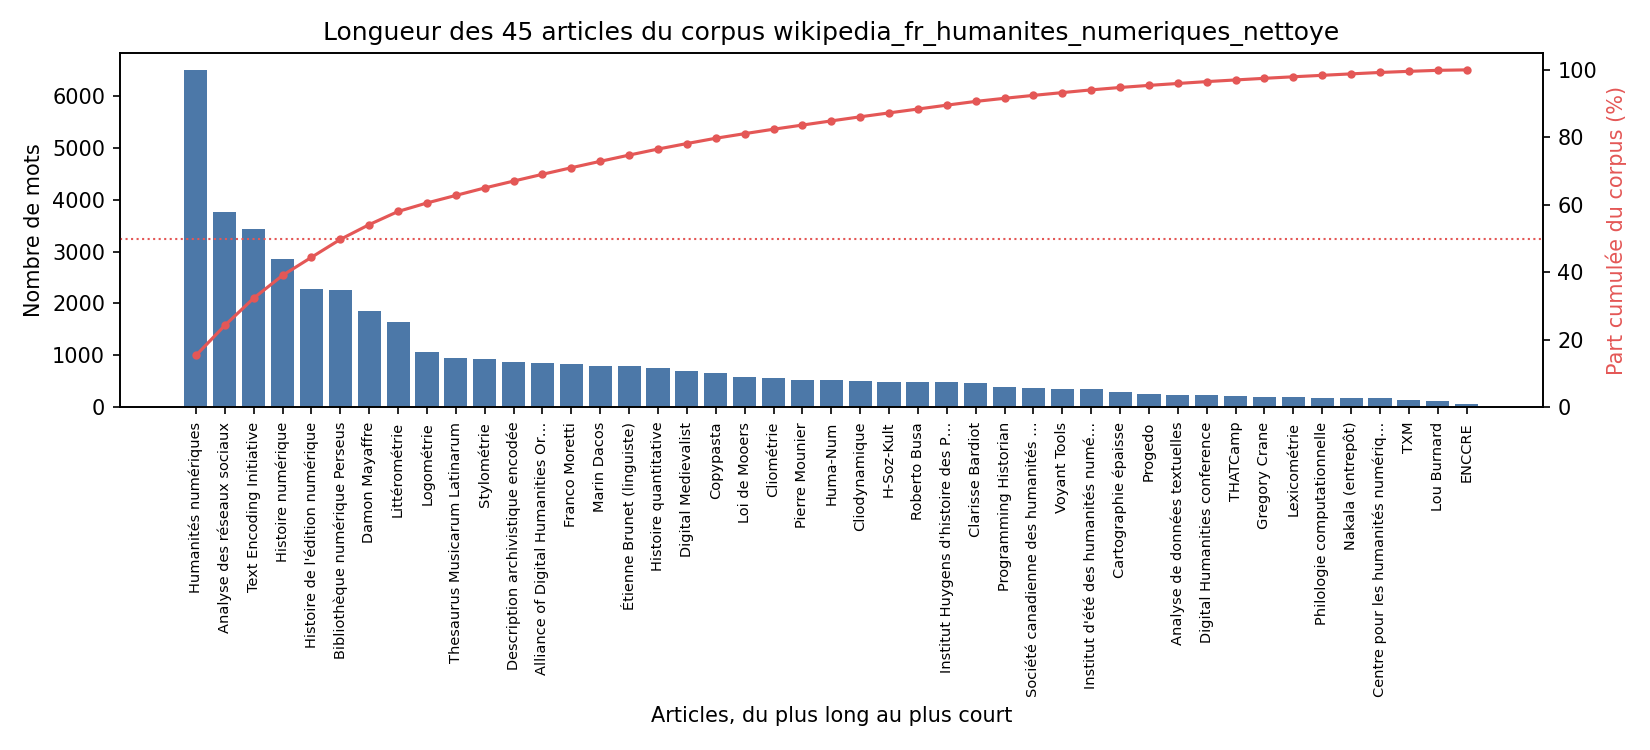
Tout n’est pas réglé :
- l’anglais (
the,of,for) résiste : il ne vient pas des bibliographies mais des noms d’institutions cités dans la prose (Alliance of Digital Humanities Organizations, Center for History and New Media…) ; - Royaume-Uni donne encore
royaumeetunir(10 occurrences chacun) : il n’était pas dans la liste ; parietsentirrestent, comme témoins des limites de la lemmatisation. Nous les retrouverons plus loin.
4. Le corpus nettoyé dans IRaMuTeQ
Les analyses ont été faites avec IRaMuTeQ 0.8 alpha 7, lancé depuis les sources sous Linux avec Python 3.12. Les statistiques du corpus nettoyé :
| Indicateur | Valeur |
|---|---|
| Textes | 45 |
| Segments de texte | 1 245 |
| Occurrences | 44 141 |
| Formes | 7 115 |
| Lemmes | 5 401 |
| Formes actives / supplémentaires | 4 916 / 485 |
| Formes actives de fréquence ≥ 3 | 1 604 |
| Moyenne par segment | 35,5 occurrences |
L’onglet Résumé de l’analyse Statistiques donne l’essentiel, avec le diagramme de Zipf.
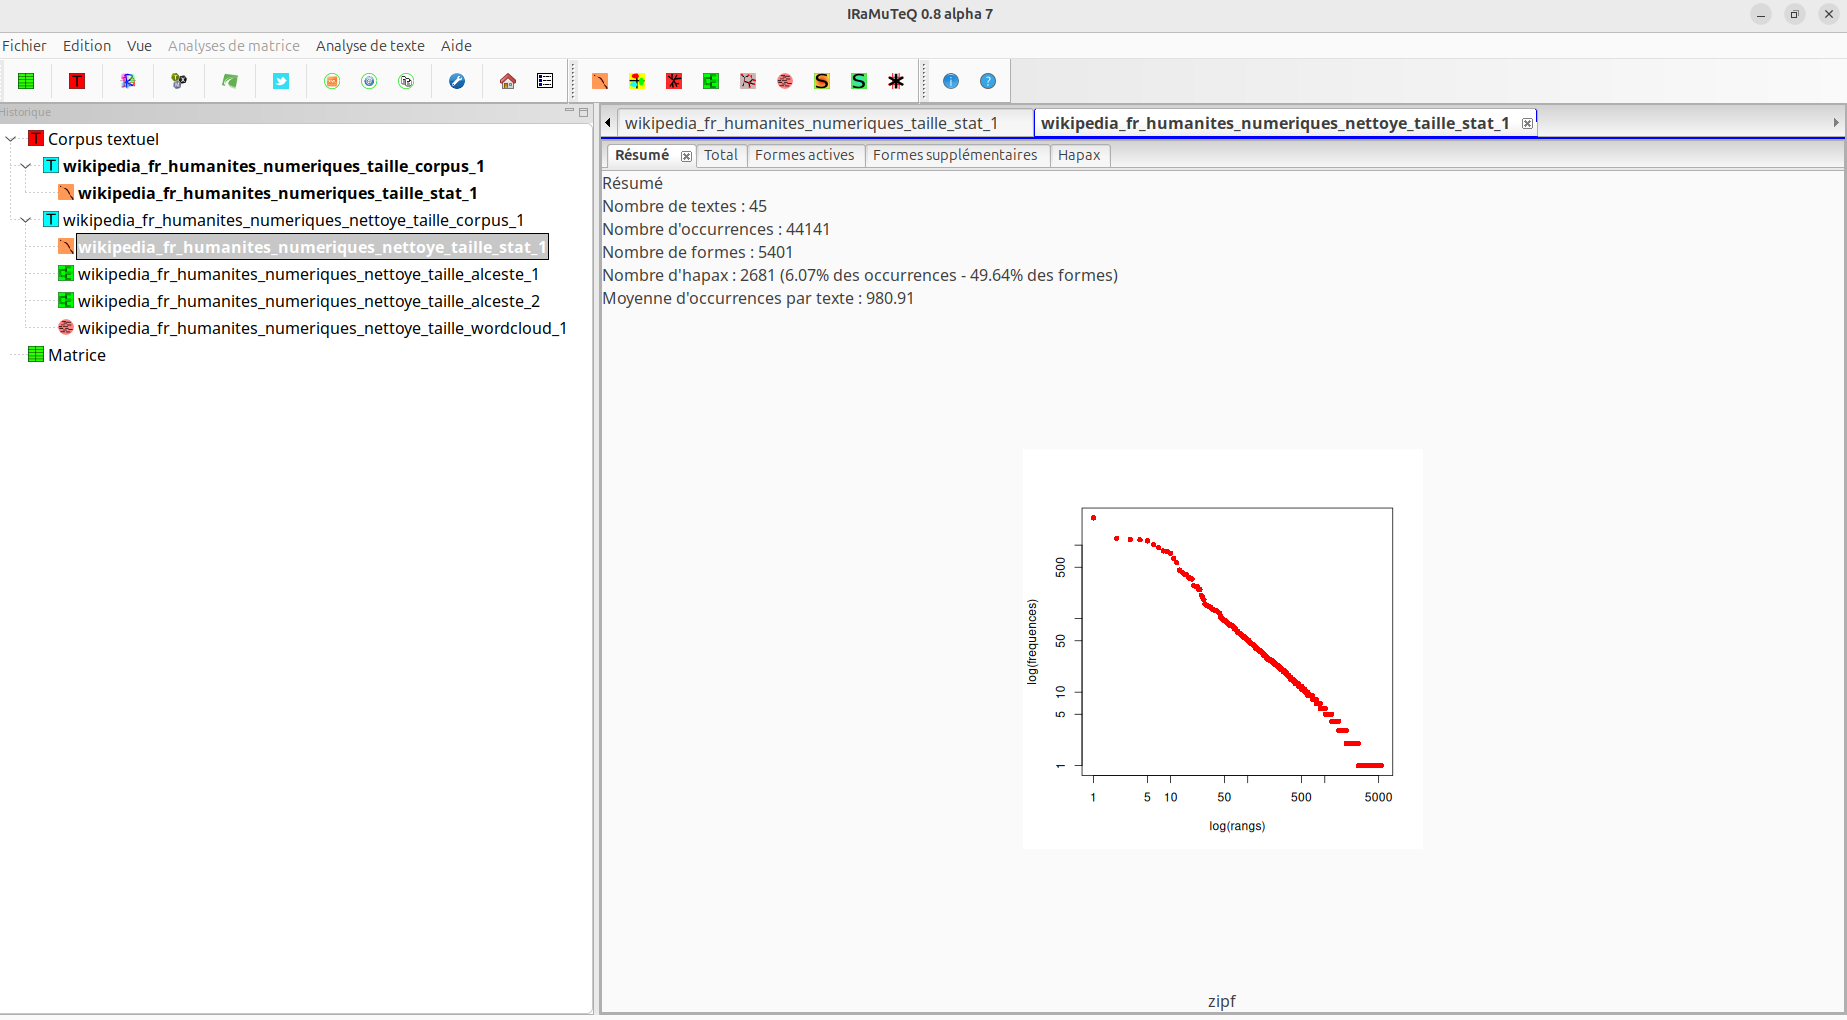
Près de la moitié des formes (2 681 sur 5 401) sont des hapax : elles n’apparaissent qu’une fois. Elles ne pèsent pourtant que 6 % des occurrences. C’est normal pour un corpus de cette taille, et cela explique pourquoi la classification ne retient que les formes d’une fréquence minimale. Le diagramme de Zipf (rang en abscisse, fréquence en ordonnée, en échelles logarithmiques) donne une droite régulière, sans rupture : pas d’anomalie massive restante.
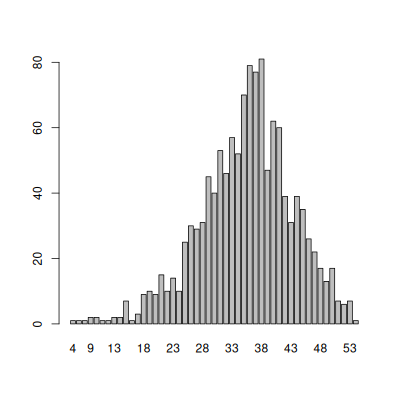
IRaMuTeQ trace aussi la distribution de la taille des segments. Elle est centrée autour de 35 à 40 occurrences, comme demandé. Les quelques segments très courts, à gauche, correspondent à des fins de paragraphe ou à des articles minuscules comme ENCCRE.
Enfin, le nuage de mots (Analyse de texte → Nuage de mots) donne une vue d’ensemble du vocabulaire.
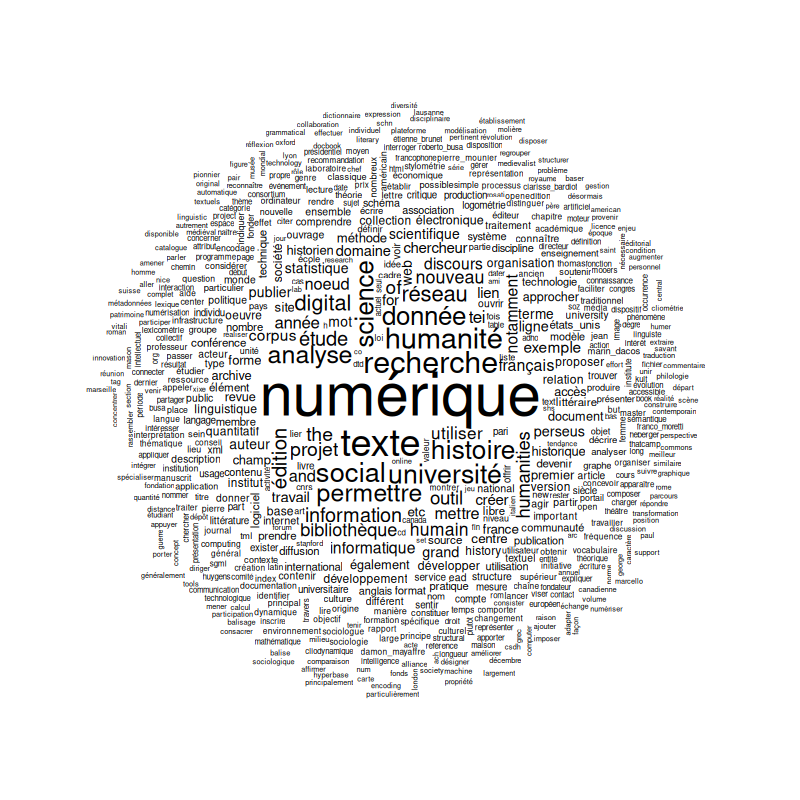
Sans surprise, numérique domine, suivi de texte, recherche, humanité, histoire et donnée. Deux détails méritent l’attention. D’abord, la lemmatisation met tout au singulier : humanités devient humanité, ce qui brouille un peu le nom de la discipline. Ensuite, des formes comme réseau, social et noeud sont déjà bien visibles : c’est le poids d’un seul article, Analyse des réseaux sociaux, que la classification va confirmer. Un nuage de mots se lit vite, mais il ne dit rien de la façon dont les mots s’associent : c’est le rôle de la classification.
5. La classification de Reinert
Le principe en quelques lignes
La méthode a été proposée par Max Reinert au début des années 1980 et popularisée par le logiciel Alceste ; IRaMuTeQ en propose une implémentation libre. Elle procède ainsi :
- le corpus est découpé en segments de texte ;
- on construit un tableau croisant segments et formes (présence ou absence de chaque forme dans chaque segment) ;
- ce tableau est coupé en deux, de façon à ce que les deux groupes aient le vocabulaire le plus différent possible ;
- on recommence sur le plus gros des groupes restants, jusqu’au nombre de classes demandé.
Chaque classe obtenue est un monde lexical : un ensemble de segments qui partagent le même vocabulaire. Le logiciel ne sait rien des thèmes : c’est au lecteur de nommer les classes, à partir des formes caractéristiques et des segments.
Les paramètres
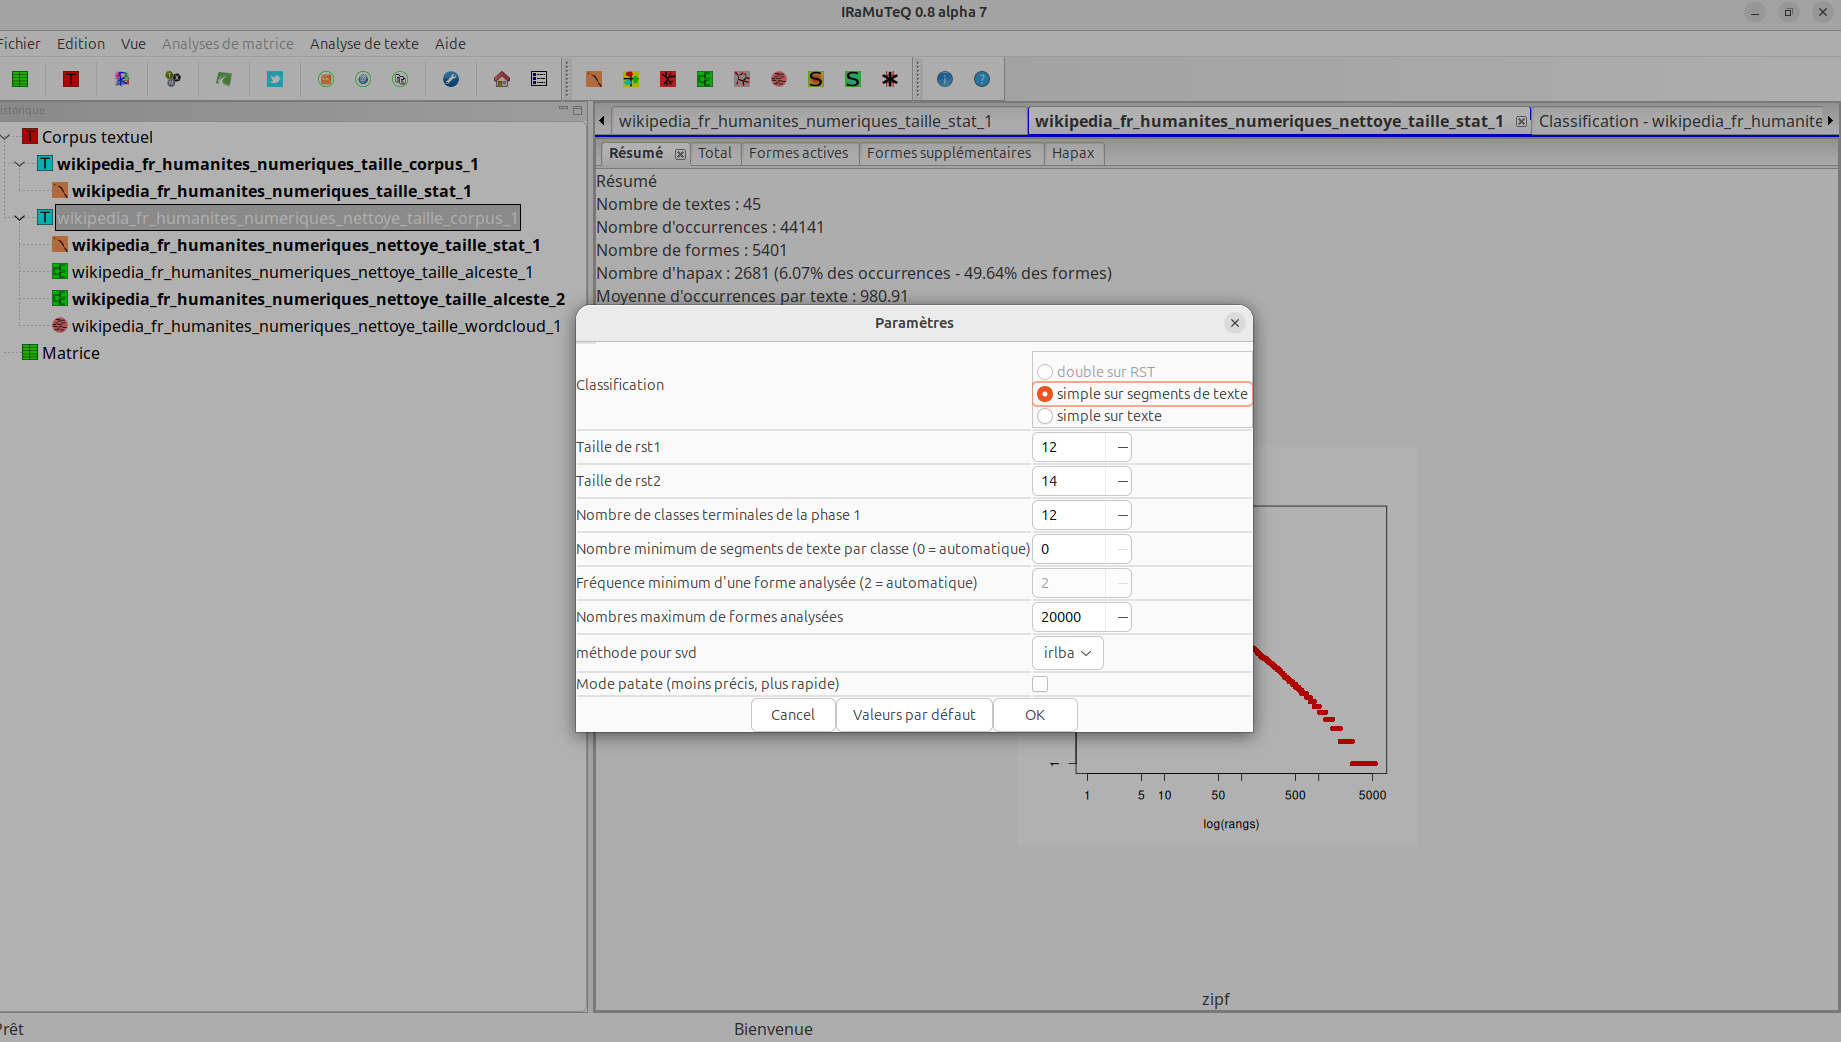
La classification se lance par Analyse de texte → Classification → Méthode Reinert. La lemmatisation est activée, et la taille des segments (40 occurrences) a été fixée à l’ouverture du corpus. Dans la fenêtre de paramètres, nous avons gardé les valeurs par défaut, sauf le nombre de classes terminales :
- une classification simple sur segments de texte ;
- des tailles de regroupement (rst1 et rst2) de 12 et 14, qui ne servent que pour la classification double ;
- 12 classes terminales pour la phase 1 (10 dans le premier calcul) ;
- une fréquence minimale des formes fixée automatiquement : IRaMuTeQ l’a mise à 3, ce qui donne 1 604 formes actives analysées. Le plafond de 20 000 formes n’est donc pas atteint.
De 6 à 8 classes
Un premier calcul avec 10 classes terminales a donné 6 classes, et classé 81,5 % des segments. Le nombre de classes terminales n’est en effet pas le nombre de classes final : IRaMuTeQ ne garde que les classes stables, qui résistent à la phase de consolidation.
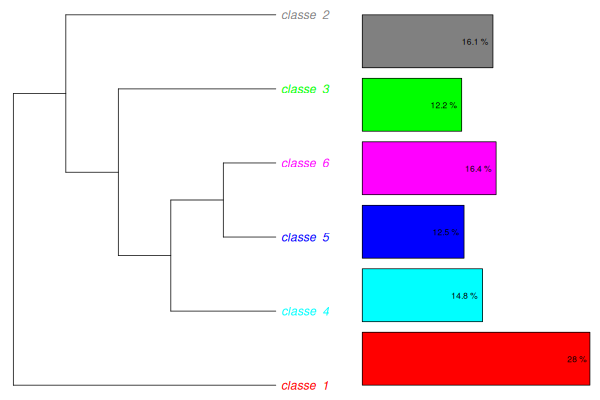
Dans ce premier calcul, la classe 1 regroupe le vocabulaire des institutions (université, centre, conférence, mais aussi of, the, digital), et la classe 6 celui des outils.
En vérifiant les classes article par article, un problème est apparu : l’article Analyse des réseaux sociaux, deuxième plus long du corpus, n’avait que 13 segments classés sur plus d’une centaine. Son vocabulaire (nœuds, graphes, liens) ne ressemblait à rien d’autre, et il disparaissait presque entièrement des résultats.
Un second calcul avec 12 classes terminales a donné 8 classes, et classé 88 % des segments (1 095 sur 1 245). L’article sur les réseaux sociaux y forme sa propre classe. Point rassurant : les classes 2 à 5 ont exactement les mêmes effectifs dans les deux calculs. Ce sont des mondes lexicaux robustes, qui ne dépendent pas du paramétrage. C’est ce second calcul qui est commenté ici.
L’arbre complet de la classification montre ce qui s’est passé. Sur les 12 classes terminales, quatre sont notées 0 : elles n’ont pas été retenues, et leurs segments sont restés non classés. Les huit autres ont été renumérotées de 1 à 8.
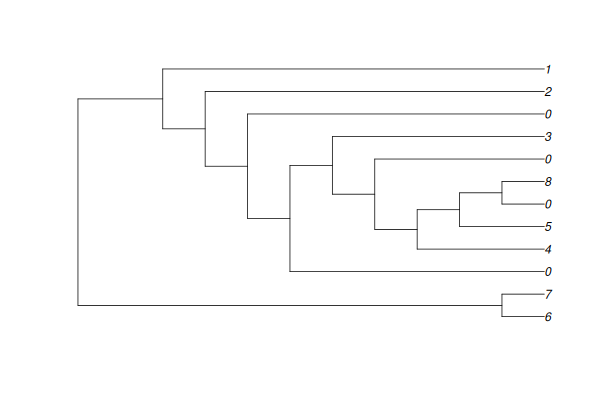
En passant de 6 à 8 classes, l’ancienne classe des institutions s’est scindée en deux (institutions françaises, institutions anglophones), et l’analyse des réseaux sociaux a gagné sa classe. Les classes de textométrie, de bibliothèques numériques, d’histoire quantitative et d’édition n’ont pas bougé.
Le dendrogramme
L’onglet CHD des résultats rappelle les chiffres du corpus et le taux de segments classés, puis affiche le dendrogramme. Les onglets Profils et AFC donnent respectivement les formes caractéristiques de chaque classe et les plans factoriels que nous verrons plus loin.
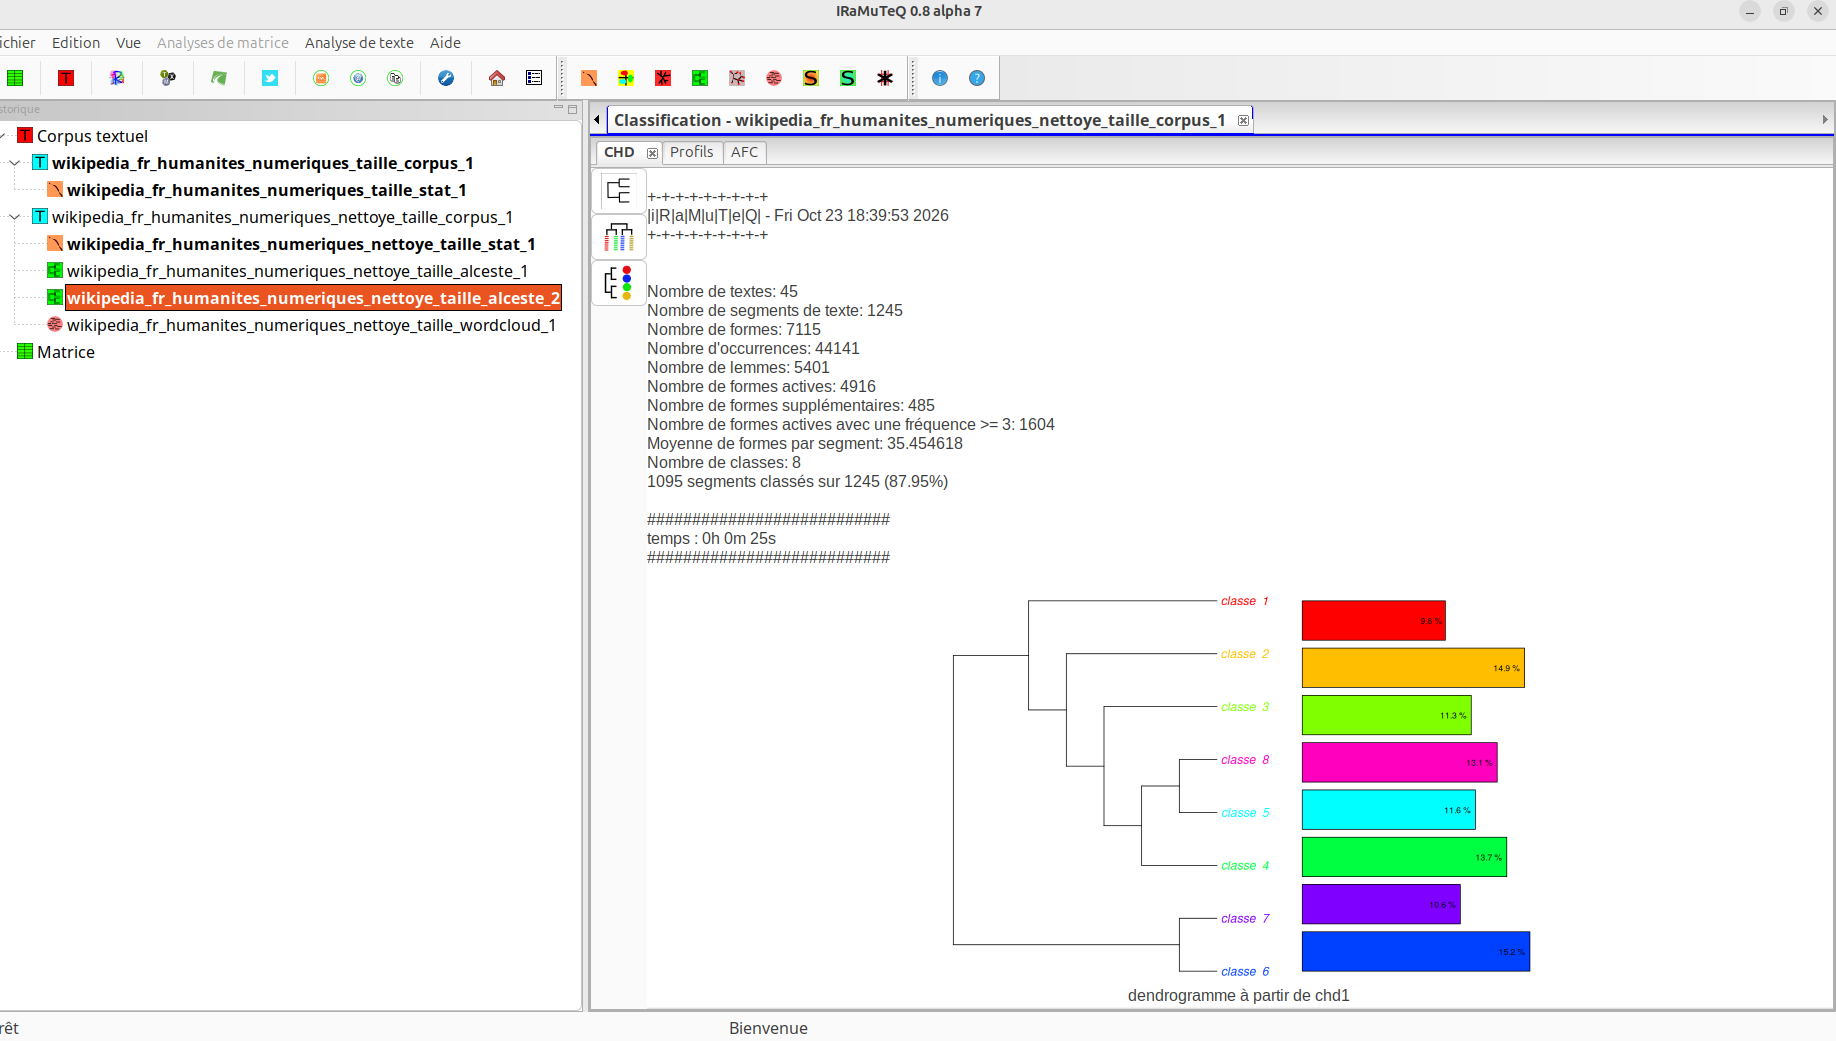
Le dendrogramme se lit de gauche à droite. La première partition isole les classes 6 et 7 du reste du corpus : les noms d’institutions, français d’un côté, anglophones de l’autre. La classe 1 (réseaux sociaux) se détache ensuite, puis la classe 2 (textométrie), puis la classe 3 (bibliothèques numériques). Les classes 4, 5 et 8 forment le dernier bloc, le plus homogène.
Les 8 classes
Le tableau donne pour chaque classe son poids, le nom que nous lui avons donné, ses formes les plus caractéristiques (par χ² décroissant) et les articles qui y contribuent le plus.
| Classe | Poids | Nom proposé | Formes caractéristiques | Articles principaux |
|---|---|---|---|---|
| 1 | 9,6 % | Analyse des réseaux sociaux | nœud, réseau, relation, graphe, individu, lien, structural, Granovetter, Burt | Analyse des réseaux sociaux (99 segments sur 112) |
| 2 | 14,9 % | Textométrie et logométrie | discours, logométrie, corpus, linguistique, mot, politique, damon_mayaffre, présidentiel | Damon Mayaffre, Logométrie, Littérométrie, Étienne Brunet, Roberto Busa, Stylométrie |
| 3 | 11,3 % | Bibliothèques numériques, patrimoine et copie | perseus, bibliothèque, site, latin, collection, commentaire, grec, version, cd, rom | Bibliothèque numérique Perseus, Thesaurus Musicarum Latinarum, Copypasta |
| 4 | 13,7 % | Histoire quantitative | quantitatif, histoire, année, économique, historique, évolution, démographique, cliodynamique | Humanités numériques, Histoire quantitative, Histoire numérique, Cliométrie, Cliodynamique |
| 5 | 11,6 % | Édition et légitimation | diffusion, édition, traditionnel, académique, légitimation, production, papier, éditorial | Humanités numériques, Histoire de l’édition numérique |
| 6 | 15,2 % | Institutions françaises | université, marin_dacos, pari, supérieur, centre, pierre_mounier, électronique, openedition | Humanités numériques, Marin Dacos, Pierre Mounier, Digital Medievalist, H-Soz-Kult |
| 7 | 10,6 % | Institutions anglophones | the, of, for, humanities, and, digital, history, university, center | Histoire numérique, Alliance of Digital Humanities Organizations, Humanités numériques, Société canadienne des humanités numériques |
| 8 | 13,1 % | Outils et infrastructures | outil, donnée, technologie, tools, utiliser, interroger, informatique, application | Humanités numériques, Histoire numérique, Voyant Tools |
Vérifier les classes article par article
Les formes caractéristiques ne suffisent pas. Une classe peut être portée par un seul article : elle décrit alors cet article, pas un thème du corpus. Pour le vérifier, on croise la classe de chaque segment (fichier uce.csv du dossier de résultats) avec l’article dont il provient (base corpus.db). Quelques lignes du tableau obtenu :
| Article | Segments | Répartition dans les classes |
|---|---|---|
| Humanités numériques | 188 | 8 : 53, 5 : 41, 4 : 33, 6 : 29, 7 : 12, autres : 15, non classés : 5 |
| Analyse des réseaux sociaux | 112 | 1 : 99, autres : 13 |
| Text Encoding Initiative | 99 | non classés : 70, 5 : 9, 8 : 7, 7 : 6, autres : 7 |
| Histoire numérique | 83 | 7 : 25, 8 : 20, 4 : 17, 6 : 10, autres : 9, non classés : 2 |
| Bibliothèque numérique Perseus | 66 | 3 : 48, autres : 13, non classés : 5 |
| Damon Mayaffre | 52 | 2 : 43, autres : 8, non classé : 1 |
IRaMuTeQ permet aussi de le voir directement : le plan factoriel des variables étoilées place chaque article selon les classes où tombent ses segments, dans la couleur de la classe à laquelle il est le plus associé.
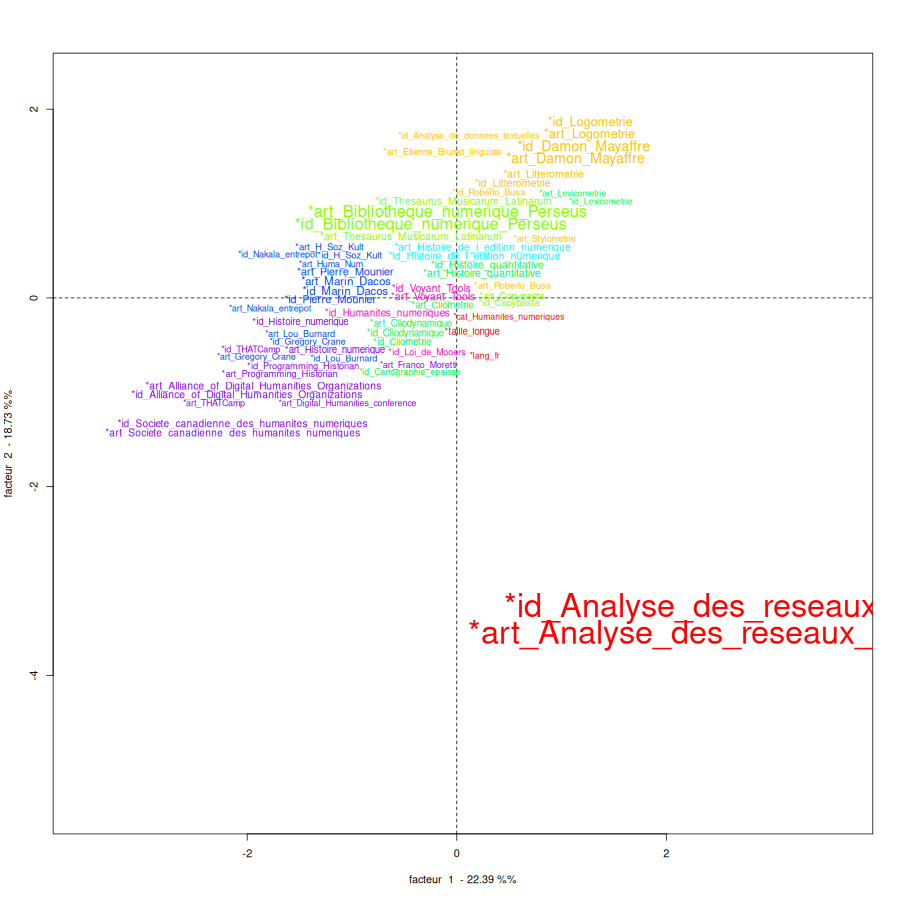
L’article Analyse des réseaux sociaux, en bas à droite, est à lui seul un pôle du plan. Chaque article y figure deux fois, sous *art_ et sous *id_, car wiki2iramuteq produit ces deux variables avec la même valeur : c’est sans conséquence, mais cela charge le graphique.
L’article généraliste Humanités numériques se répartit dans cinq classes : c’est normal, il fait le tour de la discipline. À l’inverse, Analyse des réseaux sociaux tient presque tout entier dans la classe 1, et Perseus fournit à lui seul 48 des 124 segments de la classe 3.
Lire les segments
Dernière vérification, et la plus importante : lire les segments. Pour chaque classe, nous avons retenu les six segments les plus caractéristiques, calculés en additionnant les χ² des formes de la classe qu’ils contiennent. Ils sont réunis dans le fichier resultats/segments_caracteristiques.md du dépôt. Trois exemples, tels que segmentés par IRaMuTeQ (en minuscules et sans ponctuation) :
- classe 4, Histoire quantitative : « l histoire quantitative débute avec fernand braudel dans les années 1950 cet historien a amené les thématiques économiques et sociales dans la discipline historique » ;
- classe 5, Histoire de l’édition numérique : « les trois grandes fonctions de l édition production diffusion et légitimation peuvent maintenant être prises en charge par d autres entités que les maisons d édition » ;
- classe 7, Histoire numérique : « virginia center for digital history à la university of virginia aux états_unis institute for advanced technology in the humanities à la university of virginia aux états_unis ».
Le troisième exemple montre déjà la limite de la classe 7 : ce n’est pas un discours sur les institutions, c’est une liste.
Le plan factoriel
IRaMuTeQ réalise ensuite une analyse factorielle des correspondances (AFC) sur le tableau croisant formes et classes. Le plus simple est de commencer par la position des classes seules.
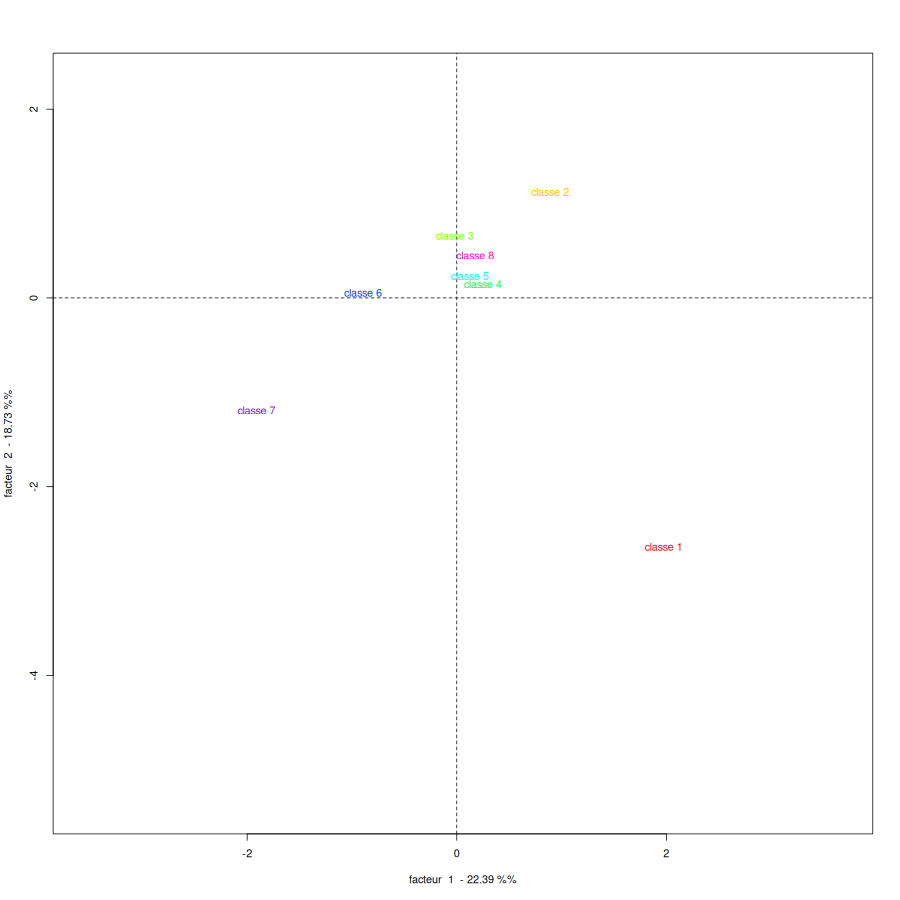
Les classes 7 et 1 sont aux extrémités, la classe 2 en haut à droite, la classe 6 à gauche. Les classes 3, 4, 5 et 8 sont regroupées près de l’origine. On projette ensuite les formes caractéristiques sur le même plan.
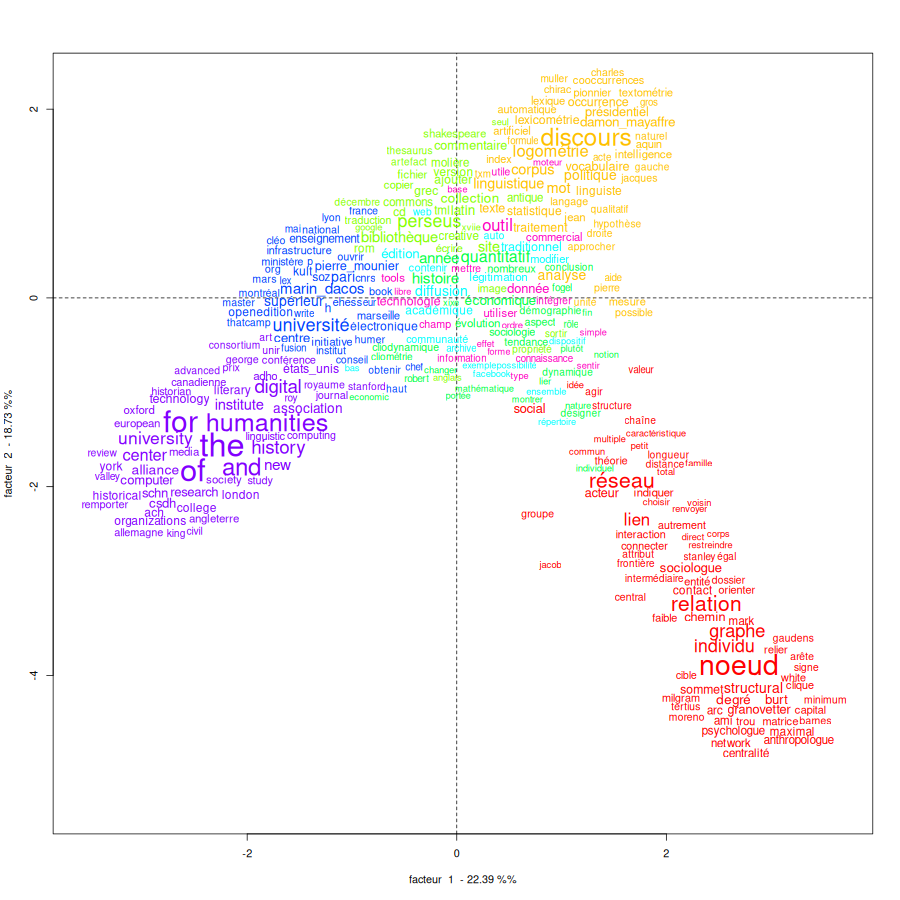
Le facteur 1 (22,4 %) oppose les institutions, à gauche (classes 6 et 7), aux réseaux sociaux, à droite (classe 1). Le facteur 2 (18,7 %) oppose les réseaux sociaux, en bas, à la textométrie, en haut (classe 2). Le plan a donc trois pôles nets. Les classes 3, 4, 5 et 8 se chevauchent au centre : elles partagent un vocabulaire commun (histoire, édition, numérique, données) et se distinguent moins nettement qu’on pourrait le croire en lisant le dendrogramme.
Le même plan existe pour les formes supplémentaires, c’est-à-dire les mots-outils et les nombres, qui n’ont pas servi à construire les classes.
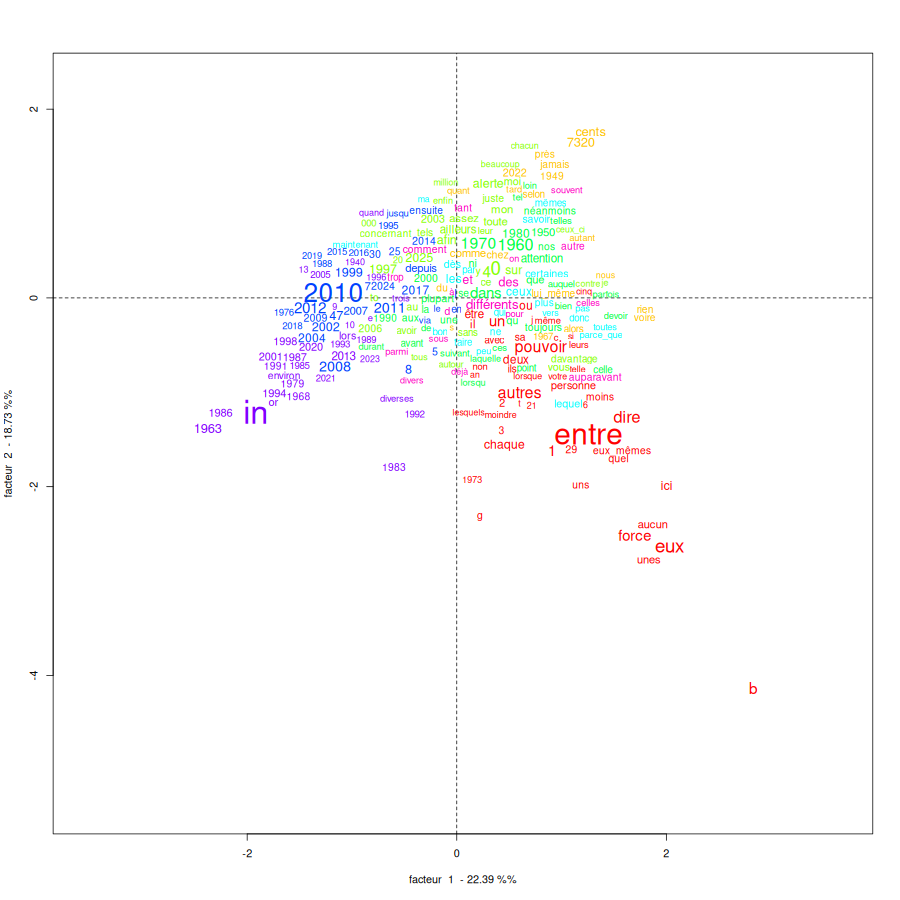
Il confirme la lecture précédente par d’autres indices. Les dates récentes (2002, 2008, 2010, 2012…) se concentrent du côté des institutions : ce sont les années de création des centres, des revues et des associations. La préposition anglaise in signe la classe 7. Du côté de la classe 1, ce sont des mots comme entre, eux ou chaque, qui servent à décrire des relations.
Croiser avec la taille des articles
C’est le moment de se servir de la variable *taille_. IRaMuTeQ calcule pour chaque classe le χ² d’association avec chaque modalité. Pour le calcul à 8 classes :
| Classe | Modalité associée | χ² |
|---|---|---|
| 1. Réseaux sociaux | longue | 37,5 |
| 2. Textométrie | longue | 10,8 |
| 3. Bibliothèques numériques | longue | 6,8 |
| 4. Histoire quantitative | moyenne | 13,7 |
| 5. Édition | longue | 3,7 |
| 6. Institutions françaises | moyenne, courte | 35,1 et 18,8 |
| 7. Institutions anglophones | moyenne, courte | 4,8 et 3,2 |
| 8. Outils | courte | 2,5 |
Avec un degré de liberté, un χ² supérieur à 3,84 correspond au seuil de 5 %. Les classes 1, 2 et 3 sont portées par des articles longs : ce sont en partie des effets de volume. La classe 6, au contraire, est fortement associée aux articles moyens et courts : les petites notices sur des institutions, des personnes et des événements (H-Soz-Kult, Progedo, THATCamp, Marin Dacos…) parlent toutes le même langage administratif. Sans la variable de taille, on aurait pu prendre la classe 1 pour un grand thème du corpus. Elle n’est en réalité que l’empreinte d’un seul long article.
6. Lecture critique des résultats
Une classification de Reinert produit toujours des classes. La question est de savoir ce qu’elles représentent. Plusieurs d’entre elles demandent de la prudence.
Des classes monographiques
Trois classes reposent largement sur un seul article : la classe 1 sur Analyse des réseaux sociaux, la classe 3 sur Perseus, et dans une moindre mesure la classe 2 sur Damon Mayaffre (43 segments sur 163). Ce ne sont pas des erreurs : un article long et techniquement homogène forme naturellement un monde lexical. Mais elles décrivent des articles, pas des courants partagés par le corpus.
Des artefacts de format
La classe 7 est d’abord une classe de langue. Ses formes les plus caractéristiques sont the, of et for : elle réunit les segments où les noms d’institutions anglophones s’accumulent. Ses meilleurs segments viennent de l’énumération des centres de recherche de l’article Histoire numérique, une liste et non un discours. La classe 6 contient de son côté un reste de bibliographie que le nettoyage n’a pas attrapé : le segment 968, une liste de publications de Marin Dacos et Pierre Mounier sans ISBN ni pagination. La forme d’un texte (liste, bibliographie, tableau) peut peser autant que son contenu.
Le bruit de Copypasta
L’article Copypasta, sur le copier-coller comme phénomène d’Internet, est classé dans la catégorie « Humanités numériques ». Dix de ses dix-neuf segments rejoignent la classe 3, avec les bibliothèques numériques : le vocabulaire de la copie, des versions et des ajouts y rapproche un mème d’Internet des éditions de textes antiques. La classification fait son travail sur les mots ; c’est la catégorie de Wikipédia qui est hétérogène.
La TEI invisible
Sur 150 segments non classés, 70 viennent de l’article Text Encoding Initiative, 17 de Description archivistique encodée et 14 de Loi de Mooers. L’encodage XML forme bien un monde lexical (balises, schémas, éléments, attributs), mais trop concentré dans deux articles pour donner une classe stable. Résultat paradoxal : la TEI, l’un des piliers des humanités numériques, disparaît de la classification. Une absence dans les classes ne veut pas dire une absence dans le corpus : il faut toujours regarder ce qui n’est pas classé.
Les limites de la lemmatisation
La forme pari est la troisième forme caractéristique de la classe 6. Elle ne parle pas de paris, mais des universités Paris 8, 10 et 12. Le nettoyage ne corrige que ce qu’on lui a signalé ; le reste passe dans les résultats. sentir (pour sens) apparaît aussi sur le plan factoriel, du côté des réseaux sociaux. Il faut garder le texte sous les yeux pour interpréter une forme.
Une catégorie sans ses sous-catégories
Le corpus ne contient que les articles classés directement dans la catégorie (*prof_0). Les sous-catégories de Wikipédia, et les articles qu’elles contiennent, n’ont pas été suivies. L’image obtenue est donc celle de la catégorie racine, avec ses choix éditoriaux : on y trouve Copypasta mais pas forcément tel outil ou tel projet rangé ailleurs. wiki2iramuteq permet de descendre dans l’arborescence ; ce serait une autre analyse.
Une mise en abyme
La classe 2, la plus lourde après les institutions françaises, rassemble les articles sur la textométrie, la logométrie et la littérométrie, autrement dit sur les méthodes qu’emploie IRaMuTeQ. L’outil retrouve dans le corpus la description de sa propre démarche. Et la forme damon_mayaffre y figure parmi les plus caractéristiques : un nom propre que nous avons nous-mêmes soudé au nettoyage devient l’un des marqueurs du monde lexical de la statistique textuelle. Le chercheur dont l’article décrit l’analyse de discours politiques par la statistique se retrouve ainsi à la place de mot-clé dans une analyse statistique.
Conclusion
Sur ce corpus de 45 articles, la classification de Reinert dessine trois pôles : les institutions, françaises et anglophones, la statistique textuelle et un bloc méthodologique plus diffus (histoire quantitative, édition, outils). Elle isole aussi des articles atypiques, comme celui sur l’analyse des réseaux sociaux.
Mais la principale leçon tient dans la méthode :
- décrire le corpus avant de l’analyser, pour savoir quels articles pèsent ;
- nettoyer en partant de ce que montrent les statistiques, et relire ce qu’on supprime ;
- vérifier chaque classe article par article et lire ses segments ;
- regarder ce qui n’est pas classé.
Sans ces vérifications, on aurait conclu que l’analyse des réseaux sociaux est un grand thème des humanités numériques sur Wikipédia, et oublié la TEI.
Le code, les corpus et les résultats d’IRaMuTeQ sont dans le dépôt Anakeyn/wiki-hn-iramuteq. Les deux scripts fonctionnent avec n’importe quel corpus produit par wiki2iramuteq : il suffit de leur donner le chemin du fichier .txt.
Licences et crédits
- Code : GPL-3.0-or-later.
- Textes et extraits : Wikipédia, sous licence CC BY-SA 4.0, par les contributeurs et contributrices de Wikipédia. Le fichier de métadonnées donne l’URL et le numéro de révision de chaque article.
- Logiciel : IRaMuTeQ, de Pierre Ratinaud, logiciel libre.
Pour aller plus loin
- Reinert M., « Une méthode de classification descendante hiérarchique : application à l’analyse lexicale par contexte », Les Cahiers de l’analyse des données, 8(2), 1983, p. 187-198.
- Le site d’IRaMuTeQ et sa documentation.
- Le billet précédent : Créer des corpus IRaMuTeQ à partir de Wikipédia avec Python : wiki2iramuteq.