Partager la publication "Transformation d’un dictionnaire de Breton Apertium utilisable par Iramuteq"
IRaMuTeQ ne fournit pas de dictionnaire pour le breton. Cet article montre comment en construire un, libre et reproductible, à partir du dictionnaire morphologique d’Apertium : plus de 250 000 formes rattachées à près de 12 000 lemmes, qui couvrent près de 99 % des occurrences du corpus de test.
Pourquoi est-ce important ? Sans dictionnaire, IRaMuTeQ compte les formes telles qu’elles apparaissent dans le texte. En breton, den (une personne), tud (des gens) et dud (dans an dud, « les gens ») deviennent alors trois mots sans rapport. Les mutations consonantiques, les verbes conjugués et les prépositions conjuguées dispersent ainsi un même mot sous des dizaines de formes. La classification de Reinert, l’analyse des similitudes ou le nuage de mots perdent alors une bonne partie de leur sens.
Un dictionnaire de lemmatisation résout ce problème : il indique, pour chaque forme, le mot de base (le lemme) et sa catégorie grammaticale. Avec lui, tud, dud et zud sont tous ramenés à den. dud vient d’une mutation douce (t → d), par exemple après l’article dans an dud. zud vient d’une mutation spirante (t → z), par exemple après le possessif dans ma zud, « mes parents ».
Cet article est le troisième d’une série consacrée à IRaMuTeQ et aux humanités numériques. Le premier montrait comment constituer des corpus à partir de Wikipédia, en français et en breton. Le deuxième, « Les humanités numériques vues par Wikipédia », décrivait et analysait avec IRaMuTeQ les articles de la catégorie Humanités numériques de Wikipédia en français. Le dictionnaire présenté ici permettra, dans un prochain article, de faire le même travail en breton et de comparer les sujets traités par les deux Wikipédia.
Tout le travail est publié dans le dépôt GitHub Apertium2iramuteq-breton. Vous pouvez donc utiliser le dictionnaire sans lire le code : passez directement aux sections « Préparer ses textes » et « Installer le dictionnaire ». Les autres sections expliquent, pas à pas et code à l’appui, comment il a été construit.
Ce qu’est un dictionnaire pour IRaMuTeQ
Un dictionnaire IRaMuTeQ est un simple fichier texte en UTF-8, avec une ligne par forme et trois colonnes séparées par une tabulation : la forme, son lemme, sa catégorie. Voici quelques lignes extraites du dictionnaire breton :
den	den	nom
tud	den	nom
dud	den	nom
graet	ober	ver
ran	ober	ver
eo	bezañ	aux
gantañ	gant	pre
ar	an	art_def
Le fichier n’a pas de ligne d’en-tête : chaque ligne se lit « forme, lemme, catégorie ».
La catégorie compte autant que le lemme. IRaMuTeQ s’en sert pour séparer les formes actives, qui portent le sens (noms, verbes, adjectifs, adverbes), des formes supplémentaires, les mots-outils (articles, prépositions, conjonctions, pronoms, auxiliaires). Par défaut, seules les formes actives entrent dans les analyses. Il faut donc reprendre exactement les étiquettes qu’IRaMuTeQ utilise pour le français : nom, ver, aux, adj, adv, pre, con, art_def, pro_per, adj_pos…
Deux contraintes d’IRaMuTeQ vont guider toute la construction :
- Une seule analyse par forme. Le fichier ne peut pas dire « si gant est soit la préposition, soit un nombre muté ». Il faut choisir.
- Une seule catégorie par lemme. Un même lemme ne peut pas être à la fois nom et verbe.
La source : le dictionnaire morphologique d’Apertium
Apertium est une plateforme libre de traduction automatique à base de règles. Pour traduire, elle doit d’abord analyser chaque mot : retrouver son lemme et ses traits grammaticaux. Elle s’appuie pour cela sur un dictionnaire morphologique par langue.
Pour le breton, ce dictionnaire est apertium-bre, développé par Francis Tyers, Fulup Jakez et Gwenvael Jekel avec le soutien de l’Ofis ar Brezhoneg. Il sert notamment au traducteur breton–français. C’est une ressource rare : libre (licence GPL 3), riche, et qui traite déjà les mutations.
Qu’est-ce qu’un dictionnaire morphologique ?
Un dictionnaire morphologique décrit la forme des mots : comment chaque mot se décline, se conjugue ou se modifie, et à quel mot de base chaque forme se rattache. Un dictionnaire ordinaire, lui, donne surtout le sens.
Pour chaque forme écrite, il donne :
- le lemme, c’est-à-dire la forme de base ;
- les traits grammaticaux : catégorie, genre, nombre, temps, personne…
Voici quelques analyses produites par le dictionnaire breton d’Apertium :
| Forme écrite | Analyse Apertium | Lecture |
|---|---|---|
| tud | den<n><m><pl> |
den, nom, masculin, pluriel |
| dud | den<n><m><pl> |
la même analyse : dud est la forme mutée de tud |
| graet | ober<vblex><pp> |
ober (faire), verbe, participe passé : « fait » |
| gantañ | gant<pr>+indirect<prn><obj><p3><m><sg> |
gant, préposition, conjuguée à la 3ᵉ personne du masculin singulier |
La mutation n’apparaît pas dans l’analyse : tud et dud reçoivent exactement la même. C’est la structure du dictionnaire qui l’encode, comme on va le voir.
Ce dictionnaire ne contient pas toutes ces formes une par une. Il est construit comme une grammaire :
- chaque mot est inscrit une seule fois, avec sa racine ;
- il est rattaché à un modèle de flexion. La flexion, c’est la variation de forme d’un mot selon son rôle dans la phrase : conjugaison pour les verbes, pluriel ou accord pour les noms et les adjectifs. Un modèle de flexion décrit ces variations une fois pour toutes, comme les tableaux de conjugaison d’un Bescherelle : pour conjuguer danser, on applique à la racine dans- les terminaisons du modèle chanter ;
- pour le breton, s’ajoutent les modèles de mutation (k → g → c’h, t → d → z…).
C’est pourquoi notre script expanseur_dix.py doit « déplier » le fichier : il combine chaque racine avec ses modèles pour produire toutes les formes réelles. On passe ainsi de près de 12 000 lemmes à plus de 250 000 formes dans lexique_br.txt.
C’est exactement l’information qu’il faut à IRaMuTeQ pour lemmatiser : retrouver den derrière tud et dud, ou ober derrière graet. Le dictionnaire morphologique sert de base au lexique, qui n’en garde que le lemme et la catégorie, au format d’IRaMuTeQ.
Le format .dix
Le dictionnaire est un fichier XML, apertium-bre.bre.dix. Il ne liste pas toutes les formes : il les décrit par paradigmes (pardef), des modèles de flexion réutilisables. Le terme vient de la grammaire : un paradigme est le tableau des formes d’un mot qui sert de modèle à tous les mots qui varient de la même façon. C’est le rôle de « chanter » pour les verbes du premier groupe dans un Bescherelle. Dans Apertium, un paradigme liste des terminaisons (ou des initiales) et l’analyse grammaticale qui va avec chacune. Chaque mot n’a plus qu’à donner sa racine et le nom de son paradigme : les terminaisons ne sont écrites qu’une fois, pour tous les mots qui les partagent. Voici l’entrée du mot den :
<e lm="den"><par n="initial-d"/><i/><par n="d/en__n"/></e>
Elle se lit comme un assemblage de trois morceaux : une initiale décrite par le paradigme initial-d, une partie invariable (ici vide, <i/>), puis une terminaison décrite par le paradigme d/en__n. Voici ces deux paradigmes :
<pardef n="initial-d">
  <e r="LR"><p><l>d</l><r>d</r></p></e>
  <e r="LR"><p><l>z</l><r>d</r></p></e>
  <e r="LR"><p><l>t</l><r>d</r></p></e>
  <e r="RL"><p><l><a/>d</l><r>d</r></p></e>
</pardef>

<pardef n="d/en__n">
  <e><p><l>en</l><r>en<s n="n"/><s n="m"/><s n="sg"/></r></p></e>
  <e><p><l>ud</l><r>en<s n="n"/><s n="m"/><s n="pl"/></r></p></e>
</pardef>
Dans chaque paire <p>, <l> (left) donne ce qu’on lit dans le texte et <r> (right) l’analyse. Les balises <s n="…"/> sont les étiquettes grammaticales : n pour nom, m pour masculin, sg et pl pour singulier et pluriel.
Le nom d’un paradigme suit une convention : d/en__n se lit « sur le modèle de d|en, nom ». La barre oblique sépare la racine de la terminaison du mot modèle, et ce qui suit __ donne la catégorie. Tout nom qui varie comme den se rattache à ce paradigme, en ne donnant que sa propre racine.
Le paradigme initial-d encode les mutations : dans un texte, l’initiale d peut apparaître comme d, z ou t, mais l’analyse rétablit toujours d. L’attribut r="LR" signifie que l’entrée ne sert qu’à l’analyse (de gauche à droite) ; r="RL" qu’elle ne sert qu’à la génération.
En combinant les trois initiales et les deux terminaisons, on obtient six formes : den, zen, ten (singulier) et dud, zud, tud (pluriel), toutes rattachées au lemme den. C’est exactement ce dont IRaMuTeQ a besoin, à condition de « déplier » tout le dictionnaire.
Le fichier compte 472 paradigmes et 22 438 entrées. Le dépôt apertium-br-fr, celui du traducteur, apporte en plus un petit corpus annoté et vérifié à la main, qui servira à trancher certaines ambiguïtés.
Étape 1 : déplier le dictionnaire en formes fléchies
Le premier script, expanseur_dix.py, transforme les paradigmes en une liste de couples (forme, analyse). Apertium fournit pour cela la commande lt-expand, mais elle suppose d’installer et de compiler Apertium, ce qui n’est pas simple sous Windows. Nous avons donc écrit un équivalent simplifié en Python pur, qui ne dépend que de la bibliothèque standard.
Charger le fichier et indexer les paradigmes
import itertools
import xml.etree.ElementTree as ET

LIMITE_PAR_ENTREE = 20000   # garde-fou contre une explosion combinatoire


class Expanseur:
    def __init__(self, chemin):
        self.racine = ET.parse(chemin).getroot()
        self.pardefs = {p.get("n"): p for p in self.racine.find("pardefs")}
        self._cache = {}
On lit le XML avec ElementTree, puis on range les paradigmes dans un dictionnaire Python, indexé par leur nom. Le cache évitera de redéplier cent fois un paradigme partagé par des centaines de mots.
Lire le contenu d’une balise
Un <l> ou un <r> contient du texte, mais aussi des balises : <s> pour les étiquettes, <b/> pour une espace, <j/> pour une jonction, <g> pour la partie invariable d’une locution. La méthode _texte les convertit en chaîne, différemment selon le côté :
    @staticmethod
    def _texte(el, cote):
        """cote = 'l' (surface) ou 'r' (analyse)."""
        morceaux = [el.text or ""]
        for enfant in el:
            t = enfant.tag
            if t == "s":
                morceaux.append(f"<{enfant.get('n')}>" if cote == "r" else "")
            elif t == "b":
                morceaux.append(" ")
            elif t == "j":
                morceaux.append("+")
            elif t == "g":
                interne = Expanseur._texte(enfant, cote)
                morceaux.append(("#" + interne + "#") if cote == "r" else interne)
            elif t == "a":
                pass
            morceaux.append(enfant.tail or "")
        return "".join(morceaux)
Côté analyse, l’étiquette <s n="pl"/> devient <pl> ; côté surface, elle disparaît. On obtient ainsi des analyses au format habituel d’Apertium, comme den<n><m><pl>.
Déplier une entrée : un produit cartésien
C’est le cœur du script. Une entrée est une suite de morceaux ; chaque morceau propose une ou plusieurs variantes. Toutes les formes possibles s’obtiennent en prenant une variante dans chaque morceau, de toutes les façons possibles : c’est ce qu’on appelle le produit cartésien des variantes.
L’image la plus simple est celle d’un menu. Avec 3 entrées et 2 plats, on peut composer 3 × 2 = 6 repas différents : chaque entrée avec chaque plat. Le produit cartésien est la liste de ces 6 combinaisons, et leur nombre est le produit des nombres de choix. Pour den, les « entrées » sont les trois initiales (d, z, t) et les « plats » les deux terminaisons (en, ud).
En Python, la fonction itertools.product calcule ce produit directement :
    def _entree(self, e):
        if e.get("r") == "RL":
            return []
        parties = []
        for el in e:
            t = el.tag
            if t == "p":
                parties.append([(self._texte(el.find("l"), "l"),
                                 self._texte(el.find("r"), "r"))])
            elif t == "i":
                txt_l = self._texte(el, "l")
                txt_r = self._texte(el, "r")
                parties.append([(txt_l, txt_r)])
            elif t == "par":
                parties.append(self.pardef(el.get("n")))
            elif t == "re":
                return []           # expressions régulières (nombres) : ignorées
        resultats = []
        for combo in itertools.product(*parties):
            resultats.append(("".join(c[0] for c in combo),
                              "".join(c[1] for c in combo)))
            if len(resultats) > LIMITE_PAR_ENTREE:
                break
        return resultats
Pour den, parties contient trois listes : les trois initiales (d, z, t), la partie invariable vide, puis les deux terminaisons (en, ud). Le produit donne 3 × 1 × 2 = 6 formes. Les entrées r="RL" sont écartées, puisqu’elles ne servent qu’à générer du texte. Les entrées r="LR" sont gardées : ce sont justement les variantes de lecture, mutations comprises.
Déplier un paradigme, puis tout le dictionnaire
    def pardef(self, nom):
        if nom not in self._cache:
            self._cache[nom] = []   # protège d'une éventuelle récursion
            res = []
            for e in self.pardefs[nom]:
                res.extend(self._entree(e))
            self._cache[nom] = res
        return self._cache[nom]

    def developper(self, sections=None):
        """Renvoie un itérable de (surface, analyse, id_section)."""
        for sec in self.racine.iter("section"):
            if sections and sec.get("id") not in sections:
                continue
            for e in sec:
                if e.tag != "e":
                    continue
                for gauche, droite in self._entree(e):
                    yield gauche, droite, sec.get("id")
Un paradigme peut lui-même appeler d’autres paradigmes : pardef et _entree s’appellent donc mutuellement. developper est un générateur : il produit les couples un à un, sans tout garder en mémoire.
Sur apertium-bre, on obtient 401 657 couples (forme, analyse). Voici les premiers pour den :
den   den<n><m><sg>
dud   den<n><m><pl>
zen   den<n><m><sg>
zud   den<n><m><pl>
ten   den<n><m><sg>
tud   den<n><m><pl>
nen   den<n><m><sg>
La septième forme, nen, vient d’une entrée à part qui décrit une mutation ancienne.
Découper une analyse
Il reste une petite fonction utilitaire, qui sépare le lemme des étiquettes :
def decouper_analyse(droite):
    """'den<n><m><pl>' -> ('den', ['n','m','pl']) ; gère '#' et '+'."""
    premier = droite.split("+")[0]
    queue = ""
    if "#" in premier:
        morceaux = premier.split("#")
        premier = morceaux[0] + "".join(morceaux[2::2])
        queue = "".join(morceaux[1::2])
    if "<" in premier:
        lemme = premier[:premier.index("<")]
        etiquettes = premier[premier.index("<") + 1:-1].split("><")
    else:
        lemme, etiquettes = premier, []
    return (lemme + queue).strip(), etiquettes
Pour une forme composée (+), on ne garde que la première analyse. Pour une locution, la partie invariable entre # est recollée au lemme.
Étape 2 : des étiquettes d’Apertium aux catégories d’IRaMuTeQ
Le second script, construire_lexique_br.py, fait tout le reste. Il commence par traduire les étiquettes d’Apertium dans le vocabulaire d’IRaMuTeQ. Le tableau résume les correspondances principales :
| Étiquette Apertium | Sens | Catégorie IRaMuTeQ |
|---|---|---|
n |
nom | nom |
vblex |
verbe | ver (ou aux pour bezañ, kaout, endevout) |
vbloc |
verbe de localisation (emañ) | aux |
adj |
adjectif | adj |
adv, preadv |
adverbe | adv (ou adv_sup pour la négation) |
pr |
préposition | pre |
cnjcoo, cnjsub, cnjadv |
conjonction | con |
det + def / ind / pos / dem |
déterminant | art_def, art_ind, adj_pos, adj_dem |
prn + subj / obj / ref |
pronom personnel | pro_per |
vpart |
particule verbale (a, e, ez, o) | adv_sup |
num |
nombre | adj_num |
ij |
interjection | ono |
np |
nom propre | aucune : non retenu |
En code, cela donne une fonction faite d’une suite de tests :
AUXILIAIRES = {"bezañ", "kaout", "endevout"}


def categorie(etiquettes, lemme, pro_per=True):
    if not etiquettes:
        return None
    t = etiquettes[0]
    s = set(etiquettes[1:])
    if t == "n":
        return "nom"
    if t in ("vblex",):
        return "aux" if lemme in AUXILIAIRES else "ver"
    if t == "vbloc":
        return "aux"
    if t == "adj":
        return "adj"
    if t in ("adv", "preadv"):
        return "adv_sup" if "neg" in s else "adv"
    if t == "pr":
        return "pre"
    if t in ("cnjcoo", "cnjsub", "cnjadv"):
        return "con"
    if t == "det":
        if "def" in s:
            return "art_def"
        if "ind" in s:
            return "art_ind"
        if "pos" in s:
            return "adj_pos"
        if "dem" in s:
            return "adj_dem"
        if "itg" in s:
            return "adj_int"
        return "adj_ind"
    if t == "predet":
        return "adj_ind"
    if t == "num":
        return "adj_num"
    if t == "prn":
        if "dem" in s:
            return "pro_dem"
        if "rel" in s:
            return "pro_rel"
        if "pos" in s:
            return "pro_pos"
        if s & {"subj", "obj", "ref"} and pro_per:
            return "pro_per"
        return "pro_ind"
    if t == "vpart":
        return "adv_sup"           # particules verbales a, e, ez, o
    if t == "ij":
        return "ono"
    return None                    # np, abbr, sym, ponctuation…
Trois choix méritent une explication.
- Les auxiliaires. bezañ (être) et kaout (avoir) sont classés
aux, comme être et avoir dans le dictionnaire français d’IRaMuTeQ. Toutes leurs formes conjuguées sont concernées : eo, emañ, zo, oa, bet… sont rattachés à bezañ. Ils deviennent ainsi supplémentaires : sans cela, eo (est) et zo domineraient toutes les analyses. - Les particules verbales a, e, ez, o sont de petits mots placés devant le verbe. Elles ne se traduisent pas : elles indiquent la construction de la phrase, et entraînent souvent une mutation du verbe qui suit. Nous les rangeons en
adv_sup, une catégorie de mots-outils, pour qu’elles ne pèsent pas dans les classifications.
- a suit le sujet ou le complément placé en tête : Ni a ro al laezh da Vari, « Nous donnons le lait à Marie ».
- e suit un autre élément en tête, comme un adverbe : Warc’hoazh e teuin, « Demain je viendrai » (dont, venir, devient teuin).
- ez remplace e devant une voyelle : Amañ ez eus, « Ici il y a ».
- o se place devant l’infinitif pour dire « en train de » : o tañsal, « en train de danser » (de dañsal).
- Les noms propres sont écartés, comme dans le dictionnaire français : IRaMuTeQ les laisse alors en « non reconnus » (
nr), et on peut décider de les garder ou non dans l’analyse.
La fonction renvoie None pour tout le reste ; ces formes ne seront pas écrites dans le dictionnaire.
Étape 3 : normaliser les formes, et le problème du c’h
IRaMuTeQ découpe les textes en mots à chaque apostrophe, comme il le fait en français pour l’homme ou qu’il. En breton, c’est un piège : le trigramme c’h est une lettre à part entière. c’hoari (jouer) serait coupé en c et hoari, et merc’h (fille) en merc et h.
La solution retenue consiste à remplacer l’apostrophe du c’h par un tiret bas, que IRaMuTeQ considère comme une lettre : c_hoari, merc_h. Il faut l’appliquer de la même façon au dictionnaire et aux textes, quelle que soit l’apostrophe employée (droite, typographique ou lettre modificative ʼ, celle qu’utilise Apertium).
import re

APOSTROPHES = "'’ʼ‘`"


def normaliser(mot):
    """minuscules, c'h -> c_h, apostrophes isolées retirées."""
    m = mot.lower()
    m = re.sub(r"c[" + APOSTROPHES + r"]h", "c_h", m)
    m = re.sub(r"[" + APOSTROPHES + r"]", "", m)
    return m.strip()
Tout est aussi passé en minuscules : IRaMuTeQ compare les formes en minuscules.
Rassembler toutes les analyses de chaque forme
La boucle principale parcourt les 401 657 couples produits par l’expanseur, c’est-à-dire par le script de l’étape 1 qui a déplié les paradigmes d’Apertium : chaque couple associe une forme telle qu’on la lit dans un texte (tud) à son analyse (den<n><m><pl>). Pour chaque forme normalisée, la boucle note toutes les analyses possibles, avec deux indicateurs qui serviront à trancher : la forme est-elle mutée ? vient-elle d’une forme composée ?
    analyses = collections.defaultdict(set)   # forme -> {(lemme, cat, mutée, composée)}
    morceaux = collections.defaultdict(collections.Counter)
    for surface, analyse, _ in Expanseur(a.dix).developper():
        if not surface.strip():
            continue
        lemme_brut, etiq = decouper_analyse(analyse)
        cat = categorie(etiq, lemme_brut, not a.sans_pro_per)
        if not cat:
            continue
        lemme_brut = lemme_brut.replace(" ", "_")      # « memes tra » -> memes_tra
        if " " in surface.strip():
            # « en doa », « hon doa » (kaout) : on garde le dernier mot
            if "#" not in analyse and cat in ("aux", "ver"):
                morceaux[normaliser(surface.split()[-1])][(normaliser(lemme_brut), cat)] += 1
            continue                       # autres locutions : ignorées
        if "-" in surface and cat in ("pre", "adv", "con"):
            # « a-raok », « war-lerc'h », « e-kichen » : dernier élément
            morceaux[normaliser(surface.split("-")[-1])][(normaliser(lemme_brut), cat)] += 1
        forme, lemme = normaliser(surface), normaliser(lemme_brut)
        if (not forme or not re.fullmatch(r"[a-zà-ÿœæ_\-]+", forme)
                or not re.fullmatch(r"[a-zà-ÿœæ_\-]+", lemme)):
            continue
        mutee = forme[:1] != lemme[:1] and not forme.startswith(lemme[:2])
        composee = "+" in analyse
        analyses[forme].add((lemme, cat, mutee, composee))
Quelques points de détail :
- Une forme est considérée comme mutée quand sa première lettre diffère de celle du lemme : tud face à den, graet face à ober. C’est une approximation commode : elle range aussi parmi les « mutées » les formes supplétives comme graet, mais cela ne gêne pas le classement qui suit.
- Les locutions de plusieurs mots (den kozh, « vieillard ») sont écartées : IRaMuTeQ découpe le texte en mots isolés et ne les verrait jamais. On garde seulement, à part, leur dernier mot quand c’est utile (doa dans en doa, « il avait »), ainsi que le dernier élément des prépositions à trait d’union (raok dans a-raok, « avant »). L’étape 5 en reparle.
- Les formes qui contiennent autre chose que des lettres (chiffres, symboles) sont ignorées.
Étape 4 : une seule analyse par forme
Un analyseur comme Apertium peut proposer plusieurs analyses pour une même forme, puis choisir selon le contexte. Un dictionnaire IRaMuTeQ ne le peut pas : chaque forme reçoit une analyse et une seule. Or 12 084 formes bretonnes ont plusieurs analyses possibles.
L’exemple type est gant. Ce peut être la préposition gant (« avec »), ou le nombre kant (« cent ») après mutation douce, quand le k devient g. Dans un texte, c’est presque toujours la préposition.
L’ordre de préférence
Le script trie les analyses candidates de chaque forme selon une suite de critères, du plus important au moins important :
- la lecture sans mutation d’abord ;
- puis la forme simple plutôt que la forme composée ;
- puis la catégorie habituelle du lemme ;
- puis le mot-outil plutôt que le mot plein ;
- puis, à égalité, l’ordre alphabétique, pour que le résultat soit toujours le même.
Le quatrième critère s’appuie sur un rang par catégorie : plus le nombre est petit, plus la catégorie est préférée.
PLEINS = {"nom", "ver", "adj", "adv"}

# rang : plus petit = préféré en cas d'ambiguïté
RANG = {"pre": 0, "art_def": 0, "art_ind": 0, "con": 1, "pro_per": 1,
        "pro_dem": 1, "pro_rel": 1, "pro_pos": 1, "pro_ind": 1,
        "adj_pos": 1, "adj_dem": 1, "adj_int": 1, "adj_ind": 1,
        "adv_sup": 2, "aux": 2, "nom": 3, "ver": 4, "adj": 5, "adv": 6,
        "adj_num": 7, "ono": 8}


def majoritaire(compteur):
    """Élément le plus fréquent, départage stable (résultat reproductible)."""
    return max(compteur.items(), key=lambda kv: (kv[1], str(kv[0])))[0]
Pourquoi favoriser les mots-outils ? Parce qu’ils sont très fréquents : une erreur sur une préposition se répète des centaines de fois dans un corpus, une erreur sur un nom rare quelques fois seulement.
La catégorie habituelle d’un lemme
Apertium admet parfois qu’un verbe soit employé comme nom : ober (faire) est aussi « le faire ». Pour éviter qu’une forme de ober soit rangée parmi les noms, on calcule d’abord la catégorie dominante de chaque lemme, en comptant ses formes non mutées :
    dominante = collections.defaultdict(collections.Counter)
    for forme, ens in analyses.items():
        for lemme, cat, mutee, composee in ens:
            if not mutee and not composee:
                dominante[lemme][cat] += 1
    dominante = {l: majoritaire(c) for l, c in dominante.items()}
Le tri, et le recours au corpus annoté
Le choix lui-même tient en un sorted dont la clé reprend les critères ci-dessus, dans l’ordre :
    choix = {}
    for forme, ens in analyses.items():
        candidats = sorted(ens, key=lambda x: (x[2], x[3],
                                               (x[1] in PLEINS and x[1] != dominante.get(x[0], x[1])),
                                               RANG.get(x[1], 9),
                                               x[0] != forme, x[0], x[1]))
        prefere = gold_par_forme.get(forme)
        if prefere:
            lemme_gold = majoritaire(prefere)
            meilleurs = [c for c in candidats if c[0] == lemme_gold]
            if meilleurs:
                candidats = meilleurs + [c for c in candidats if c not in meilleurs]
        choix[forme] = candidats[0][:2]
En Python, trier sur un tuple revient à comparer le premier élément, puis le deuxième en cas d’égalité, et ainsi de suite. Comme False passe avant True, une analyse non mutée (x[2] faux) passe avant une analyse mutée.
Les lignes suivantes donnent la priorité au corpus annoté d’apertium-br-fr, quand il existe. Ce corpus a été vérifié à la main : si l’on y a vu une forme rattachée à tel lemme, c’est une meilleure indication que n’importe quelle règle. Il est lu par une petite fonction :
def lire_corpus_annote(dossier):
    """Compte (forme, lemme) dans les fichiers *.tag.txt validés à la main."""
    vus = collections.Counter()
    for f in glob.glob(os.path.join(dossier, "**", "*.tag.txt"), recursive=True):
        forme = None
        for ligne in open(f, encoding="utf-8"):
            m = re.match(r'^"<(.+)>"', ligne)
            if m:
                forme = normaliser(m.group(1))
                continue
            m = re.match(r'^\s+"(.+?)"\s+(\S+)', ligne)
            if m and forme:
                vus[(forme, normaliser(m.group(1)), m.group(2))] += 1
                forme = None
    return vus
Le corpus est au format de Constraint Grammar : une ligne "<forme>", puis une ligne indentée avec le lemme retenu. Les comptages sont ensuite regroupés par forme, pour retrouver le lemme le plus souvent validé :
    gold = lire_corpus_annote(a.corpus_annote) if a.corpus_annote else {}
    gold_par_forme = collections.defaultdict(collections.Counter)
    for (forme, lemme, tag), n in gold.items():
        gold_par_forme[forme][lemme] += n
Le corpus est petit : il ne départage que 53 formes. Mais il corrige les règles là où elles se trompent, et l’option --corpus-annote reste facultative.
Étape 5 : un lemme, une catégorie, et l’écriture du fichier
Après l’étape 4, chaque forme a son lemme. Mais deux formes d’un même lemme peuvent avoir reçu des catégories différentes, ce qu’IRaMuTeQ n’accepte pas. Le script compte donc les catégories de chaque lemme et règle les écarts de deux façons :
- entre deux mots pleins (nom, verbe, adjectif, adverbe), il aligne tout sur la catégorie majoritaire : c’est le cas de 2 449 formes ;
- quand un mot-outil partage son lemme avec un mot plein, il garde les deux, mais ajoute un suffixe au lemme le moins fréquent : 47 formes sont concernées.
    cats_par_lemme = collections.defaultdict(collections.Counter)
    for lemme, cat in choix.values():
        cats_par_lemme[lemme][cat] += 1
    renommes = harmonises = 0
    for forme, (lemme, cat) in list(choix.items()):
        cat_maj = majoritaire(cats_par_lemme[lemme])
        if cat == cat_maj:
            continue
        if cat in PLEINS and cat_maj in PLEINS:
            choix[forme] = (lemme, cat_maj)
            harmonises += 1
        else:
            choix[forme] = (f"{lemme}_{cat}", cat)
            renommes += 1
C’est ainsi que la particule verbale ez devient e_adv_sup : elle se distingue de la préposition e (« dans »), qui garde le lemme e. Dans les résultats d’IRaMuTeQ, le suffixe signale ces cas au premier coup d’œil.
Les éléments de locutions
À l’étape 3, on a mis de côté le dernier mot de certaines locutions. On les ajoute maintenant, mais seulement s’ils manquent au dictionnaire :
    cat_du_lemme = {lemme: cat for lemme, cat in choix.values()}
    ajoutes = 0
    for morceau, compteur in morceaux.items():
        if morceau in choix or len(morceau) < 2 or not re.fullmatch(r"[a-zà-ÿœæ_]+", morceau):
            continue
        (lemme, cat), _ = max(compteur.items(), key=lambda kv: (kv[1], kv[0][0].replace('_', '').isascii(), -len(kv[0][0]), kv[0]))
        cat = cat_du_lemme.setdefault(lemme, cat)
        choix[morceau] = (lemme, cat)
        ajoutes += 1
Cela ajoute 76 formes. doa, qu’on rencontre dans en doa ou hon doa, est ainsi rattaché à kaout (avoir), et raok à a-raok (avant). C’est utile parce que le script de préparation des textes, présenté plus bas, coupe les mots au trait d’union.
L’écriture du dictionnaire
Il ne reste qu’à écrire le fichier, trié par ordre alphabétique, en UTF-8 avec des fins de ligne Unix :
    with open(a.sortie, "w", encoding="utf-8", newline="\n") as out:
        for forme in sorted(choix):
            lemme, cat = choix[forme]
            out.write(f"{forme}\t{lemme}\t{cat}\n")
Lancer la construction
La construction n’exige pas d’installer Apertium : il suffit de récupérer les deux dépôts, puis de lancer le script.
git clone https://github.com/apertium/apertium-bre.git
git clone https://github.com/apertium/apertium-br-fr.git
python3 construire_lexique_br.py apertium-bre/apertium-bre.bre.dix --corpus-annote apertium-br-fr/corpus -o lexique_br.txt
En quelques secondes, le script affiche son bilan :
76 éléments de locutions ajoutés (raok -> a-raok, doa -> kaout…).
256309 formes écrites dans lexique_br.txt (11837 lemmes).
12084 formes ambiguës résolues, 2449 catégories harmonisées et 47 formes au lemme suffixé (une catégorie par lemme), 53 formes tranchées par le corpus annoté.
Catégories : ver 129192, adj 83154, nom 42129, adv 543, pre 519, con 285, aux 263, adj_num 63, pro_per 44, ono 35, pro_ind 29, art_ind 15, adv_sup 12, pro_dem 12, adj_pos 9, art_def 3, adj_ind 2
Les verbes représentent la moitié des formes : chaque verbe breton se conjugue à de nombreux temps et personnes, et chacune de ces formes peut muter.
La construction est reproductible. Avec les versions des sources indiquées dans le dépôt (commit e69f6b6 du 21 juillet 2021 pour apertium-bre, 6f0ec11 du 31 mai 2023 pour apertium-br-fr), elle redonne à l’octet près le fichier publié. Tous les chiffres exacts de cet article valent pour ces versions : ils changeront si apertium-bre évolue. Pour améliorer le dictionnaire, le plus utile est donc de contribuer à apertium-bre, puis de relancer le script.
Préparer ses textes bretons
Le dictionnaire écrit c_hoari : les textes doivent donc l’écrire de la même façon. C’est le rôle du troisième script, preparer_corpus_breton.py. Il fait trois choses :
- il réécrit c’h en c_h, quelle que soit l’apostrophe utilisée ;
- il ramène les autres apostrophes à l’apostrophe droite ;
- il sépare par défaut les mots à trait d’union : an den-se devient an den se, a-raok devient a raok. Le dictionnaire couvre chaque élément, ce qui évite des milliers de formes composées inconnues.
Le tout tient dans une fonction de quelques lignes :
import re

APOSTROPHES = "’ʼ‘`"


def normaliser(ligne, couper_tirets=True):
    if couper_tirets:
        ligne = re.sub(r"(?<=\w)-(?=\w)", " ", ligne)
    ligne = re.sub(r"([cC])[" + APOSTROPHES + r"']([hH])", r"\1_\2", ligne)
    ligne = re.sub(r"[" + APOSTROPHES + r"]", "'", ligne)
    ligne = ligne.replace(" ", " ").replace(" ", " ")
    return ligne
L’expression (?<=\w)-(?=\w) ne remplace que les tirets placés entre deux lettres : les tirets de dialogue et les traits d’union en début de ligne restent intacts. La seconde substitution garde la casse d’origine (C’hoari devient C_hoari), et IRaMuTeQ passera tout en minuscules. La dernière ligne remplace les espaces insécables, fréquentes dans les textes copiés du web, par des espaces ordinaires. Dans le fichier du dépôt, ces deux caractères sont écrits tels quels ; ils sont notés ici \ \ et \ \ pour rester visibles.
Le script accepte deux sortes de fichiers. S’il trouve des lignes étoilées (**** *variable_modalite), il considère que le corpus est déjà au format IRaMuTeQ et ne modifie que les lignes de texte. Sinon, il encadre le texte brut d’une ligne **** *texte_1, ou crée un texte par paragraphe avec l’option --un-texte-par-paragraphe.
Le lancer
Il faut Python 3.8 ou plus récent, sans aucune bibliothèque à installer. Sous Linux et macOS, Python est déjà là. Sous Windows, installez-le depuis python.org en cochant Add Python to PATH, puis remplacez python3 par python dans les commandes.
Téléchargez le dépôt (bouton vert Code, puis Download ZIP), décompressez-le et ouvrez un terminal dans ce dossier :
# texte déjà au format IRaMuTeQ, ou texte brut
python3 preparer_corpus_breton.py mon_texte.txt -o corpus_pret.txt

# même chose, en Windows-1252 avec fins de ligne Windows
python3 preparer_corpus_breton.py mon_texte.txt -o corpus_pret.txt --windows

# texte brut : un texte IRaMuTeQ par paragraphe
python3 preparer_corpus_breton.py textes_bruts.txt --un-texte-par-paragraphe -o corpus_pret.txt
L’option --garder-tirets désactive la séparation des mots à trait d’union.
Les corpus bretons produits par wiki2iramuteq, l’outil du premier article, sont déjà au format IRaMuTeQ : il suffit de les passer dans ce script.
Installer le dictionnaire dans IRaMuTeQ
Le dictionnaire prêt à l’emploi se trouve dans le dossier dictionnaire du dépôt : lexique_br.txt. Pour le récupérer seul, cliquez sur le fichier dans GitHub, puis sur le bouton de téléchargement (Download raw file).
Méthode A : choisir le dictionnaire à l’ouverture du corpus
Dans la fenêtre de paramètres qui s’affiche avec Fichier → Ouvrir un corpus :
- encodage : utf-8 (ou cp1252 pour un fichier préparé avec
--windows) ; - langue : autre ;
- dictionnaire : Autre, puis désignez
lexique_br.txt.
C’est la méthode la plus simple, mais elle a une limite : avec la langue autre, IRaMuTeQ ne peut pas utiliser de dictionnaire des expressions. Ce second dictionnaire regroupe les expressions de plusieurs mots en une seule forme, par exemple a contrario en a_contrario. Ce n’est pas une perte aujourd’hui, puisqu’il n’existe pas encore de liste d’expressions bretonnes. Mais si vous voulez en ajouter une un jour, il faudra passer par la méthode B.
Méthode B : remplacer le dictionnaire d’une langue inutilisée
Cette méthode consiste à « prêter » au breton une langue que vous n’utilisez pas. IRaMuTeQ range ses dictionnaires dans le dossier .iramuteq (ou .Iramuteq) de votre dossier personnel, sous-dossier dictionnaires. Chaque langue y a un code de deux lettres et deux fichiers : lexique_xx.txt pour la lemmatisation et, le plus souvent, expression_xx.txt pour les expressions. Voici ce qu’on y trouve :
| Code | Langue | Lexique (lignes) | Expressions (lignes) |
|---|---|---|---|
de |
allemand | 1 470 | 8 |
en |
anglais | 195 788 | 46 |
sp |
espagnol | 88 736 | 0 (fichier vide) |
fr |
français | 249 438 | 4 591 |
gl |
galicien | 980 348 | 547 |
gr |
grec | 916 | 0 (fichier vide) |
it |
italien | 335 928 | 298 |
nl |
néerlandais | 194 422 | pas de fichier |
nn |
norvégien | 22 398 | pas de fichier |
pt |
portugais | 285 230 | 1 |
sw |
suédois | 1 312 412 | 1 |
Le choix de la langue à remplacer compte. Si elle a un dictionnaire d’expressions rempli, IRaMuTeQ appliquerait des expressions étrangères à vos textes bretons. Mieux vaut donc choisir une langue sans expressions : grec ou espagnol (fichier vide), néerlandais ou norvégien (pas de fichier). Le grec est un bon candidat : son lexique est minuscule et peu de corpus l’utilisent.
La marche à suivre, avec le grec :
- dans le dossier
dictionnaires, renommezlexique_gr.txtenlexique_gr_origine.txt, pour pouvoir revenir en arrière ; - copiez
lexique_br.txtdans ce dossier et renommez la copielexique_gr.txt; - à l’ouverture d’un corpus breton, choisissez la langue grec : IRaMuTeQ chargera en réalité le dictionnaire breton ;
- le cas échéant, ajoutez vos expressions bretonnes dans
expression_gr.txt, au même format que le fichier français.
Attention : tant que le remplacement est en place, la langue grec désigne le breton pour tous vos corpus. Pour analyser à nouveau un texte grec, remettez le fichier d’origine sous son nom lexique_gr.txt.
Un premier essai
Le dossier corpus_test contient un corpus déjà préparé, en UTF-8 et en Windows-1252. Il reprend les 1 164 phrases du corpus d’Apertium, réparties en 47 textes. Ouvrez-le avec le dictionnaire, lancez les Statistiques textuelles, et regardez les formes classées nr (non reconnues) : ce sont surtout des noms propres.
Sur ce corpus, le dictionnaire reconnaît 11 693 occurrences sur 11 825, soit 98,9 %. Ce chiffre est flatteur, car ce corpus a servi à développer Apertium. Sur un texte contemporain, dialectal ou ancien, attendez-vous à une couverture plus faible.
Essai sur le corpus de test
Le dictionnaire tient ses promesses sur le corpus de test : la quasi-totalité des mots sont reconnus, et seuls restent de côté quelques noms propres.
Nous l’avons ouvert avec les réglages de la méthode A : encodage utf-8, langue autre, dictionnaire lexique_br.txt, dictionnaire des expressions décoché (expressions = 0). IRaMuTeQ affiche alors ce bilan dans la description du corpus :
| Indicateur | Valeur |
|---|---|
Textes (ucinb) |
47 |
Segments de texte (ucenb) |
332 |
| Occurrences | 11 827 |
| Formes différentes | 2 273 |
| Hapax (formes vues une seule fois) | 1 284, soit 56,5 % des formes et 10,9 % des occurrences |
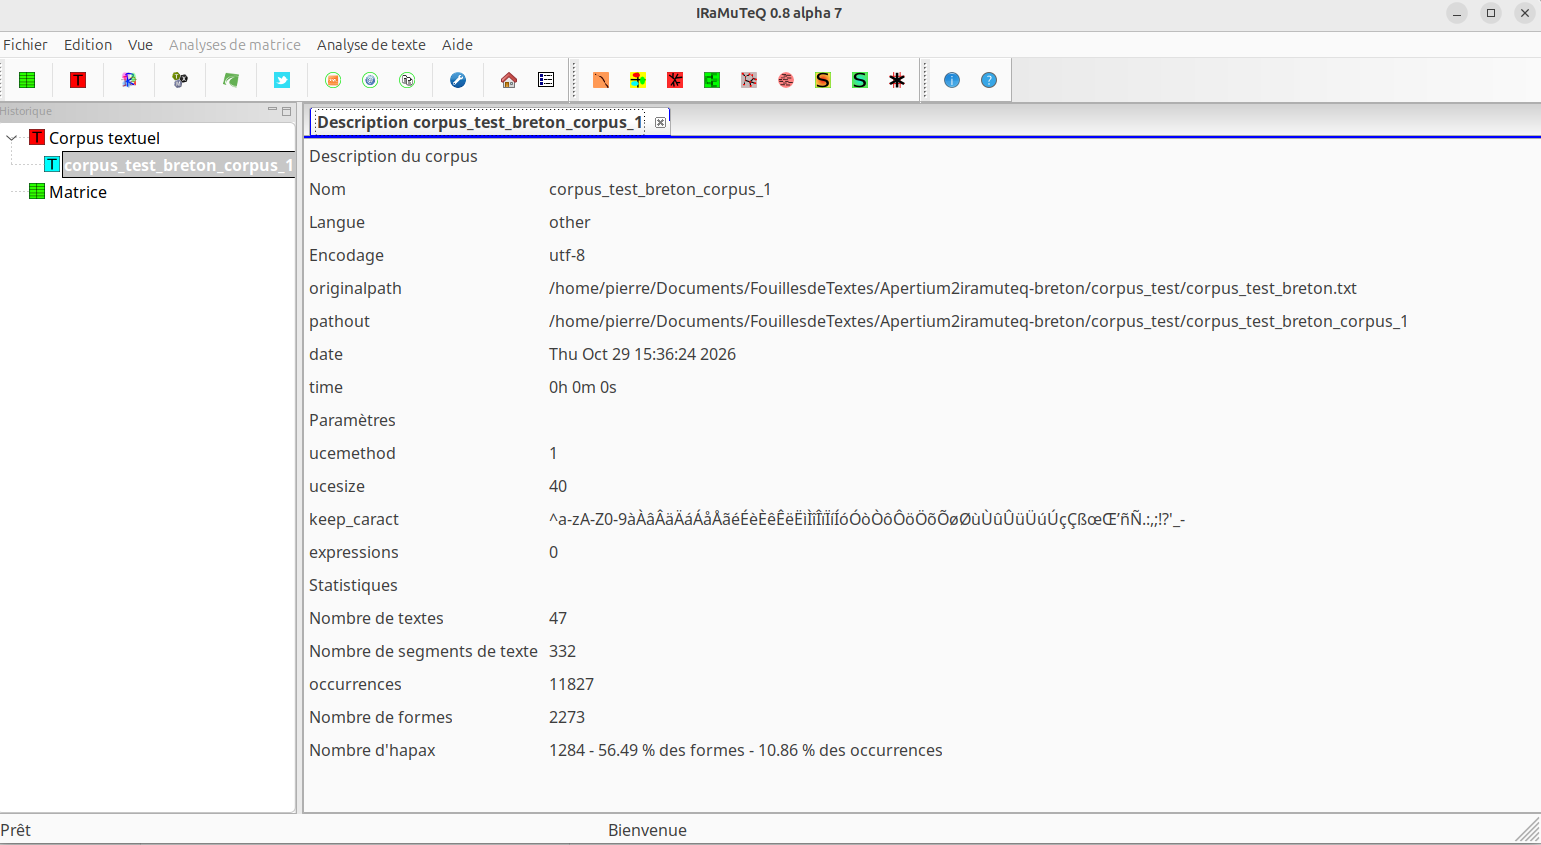
Les segments font environ 40 occurrences, la taille par défaut (ucesize = 40). Plus de la moitié des formes n’apparaissent qu’une fois : c’est courant sur un petit corpus, et les mutations y contribuent, puisqu’elles multiplient les formes d’un même mot.
Les statistiques textuelles : le vocabulaire divisé par deux
Les Statistiques textuelles d’IRaMuTeQ comptent cette fois les formes après lemmatisation. Le résultat montre l’effet du dictionnaire : les 2 273 formes du texte se ramènent à 1 159 formes lemmatisées.
| Indicateur | Sans dictionnaire | Avec le dictionnaire breton |
|---|---|---|
| Formes différentes | 2 273 | 1 159 |
| Hapax | 1 284 | 523 |
| Part des hapax dans les formes | 56,5 % | 45,1 % |
| Part des hapax dans les occurrences | 10,9 % | 4,4 % |
Pour obtenir la colonne « sans dictionnaire », nous avons rouvert le même fichier en désignant un dictionnaire vide (un simple fichier texte vide) : IRaMuTeQ exige un dictionnaire dès qu’on choisit « Autre », et le dictionnaire « Défaut » est celui du français.
Les 11 827 occurrences restent les mêmes, soit 251,6 en moyenne par texte. Mais un même mot n’est plus dispersé sous ses formes mutées ou conjuguées : tud, dud et zud comptent ensemble pour den, toutes les formes de bezañ pour un seul verbe. Les hapax reculent d’autant : beaucoup de formes vues une seule fois étaient en fait des variantes de mots fréquents.
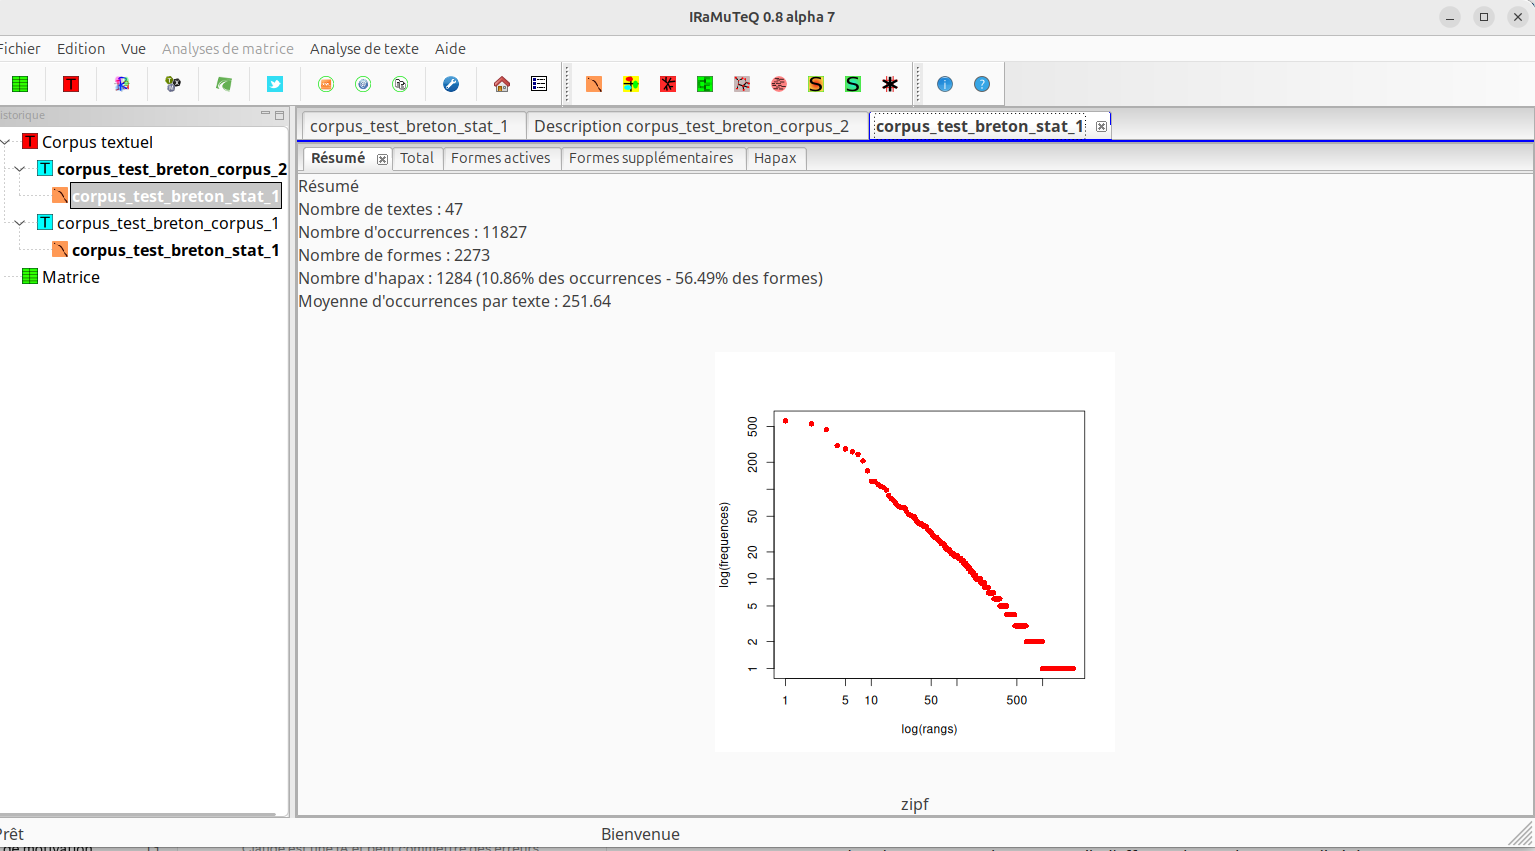
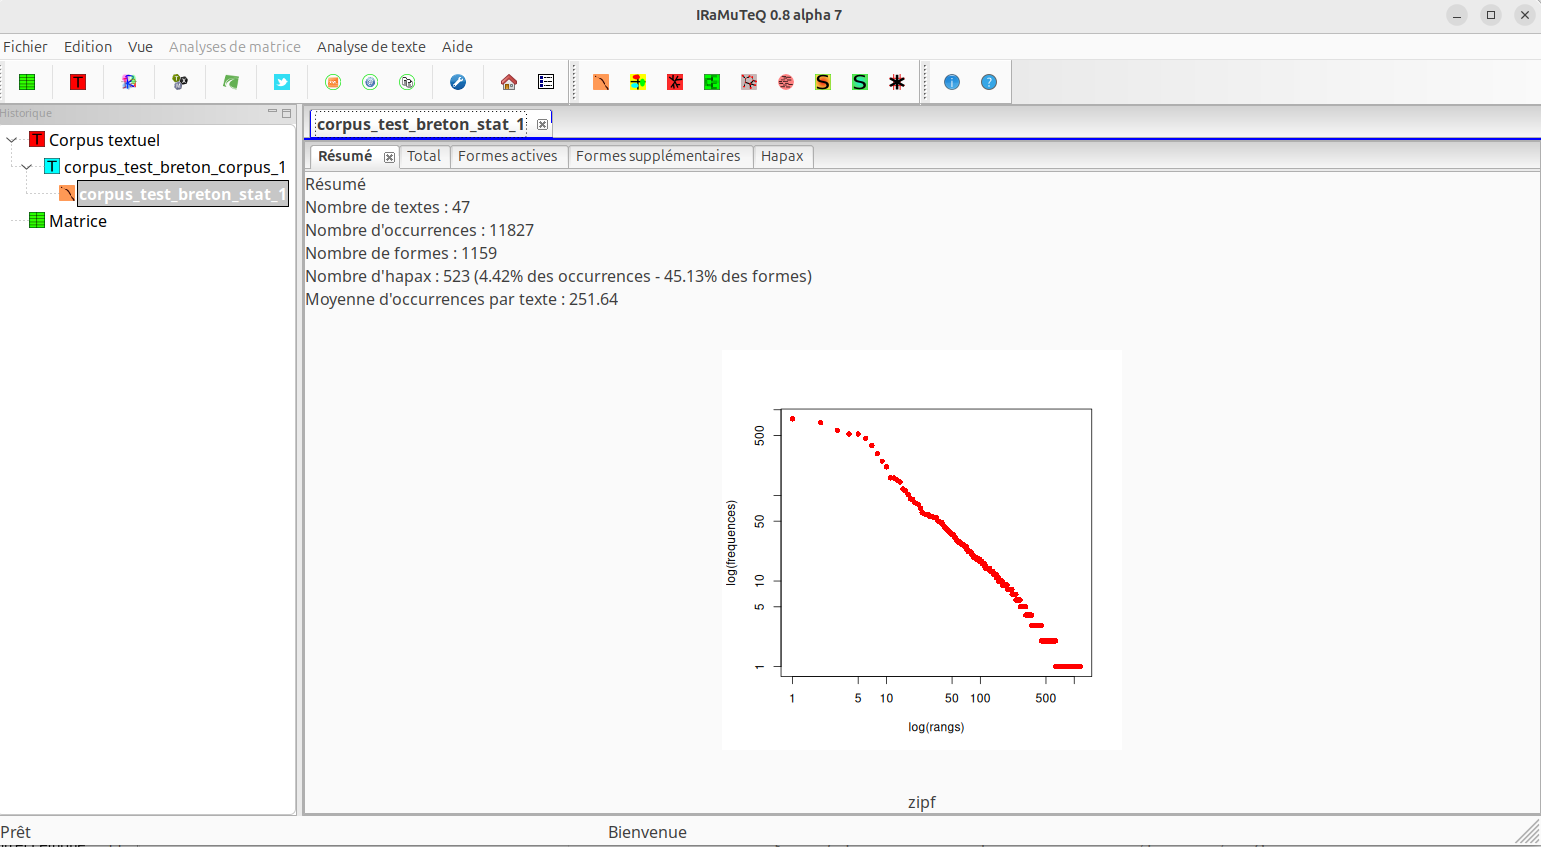
Le diagramme de Zipf, en bas de chaque écran, classe les formes de la plus fréquente à la plus rare, sur deux échelles logarithmiques. Les points s’alignent presque sur une droite : c’est la loi de Zipf, qu’on observe sur les corpus de toutes les langues : quelques mots très fréquents, une longue traîne de mots rares. Le breton lemmatisé ne fait pas exception.
Les formes actives : un corpus de verbes
L’onglet Formes actives liste les mots pleins, du plus fréquent au plus rare. Les verbes y dominent largement : ober (faire, 251 occurrences), dont (venir, 143), gallout (pouvoir, 91), gouzout (savoir, 82), monet (aller, 78), gwelet (voir, 60), komz (parler, 60). Le premier nom, den, n’arrive qu’en neuvième position.
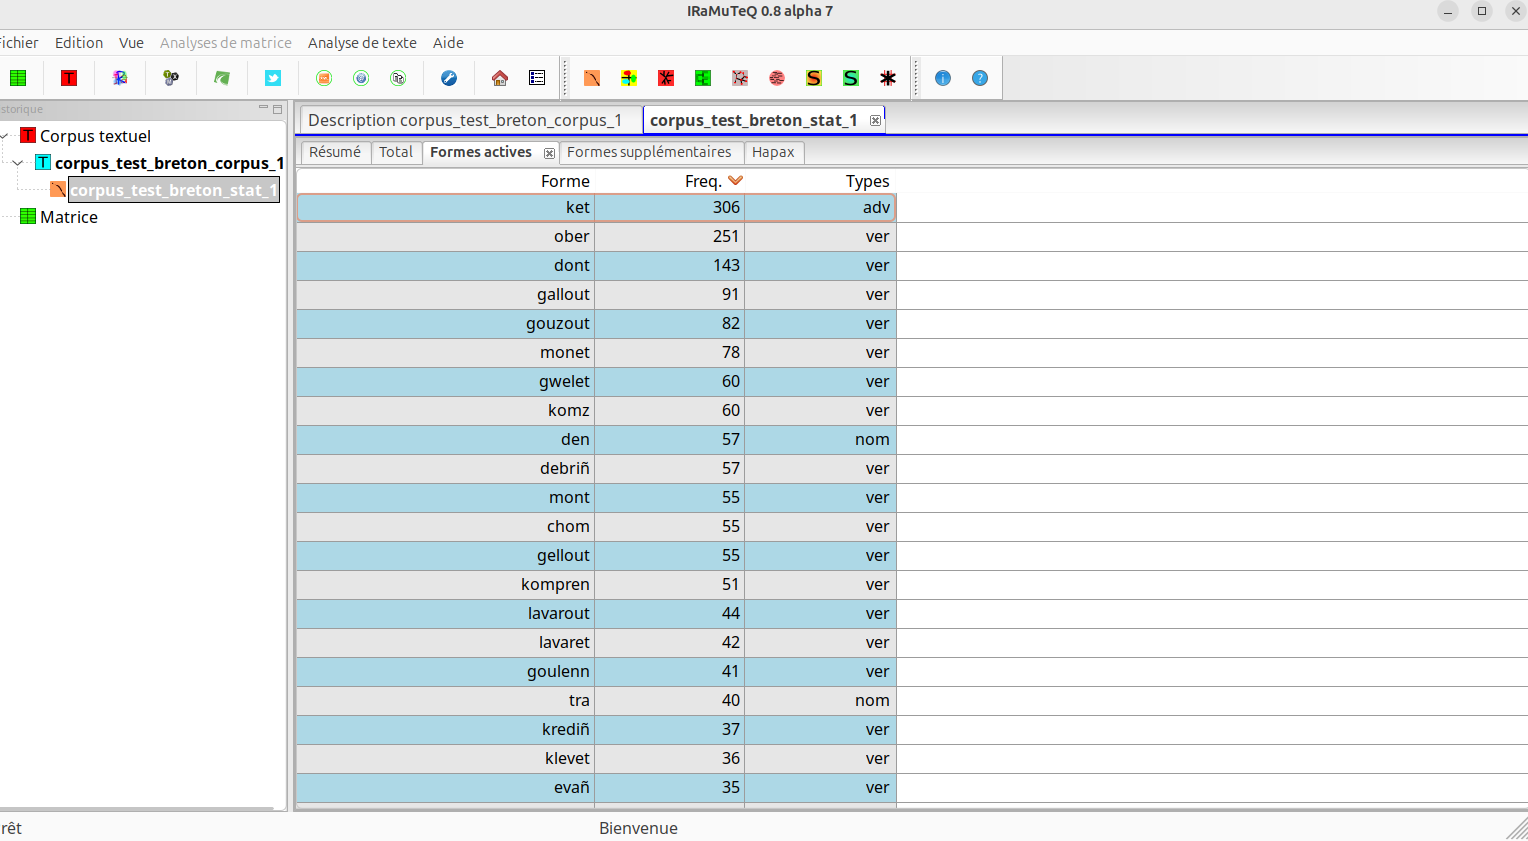
Cette prépondérance des verbes tient à la nature du corpus : ce sont les phrases d’exemple qui servent à tester le traducteur d’Apertium, construites pour couvrir la conjugaison. On n’y attend pas un vocabulaire thématique.
La liste révèle aussi deux défauts du dictionnaire, invisibles dans les chiffres globaux :
- ket (pas, dans la négation ne… ket) arrive en tête avec 306 occurrences. Apertium le classe comme adverbe ordinaire, et non comme négation : il devient donc une forme active. Dans le dictionnaire français d’IRaMuTeQ, ne et pas sont classés
adv_sup, donc supplémentaires. - Un même verbe peut avoir deux lemmes. Apertium enregistre certaines variantes comme des entrées distinctes : mont et monet (aller), gallout et gellout (pouvoir), lavaret et lavarout (dire). Leurs occurrences sont alors séparées dans les analyses : monet (78) et mont (55) comptent pour deux verbes différents.
Ces deux défauts seront corrigés dans une prochaine version du dictionnaire.
Les formes supplémentaires : les mots-outils
L’onglet Formes supplémentaires regroupe les mots-outils, que le dictionnaire a classés dans les catégories d’IRaMuTeQ. On y retrouve la préposition e (dans, 781 occurrences), le verbe bezañ (707), la préposition a (de, 577), l’article an (521) et la préposition da (à, 521).
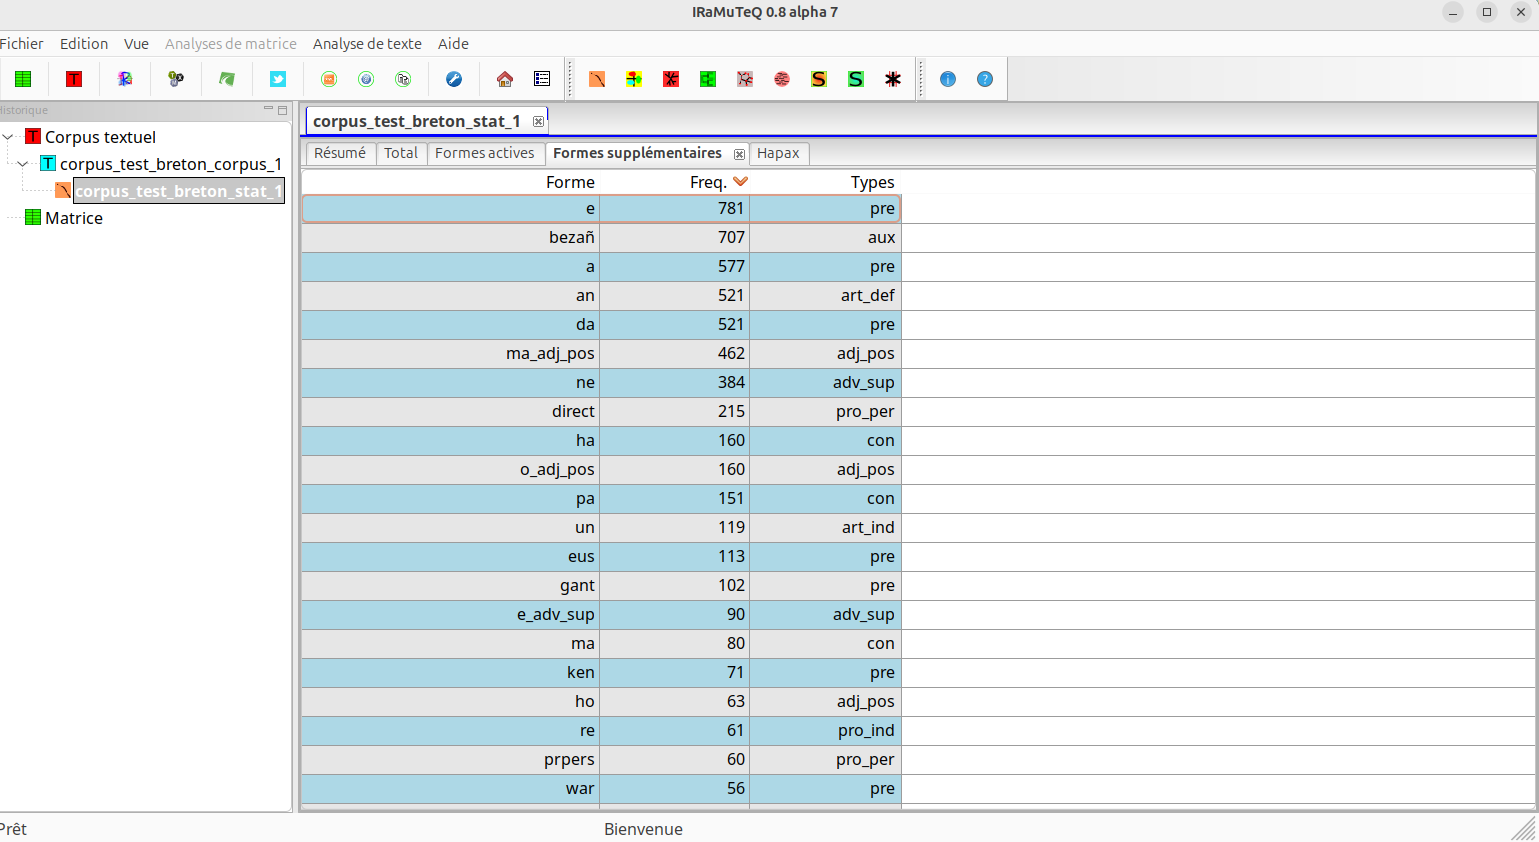
C’est là que la règle « une forme, une analyse » se voit le plus, car les petits mots bretons ont souvent plusieurs rôles :
- ma (462 occurrences) est toujours lu comme le possessif « mon », d’où le lemme suffixé
ma_adj_pos. Or ma est aussi une conjonction (« que », « si »). - o (160) est toujours lu comme le possessif « leur » (
o_adj_pos), alors que c’est aussi la particule de o tañsal, « en train de danser ». - e est toujours lu comme la préposition. Sur les 781 occurrences du lemme, 535 viennent de la forme e elle-même (les autres de en, em, er…), et une partie de ces 535 sont en réalité la particule verbale e. Seules les formes sans ambiguïté, comme ez, rejoignent le lemme
e_adv_sup.
Deux lemmes surprennent aussi : direct et prpers. Ce sont des étiquettes internes d’Apertium. direct regroupe les pronoms compléments (am, az, anezhañ…) et prpers les pronoms sujets (eñ, me, int…).
Ces confusions restent sans effet sur les analyses par défaut, puisque toutes ces formes sont des mots-outils et restent supplémentaires. Elles comptent en revanche si l’on étudie les mots-outils eux-mêmes.
Les formes non reconnues
Pour voir les formes que le dictionnaire ne connaît pas, il suffit d’ouvrir l’onglet Total et de trier la colonne Types : les formes nr (non reconnues) se regroupent. Elles sont une centaine, pour 132 occurrences seulement, soit environ 1 % du corpus.
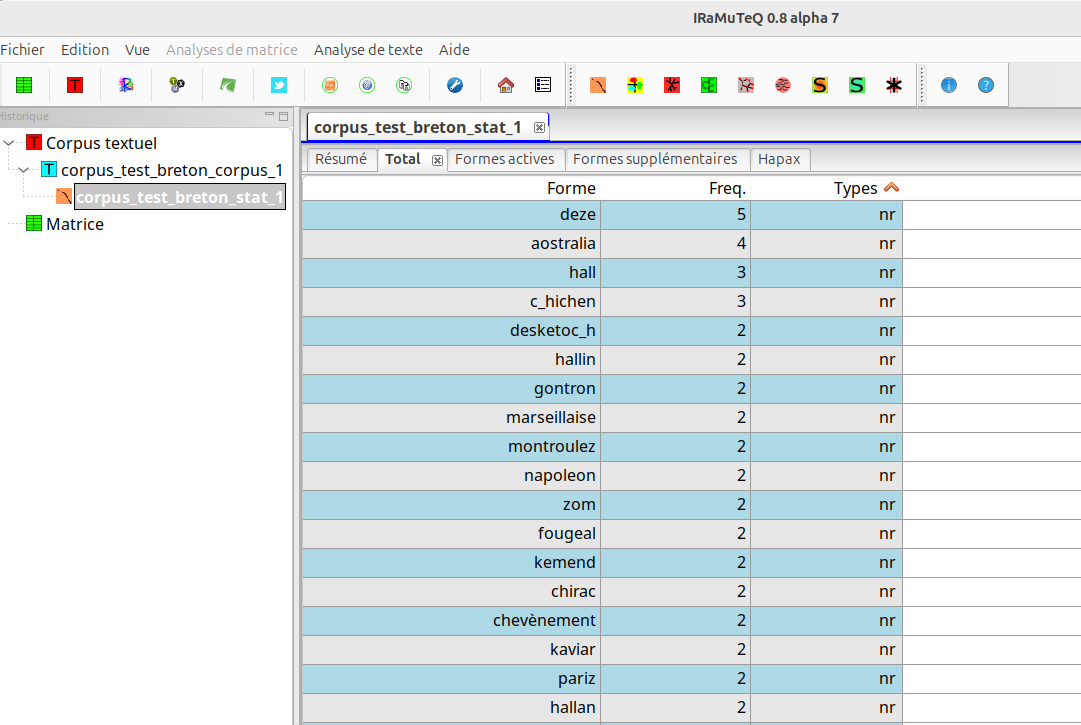
Elles se répartissent en quatre groupes :
- des noms propres, que le dictionnaire exclut volontairement : Aostralia, Pariz, Montroulez (Morlaix), Napoleon, Chirac, Chevènement, Marseillaise ;
- des formes de mots connus, écrites autrement : hall, hallan et hallin viennent de n’hall ket (« ne peut pas »), forme élidée de gallout qu’IRaMuTeQ coupe à l’apostrophe ; kemend est une variante de kement ; c’hichen est kichen muté après o (en o c’hichen, « à côté d’eux ») ; deze est une forme contractée de deveze (kaout), dans p’en deze c’hoant, « quand il avait envie » ;
- des mots absents d’Apertium : kaviar (caviar), fougeal (se vanter), desketoc’h (plus instruit), et gontron, forme mutée de kontron (asticots), dans leun a gontron ;
- une probable faute de frappe : zom, dans stardet e zom et en e zom, semble être zorn, forme mutée de dorn (la main) : « serré sa main », « dans sa main ».
Le premier groupe ne pose pas de problème : on pourra garder ou écarter les noms propres selon l’analyse. Les deux suivants montrent comment enrichir le dictionnaire : en ajoutant les mots et les variantes qui manquent à apertium-bre, puis en relançant la construction.
Le nuage de mots
Le nuage de mots d’IRaMuTeQ affiche les mots du corpus en taille proportionnelle à leur fréquence. La comparaison des deux nuages, sans puis avec le dictionnaire, montre d’un coup d’œil ce que change la lemmatisation.
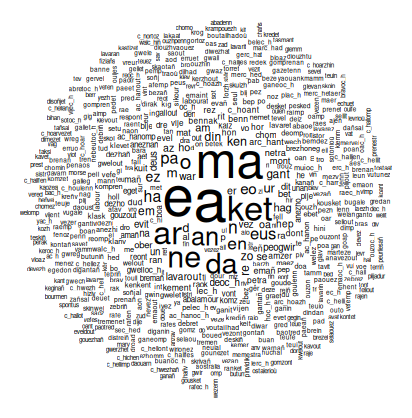
Sans dictionnaire, IRaMuTeQ ne sait pas distinguer les mots-outils des mots pleins : il les affiche tous. Le nuage est alors dominé par les petits mots les plus fréquents : ma, e, a, ar, an, ne, da, eus. Les verbes sont éparpillés sous leurs formes conjuguées et disparaissent presque.
Avec le dictionnaire, les mots-outils sont classés supplémentaires et sortent du nuage. Les formes conjuguées se regroupent sous leur infinitif, qui gagne en taille.
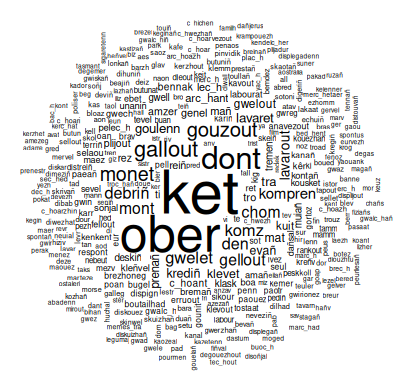
Les verbes y occupent le centre : ober (faire), dont (venir), gallout (pouvoir), gouzout (savoir), monet (aller), debriñ (manger). C’est la signature d’un corpus construit pour tester la conjugaison.
Les deux défauts relevés plus haut sautent aussi aux yeux. ket, la négation, est le plus gros mot du nuage alors qu’il devrait être supplémentaire. Et un même verbe apparaît deux fois : monet et mont, gallout et gellout, lavaret et lavarout. La version corrigée du dictionnaire devrait donner un nuage plus juste.
La classification de Reinert
La classification de Reinert (méthode Alceste) regroupe les segments de texte qui emploient le même vocabulaire. Elle ne fonctionne bien que sur un corpus lemmatisé : sans dictionnaire, les formes mutées et conjuguées d’un même mot seraient traitées comme des mots différents.
Sur le corpus de test lemmatisé, l’analyse retient 375 formes actives, celles qui apparaissent au moins 3 fois. Elle classe 283 des 332 segments, soit 85 %, en 6 classes de 12 % à 22 % des segments classés.
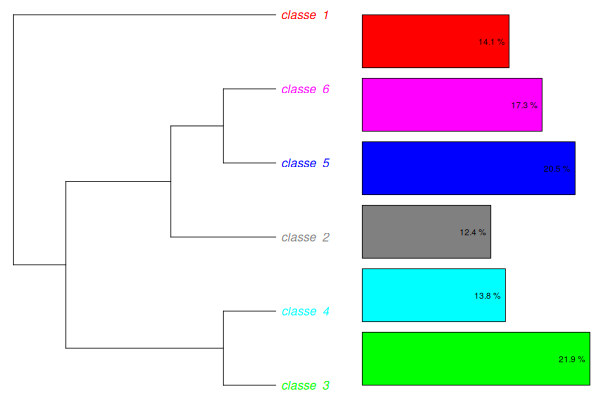
Le dendrogramme se lit de gauche à droite. La classe 1 se détache la première du reste du corpus. Les classes 3 et 4 forment ensuite un groupe à part, tandis que les classes 2, 5 et 6 restent proches.
Le fichier profiles.csv de l’analyse donne, pour chaque classe, les formes les plus caractéristiques (classées par χ²). Malgré un corpus fait de phrases d’exemple sans lien entre elles, des thèmes nets apparaissent :
| Classe | Segments | Formes les plus caractéristiques | Thème |
|---|---|---|---|
| 3 | 62 (21,9 %) | bara (pain), butuniñ (fumer), neuial (nager), dimeziñ (se marier), dour (eau), kig (viande), prenañ (acheter), pesk (poisson) | La vie quotidienne : manger, boire, fumer |
| 5 | 58 (20,5 %) | lavarout (dire), soñjal (penser), eur (heure), krediñ (croire), monet (aller), gouzout (savoir), skrivañ (écrire) | La parole et la pensée |
| 6 | 49 (17,3 %) | tra bennak (quelque chose), digeriñ (ouvrir), gallout (pouvoir), komz (parler), fellout (vouloir), respont (répondre), dleout (devoir) | Vouloir, pouvoir, devoir ; l’échange |
| 1 | 40 (14,1 %) | deviñ, deze, tan (feu), lakaat (mettre), gwiskañ (s’habiller), skeiñ (frapper), erc’h (neige) | Les phrases en pa (quand), surtout le texte 22 |
| 4 | 39 (13,8 %) | trouz (bruit), bugel (enfant), skinwel (télévision), kanañ (chanter), klevet (entendre), galleg (français), familh | La maison et la famille |
| 2 | 35 (12,4 %) | terriñ (casser), deiz (jour), kouezhañ (tomber), poliser (policier), brec’h (bras), botez (chaussure), karr (voiture) | La rue et les accidents |
IRaMuTeQ complète la classification par une analyse factorielle des correspondances (AFC). Elle place les formes, les textes et les classes sur un plan : plus deux éléments sont proches, plus leurs emplois se ressemblent. Les deux premiers facteurs résument ici 49 % de l’information (26,3 % et 22,8 %).
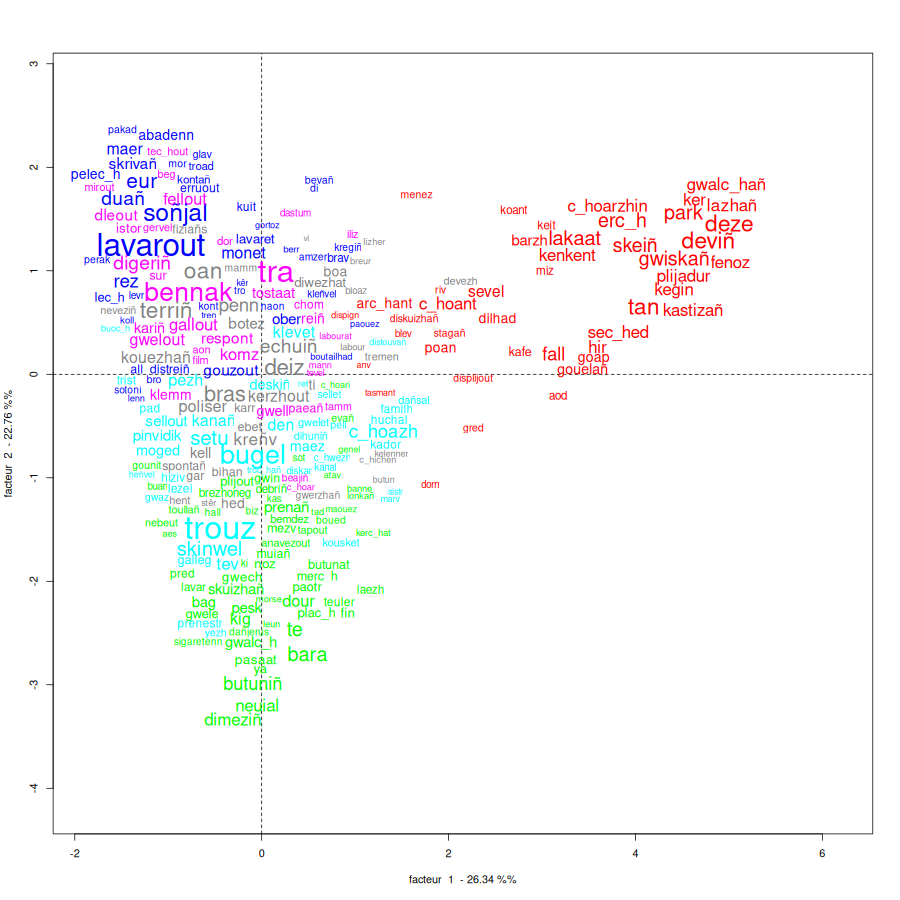
Le premier facteur, horizontal, isole la classe 1, en rouge, à droite du plan. Le second, vertical, oppose la parole et la pensée en haut (lavarout, soñjal, tra bennak, classes 5 et 6) à la vie quotidienne en bas (bara, butuniñ, neuial, classe 3). Les classes 2 et 4 occupent le centre.
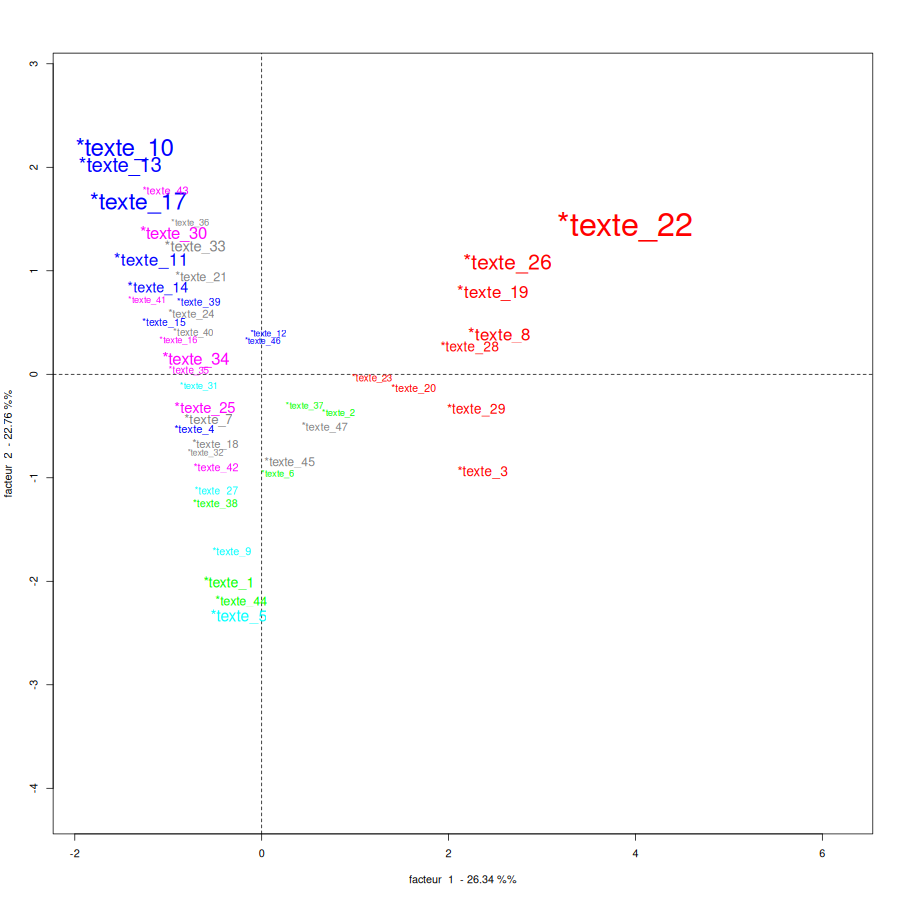
Le plan des textes explique l’isolement de la classe 1 : elle est portée surtout par le texte 22, à droite. Ce texte est un exercice de grammaire fait uniquement de phrases en pa (« quand ») : Pa oa echu an diskrog labour…, P’he deze poan ne lavare mann… La classe 1 n’est donc pas un thème, mais une construction grammaticale. C’est une particularité du corpus de test, fait d’exercices : sur un corpus réel, les classes reflètent plutôt des sujets.
La classification est aussi un bon révélateur des faiblesses du dictionnaire :
- La classe 1 repose en partie sur une erreur. Sa forme la plus caractéristique, deviñ (brûler), vient en réalité de devez dans p’en devez ou p’o devez sec’hed, « quand il a, quand ils ont soif » : une forme de kaout (avoir). Comme devez ne commence pas comme kaout, le script l’a prise pour une forme mutée et lui a préféré la lecture « sans mutation » deviñ. La forme contractée deze, non reconnue, l’accompagne.
- Les verbes en double se retrouvent dans des classes différentes ou côte à côte : lavarout et lavaret sont tous deux dans la classe 5, gallout et gellout dans la classe 6.
Ces trois défauts, ket, les verbes en double et devez, sont du même ordre : ils se corrigent dans le script de construction, sans toucher à Apertium.
Limites, licence et suite
Ce dictionnaire rend IRaMuTeQ utilisable en breton, mais il garde les limites de toute lemmatisation sans contexte :
- Les choix faits sur les formes ambiguës sont parfois faux. Environ 12 000 formes sont concernées. gant sera toujours la préposition, même dans les rares phrases où il s’agit de kant muté. De même, eus est toujours lu comme la préposition « de », y compris dans ez eus (« il y a »), où il s’agit en fait d’une forme de bezañ. Comme les deux lectures sont des mots-outils, l’effet sur les analyses reste limité.
- Trois défauts relevés sur le corpus de test, à corriger dans une prochaine version : ket (négation) est classé comme adverbe actif au lieu de
adv_sup; quelques verbes sont répartis sur deux lemmes (mont / monet, gallout / gellout, lavaret / lavarout) ; devez (forme de kaout) est rattaché par erreur à deviñ (brûler). - Les lemmes suffixés (
e_adv_sup…) sont un compromis imposé par la règle « un lemme, une catégorie ». - La catégorie
pro_pern’est pas connue de toutes les versions d’IRaMuTeQ (fichierkey.cfg). Si elle pose problème, régénérez le dictionnaire avec l’option--sans-pro-per: les pronoms personnels passent alors enpro_ind. - L’orthographe et les mutations : Apertium suit l’orthographe unifiée (peurunvan). Les textes en orthographe universitaire, interdialectale ou ancienne seront moins bien couverts. Il en va de même pour les mutations : chez certains locuteurs, notamment âgés ou semi-locuteurs, elles varient ou se simplifient, et l’on entend par exemple ma dad au lieu de ma zad (« mon père »). Le dictionnaire lemmatise chaque forme isolément, sans regarder le mot qui précède : dad et zad sont tous deux rattachés à tad, mais l’accord entre la mutation et son déclencheur n’est pas vérifié.
Licence et citation
apertium-bre est distribué sous licence GNU GPL version 3. Le dictionnaire en est dérivé : il est distribué sous la même licence, comme les scripts. Pour citer ce travail :
Rouarch, P. (2026). Apertium2iramuteq-breton : dictionnaire breton pour IRaMuTeQ à partir d’Apertium. Anakeyn. https://github.com/Anakeyn/Apertium2iramuteq-breton
Et ensuite ?
Cette première étude sur le corpus de test a montré que le dictionnaire tient ses promesses, mais aussi où il faut l’améliorer. La prochaine étape sera donc une version corrigée du dictionnaire breton, qui traitera les trois défauts relevés : la négation ket classée parmi les formes actives, les verbes répartis sur deux lemmes (mont / monet, gallout / gellout, lavaret / lavarout) et la forme devez rattachée à deviñ au lieu de kaout. Les corrections se feront dans le script de construction et seront publiées dans un nouveau dépôt GitHub, Apertium2iramuteq-bretonV2. Celui de cet article restera tel quel, pour que le code et les chiffres présentés ici restent vérifiables.
Le prochain article reprendra le même corpus de test avec ce dictionnaire corrigé, pour vérifier que les corrections améliorent bien les résultats : statistiques, nuage de mots et classification.
Nous pourrons alors analyser les corpus bretons de Wikipédia constitués dans le premier article, et comparer les sujets qui intéressent les contributeurs des Wikipédia bretonne et française.
Sources
- Apertium2iramuteq-breton, le dépôt de cet article
- apertium-bre, dictionnaire morphologique du breton
- apertium-br-fr, traducteur breton–français et corpus annoté
- IRaMuTeQ
- wiki2iramuteq, outil du premier article
- Les humanités numériques vues par Wikipédia : décrire et analyser un corpus avec IRaMuTeQ, deuxième article de la série