Partager la publication "Correction du Dictionnaire de Breton d’Apertium vers IRaMuTeq"
Dans l’article précédent, nous avons transformé le dictionnaire breton d’Apertium en un lexique utilisable par IRaMuTeQ, puis nous l’avons essayé sur un petit corpus de test. Cet essai a fait ce qu’on attend d’un premier essai : il a montré où le dictionnaire se trompait.
Trois défauts y étaient signalés : la négation ket comptée comme un adverbe plein, des verbes répartis entre deux lemmes (mont et monet, gallout et gellout, lavaret et lavarout), et devez rattaché à tort à deviñ (brûler), au point de caractériser une classe entière. En les corrigeant, d’autres problèmes sont apparus, plus discrets.
Cet article présente la version 2 du dictionnaire. Nous verrons les corrections une par une, avec le code qui les met en œuvre, puis nous referons exactement les mêmes analyses dans IRaMuTeQ pour comparer les deux versions.
Une remarque de méthode avant de commencer : pour que la comparaison ait un sens, une seule chose doit changer entre les deux essais, le dictionnaire. Tout le reste est identique.
- les sources Apertium :
apertium-breau commite69f6b6etapertium-br-frau commit6f0ec11; - le fichier d’expressions
expression_br.txt, et donc le corpus de test préparé parpreparer_corpus_breton.py; - les réglages d’IRaMuTeQ (voir plus bas).
La version 1 reste disponible, inchangée, dans le dépôt Apertium2iramuteq-breton, pour rester conforme au premier article. La version 2 est publiée dans un nouveau dépôt, Apertium2iramuteq-bretonV2. Les deux constructions sont reproductibles : avec les mêmes sources, le script redonne exactement les fichiers des dépôts.
Les corrections de la version 2
Toutes les corrections se trouvent dans construire_lexique_br.py. Pour qu’on puisse les relire et les compléter facilement, elles sont regroupées en tête du script, dans quelques tables : NEGATIONS, VARIANTES, GARDER_VERBE_PLEIN, AJOUTS et les tables des pronoms.
1. La négation ket
En breton, la négation encadre le verbe : ne… ket, comme ne… pas en français. Dans la v1, ne était bien classé en adv_sup, c’est-à-dire adverbe supplémentaire, mais ket était un adverbe ordinaire (adv).
Pourquoi ? Apertium déclare ket avec le même paradigme qu’un adverbe comme ouzhpenn (« en plus »), sans l’étiquette <neg> qui nous servait à repérer les négations. Conséquence : avec ses 300 occurrences, ket était l’une des formes actives les plus fréquentes du corpus de test, et il participait aux classifications. C’est comme si l’on gardait pas parmi les formes actives d’un corpus français.
La correction tient en une table et une condition :
# Adverbes de négation : « ket » est étiqueté adverbe simple dans Apertium
# (paradigme ouzhpenn__adv, sans <neg>). On le range avec « ne » en adv_sup,
# comme « ne » et « pas » dans le dictionnaire français d'IRaMuTeQ.
NEGATIONS = {"ket"}
return "adv_sup" if "neg" in s or lemme in NEGATIONS else "adv"
2. Les verbes en double
Apertium enregistre certaines variantes d’un même verbe comme des lemmes distincts, souvent en lecture seule (r="LR") : elles sont reconnues en analyse mais jamais produites en génération. Pour un traducteur automatique, c’est sans conséquence. Pour un lexique d’IRaMuTeQ, si : aet (allé) était rattaché à monet, mont (aller) restait de son côté, et le même verbe était compté deux fois, avec deux fréquences plus faibles chacune.
La table VARIANTES rattache chaque variante au lemme standard :
VARIANTES = {
    "monet": "mont",
    "gellout": "gallout",
    "lavarout": "lavaret",
    "lâret": "lavaret",
    "gelver": "gervel",
}
Elle est appliquée dès la lecture des analyses d’Apertium, avant toute autre décision :
        lemme_brut, etiq = decouper_analyse(analyse)
        lemme_brut = VARIANTES.get(lemme_brut, lemme_brut)
Cela concerne 421 formes du lexique.
3. Les formes de kaout écrites en deux mots
Le verbe kaout (avoir) se conjugue avec un pronom soudé à l’avant : en deus (il a), en devo (il aura), en doe (il eut), ou encore o devez, forme d’habitude. Apertium ne connaît ces formes qu’en deux mots. Les expressions soudées du dictionnaire (en_deus, he_deus…) les couvrent, mais le second mot, pris isolément, existait aussi dans le lexique… comme un autre verbe : deus était lu comme dont (venir), devez et devo comme deviñ (brûler), doe comme teiñ (fondre).
Un mot sur la démarche, car elle a pris deux détours :
- le premier diagnostic accusait la détection des mutations ; il était faux, le problème venait de la manière dont les éléments de locutions sont ajoutés au lexique ;
- un essai de règle de mutation plus stricte a été abandonné : il réglait ces cas mais faisait lire eur, ya, aze ou gris comme des verbes. Une correction qui crée plus d’erreurs qu’elle n’en supprime n’en est pas une.
La règle retenue est plus étroite : quand un élément de locution est un auxiliaire et que le mot isolé n’était qu’un verbe plein, l’auxiliaire l’emporte. Il ne l’emporte jamais sur un autre mot-outil.
Une forme fait exception : deus. Les emplois auxiliaires (en deus, he deus, o deus…) sont déjà soudés par les expressions : dans le corpus de test, en_deus apparaît 21 fois. Quand deus reste isolé, c’est presque toujours l’impératif de dont, « viens ! » (Deus amañ, « viens ici ») : les quatre deus isolés du corpus sont tous de ce type. Pour devez, devo et doe, c’est l’inverse : le sens de verbe plein (brûler, fondre) est rare. La table GARDER_VERBE_PLEIN exclut donc deus de la règle.
# Formes que la règle « l'auxiliaire l'emporte sur un verbe plein » ne doit
# pas toucher : isolées, elles sont presque toujours un verbe plein. « deus »
# est l'impératif de « dont » (viens) ; « en deus », « he deus »… sont déjà
# couverts par les expressions soudées.
GARDER_VERBE_PLEIN = {"deus"}
        if morceau in choix:
            # « en devez », « o devo », « en doe » : ces formes de kaout
            # n'existent dans Apertium qu'en deux mots ; le mot isolé y est un
            # verbe plein rare (deviñ, teiñ). L'auxiliaire l'emporte sur un
            # verbe plein, jamais sur un autre mot-outil, ni sur les formes
            # de GARDER_VERBE_PLEIN.
            if not (cat == "aux" and choix[morceau][1] == "ver"):
                continue
            if morceau in GARDER_VERBE_PLEIN:
                continue
            remplaces.append(f"{morceau} ({choix[morceau][0]} -> {lemme})")
        else:
            ajoutes += 1
4. Une forme ajoutée à la main : deze
deze est la contraction de deveze (p’en deze, « quand il avait »). Elle est absente d’Apertium : on l’ajoute à la main, rattachée à kaout. La table AJOUTS est aussi l’endroit où chacun peut corriger un rattachement sans attendre une nouvelle version d’Apertium.
# Formes absentes d'Apertium, ajoutées à la main : forme -> (lemme, catégorie)
AJOUTS = {
    "deze": ("kaout", "aux"),       # contraction de « deveze » (en deze)
}
    for forme, (lemme, cat) in AJOUTS.items():
        choix[forme] = (lemme, cat_du_lemme.setdefault(lemme, cat))
5. Des lemmes lisibles pour les pronoms
Dans la v1, les pronoms personnels avaient pour lemmes les étiquettes internes d’Apertium : prpers pour les pronoms sujets (me, te, eñ…), direct pour les pronoms compléments (anezhañ, ac’hanon…). Dans les résultats d’IRaMuTeQ, toutes les personnes se retrouvaient donc dans deux lemmes illisibles.
La v2 rattache chaque pronom au pronom sujet de la même personne, et chaque réfléchi à sa forme en -unan :
PRONOM_SUJET = {("p1", "sg"): "me", ("p2", "sg"): "te", ("p1", "pl"): "ni",
                ("p2", "pl"): "cʼhwi", ("p3", "pl"): "int",
                ("p3", "m", "sg"): "eñ", ("p3", "f", "sg"): "hi"}
PRONOM_REFLECHI = {("p1", "sg"): "ma-unan", ("p2", "sg"): "da-unan",
                   ("p1", "pl"): "hon-unan", ("p2", "pl"): "hocʼh-unan",
                   ("p3", "pl"): "o-unan", ("p3", "m", "sg"): "e-unan",
                   ("p3", "f", "sg"): "he-unan"}


def lemme_pronom(surface, etiquettes):
    """Lemme lisible pour « prpers » et « direct »."""
    s = set(etiquettes)
    pers = next((p for p in ("p1", "p2", "p3") if p in s), None)
    nb = "pl" if "pl" in s else "sg"
    cle = (pers, nb)
    if pers == "p3" and nb == "sg":
        cle = (pers, "f" if "f" in s else "m", nb)
    if "ref" in s:
        if surface.lower().startswith("an-unan"):
            return "an-unan"                # « an-unan » : soi-même
        return PRONOM_REFLECHI.get(cle)
    return PRONOM_SUJET.get(cle)
        if lemme_brut in ("prpers", "direct"):
            lemme_brut = lemme_pronom(surface, etiq[1:]) or lemme_brut
Ainsi anezhañ et hen deviennent eñ, ac’hanon et am deviennent me, e-unanik devient e-unan. Les pronoms restent des mots-outils (pro_per), donc supplémentaires : la correction rend les listes plus lisibles, sans changer les classifications.
Un effet de bord bienvenu : te était lu comme le nom te (le thé), un nom actif. Il est maintenant le pronom de la 2e personne, et le nom prend le lemme te_nom, puisqu’IRaMuTeQ n’accepte qu’une catégorie par lemme.
6. Une limite documentée : ma, o et e
Ces trois mots ont plusieurs emplois très fréquents : ma est un possessif (« mon ») ou une conjonction (« si », « que »), o un possessif (« leur ») ou la particule du participe présent (o vont, « en allant »), e une préposition, un possessif ou une particule verbale. Un lexique d’IRaMuTeQ ne donne qu’une lecture par forme, et seul un étiquetage en contexte pourrait choisir la bonne. Ils gardent donc la même lecture que dans la v1. Comme ce sont des mots-outils, ils sont supplémentaires et n’influencent pas les classes.
Le lexique en chiffres
| v1 | v2 | |
|---|---|---|
| Formes (hors expressions) | 256 309 | 256 310 |
| Lemmes (hors expressions) | 11 837 | 11 844 |
| Fichier d’expressions | 3 738 lignes | identique |
Une seule forme de plus (deze), sept lemmes de plus : les pronoms ont gagné des lemmes lisibles, les verbes fusionnés en ont perdu. L’essentiel des changements ne se voit pas dans ces totaux : il porte sur la lecture des formes existantes.
Mesurer les changements avant d’ouvrir IRaMuTeQ
Avant de relancer IRaMuTeQ, il est utile de savoir ce qui a changé, et où. Un petit script compare les deux lexiques, puis mesure l’effet des différences sur le corpus de test. Il n’utilise que la bibliothèque standard de Python.
On commence par lire un lexique. Chaque ligne a la forme forme<TAB>lemme<TAB>catégorie ; on en fait un dictionnaire Python qui associe à chaque forme son couple (lemme, catégorie).
import argparse
import re
from collections import Counter

MOT = re.compile(r"[a-zà-ÿœæ_]+")


def charger_lexique(chemin):
    """Lit un lexique IRaMuTeQ : forme -> (lemme, catégorie)."""
    lexique = {}
    with open(chemin, encoding="utf-8") as f:
        for ligne in f:
            morceaux = ligne.rstrip("\n").split("\t")
            if len(morceaux) >= 3:
                lexique[morceaux[0]] = (morceaux[1], morceaux[2])
    return lexique
La comparaison elle-même repose sur des opérations d’ensembles : les formes présentes dans un seul des deux lexiques, et les formes communes dont la lecture diffère.
def comparer(v1, v2):
    """Formes ajoutées, retirées, et formes dont la lecture change."""
    ajoutees = sorted(set(v2) - set(v1))
    retirees = sorted(set(v1) - set(v2))
    changees = sorted(f for f in set(v1) & set(v2) if v1[f] != v2[f])
    return ajoutees, retirees, changees
Pour le corpus, on compte les occurrences de chaque forme, en laissant de côté les lignes étoilées (**** *texte_1) qui ne sont pas du texte. Le découpage est simplifié : IRaMuTeQ découpe un peu différemment, et ces chiffres ne remplacent pas les siens. Ils suffisent à voir où portent les changements.
def compter_occurrences(chemin):
    """Occurrences des formes du corpus, lignes étoilées exclues.
    Découpage simplifié : IRaMuTeQ découpe un peu différemment."""
    with open(chemin, encoding="utf-8") as f:
        lignes = [l for l in f if not l.startswith("****")]
    return Counter(MOT.findall("".join(lignes).lower()))


def occurrences_par_lemme(occ, lexique):
    """Total des occurrences par couple (lemme, catégorie)."""
    total = Counter()
    for forme, n in occ.items():
        if forme in lexique:
            total[lexique[forme]] += n
    return total
Il reste à afficher les résultats en trois temps : les différences entre lexiques, les formes du corpus dont la lecture change, et les lemmes concernés avant et après.
def main():
    p = argparse.ArgumentParser(description=__doc__)
    p.add_argument("lexique_v1")
    p.add_argument("lexique_v2")
    p.add_argument("corpus")
    args = p.parse_args()

    v1 = charger_lexique(args.lexique_v1)
    v2 = charger_lexique(args.lexique_v2)

    # 1. Différences entre les deux lexiques
    ajoutees, retirees, changees = comparer(v1, v2)
    print(f"Formes : v1 {len(v1)}, v2 {len(v2)}")
    print(f"Ajoutées : {', '.join(ajoutees) or 'aucune'}")
    print(f"Retirées : {', '.join(retirees) or 'aucune'}")
    print(f"Formes dont le lemme ou la catégorie change : {len(changees)}\n")
    types = Counter((v1[f], v2[f]) for f in changees)
    for (avant, apres), n in types.most_common(10):
        print(f"{n:5d}  {avant[0]} ({avant[1]}) -> {apres[0]} ({apres[1]})")

    # 2. Effet sur le corpus
    occ = compter_occurrences(args.corpus)
    touchees = {f: n for f, n in occ.items() if v1.get(f) != v2.get(f)}
    print(f"\nCorpus : {sum(occ.values())} occurrences, {len(occ)} formes")
    print(f"Lecture modifiée : {sum(touchees.values())} occurrences, "
          f"{len(touchees)} formes")
    for f, n in sorted(touchees.items(), key=lambda x: -x[1])[:15]:
        print(f"{n:5d}  {f:12s} v1 : {v1.get(f)}   v2 : {v2.get(f)}")

    # 3. Les lemmes concernés, avant et après
    t1 = occurrences_par_lemme(occ, v1)
    t2 = occurrences_par_lemme(occ, v2)
    print("\nLemme (catégorie)        v1     v2")
    for cle in sorted(set(t1) | set(t2)):
        if t1[cle] != t2[cle]:
            print(f"{cle[0] + ' (' + cle[1] + ')':22s} {t1[cle]:5d}  {t2[cle]:5d}")


if __name__ == "__main__":
    main()
On le lance avec les deux lexiques et le corpus de test préparé :
python3 comparer_lexiques.py ../Apertium2iramuteq-breton/dictionnaire/lexique_br.txt dictionnaire/lexique_br.txt corpus_test/corpus_test_breton.txt
Ce que montre la comparaison
Côté lexique, 475 formes changent de lemme ou de catégorie, et une forme est ajoutée (deze). Les plus nombreuses sont les conjugaisons fusionnées : 181 formes de gellout rattachées à gallout, 127 de gelver à gervel, 50 de monet à mont.
Côté corpus (11 109 occurrences selon ce découpage simplifié, à deux occurrences près celui d’IRaMuTeQ, qui compte aussi les nombres), 711 occurrences de 71 formes changent de lecture. Le tableau ci-dessous reprend les lemmes pleins concernés, c’est-à-dire ceux qui comptent dans les classifications :
| Lemme | v1 | v2 | Ce qui change |
|---|---|---|---|
| ket (adv → adv_sup) | 300 actives | 0 active | la négation devient supplémentaire |
| mont (aller) | 55 | 133 | absorbe les 78 occurrences de monet |
| gallout (pouvoir) | 91 | 146 | absorbe les 55 de gellout |
| lavaret (dire) | 42 | 86 | absorbe les 44 de lavarout |
| gervel (appeler) | 4 | 8 | absorbe les 4 de gelver |
| te (nom, thé) | 14 | 0 | te redevient le pronom « tu » |
| kaout (aux) | 256 | 261 | +5 deze |
Deux enseignements avant même d’ouvrir IRaMuTeQ. D’abord, la correction la plus lourde n’est pas celle qui a demandé le plus de travail : c’est ket, qui retire à lui seul 300 occurrences des formes actives, alors que toutes les autres corrections réunies modifient la lecture d’environ 200 occurrences actives. Ensuite, les fusions transforment trois verbes moyens en verbes parmi les plus fréquents du corpus : mont, gallout et lavaret ont maintenant une chance de caractériser une classe.
Les mêmes analyses dans IRaMuTeQ
Le corpus de test est ouvert deux fois, une fois avec chaque lexique, selon la méthode décrite dans l’article précédent. Les réglages sont identiques pour les deux versions :
| Réglage | Valeur |
|---|---|
| Logiciel | IRaMuTeQ 0.8 alpha 7, R 4.3.3 |
| Corpus | corpus_test/corpus_test_breton.txt, identique dans les deux dépôts |
| Encodage | utf-8 |
| Langue / dictionnaire | « autre » / « Autre » : lexique_br.txt de chaque version |
| Marqueur de texte | **** |
| Dictionnaire des expressions | décoché (les expressions sont déjà soudées) |
| Segments de texte | construits par occurrences, taille 40 (valeur par défaut) |
| Classification | méthode de Reinert, classification simple sur segments, 10 classes terminales en phase 1, formes actives de fréquence ≥ 3, suivie d’une AFC |
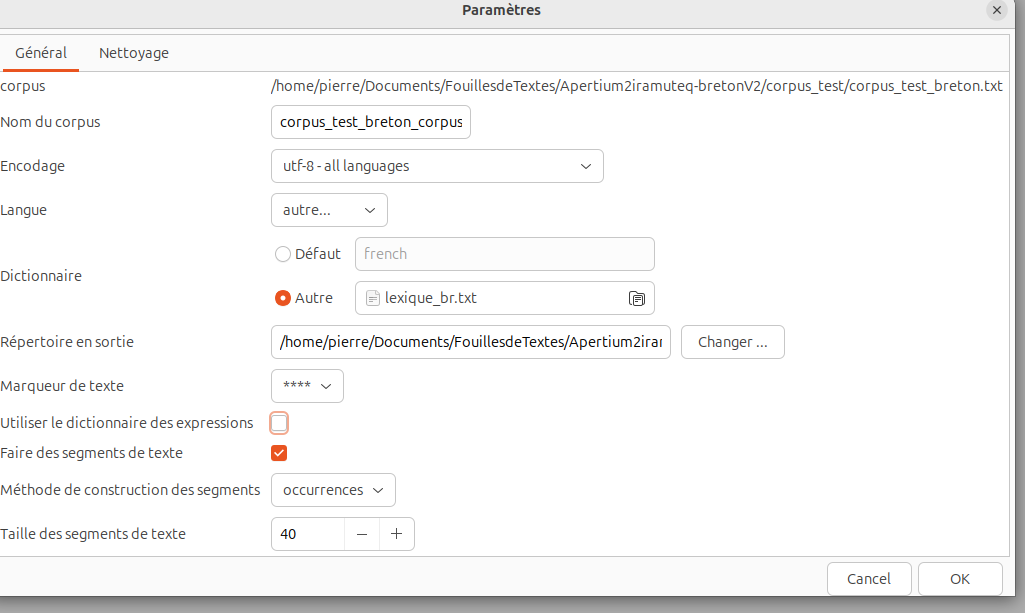
Pour la classification, les paramètres sont ceux proposés par défaut par IRaMuTeQ, identiques pour les deux versions : classification simple sur segments de texte, 10 classes terminales en phase 1, nombre minimum de segments par classe calculé automatiquement, formes actives de fréquence 3 au moins.
Un corpus identique pour les deux versions
Un point de méthode d’abord. Les chiffres publiés dans l’article précédent (332 segments, 11 827 occurrences, 1 159 formes après lemmatisation) ont été obtenus avec le premier état du dépôt v1, avant l’ajout des expressions soudées. Souder a viz here en a_viz_here retire deux occurrences mais ajoute une forme : le corpus de test actuel compte donc moins d’occurrences et plus de formes. Pour ne comparer que les dictionnaires, nous avons rouvert le corpus actuel, identique dans les deux dépôts, avec chacun des deux lexiques.
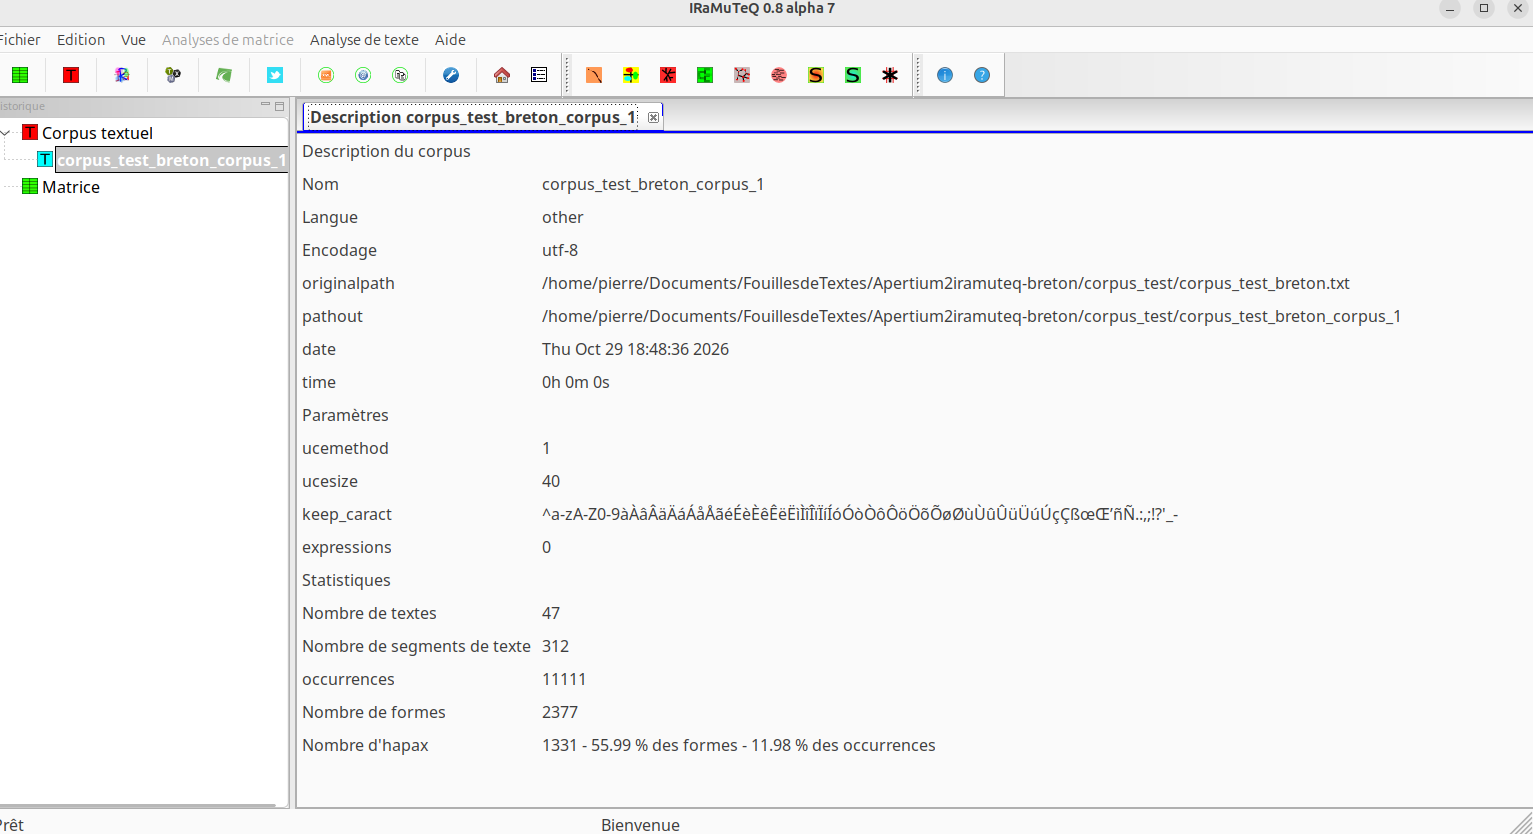
Avant lemmatisation, la description est la même pour les deux versions : 47 textes, 312 segments, 11 111 occurrences, 2 377 formes et 1 331 hapax.
Statistiques après lemmatisation
| v1 | v2 | |
|---|---|---|
| Formes après lemmatisation | 1 234 | 1 232 |
| Hapax | 566 (45,87 % des formes, 5,09 % des occurrences) | 566 (45,94 % des formes, 5,09 % des occurrences) |
| Première forme non reconnue | deze (5) | aostralia (4) : deze est reconnu |
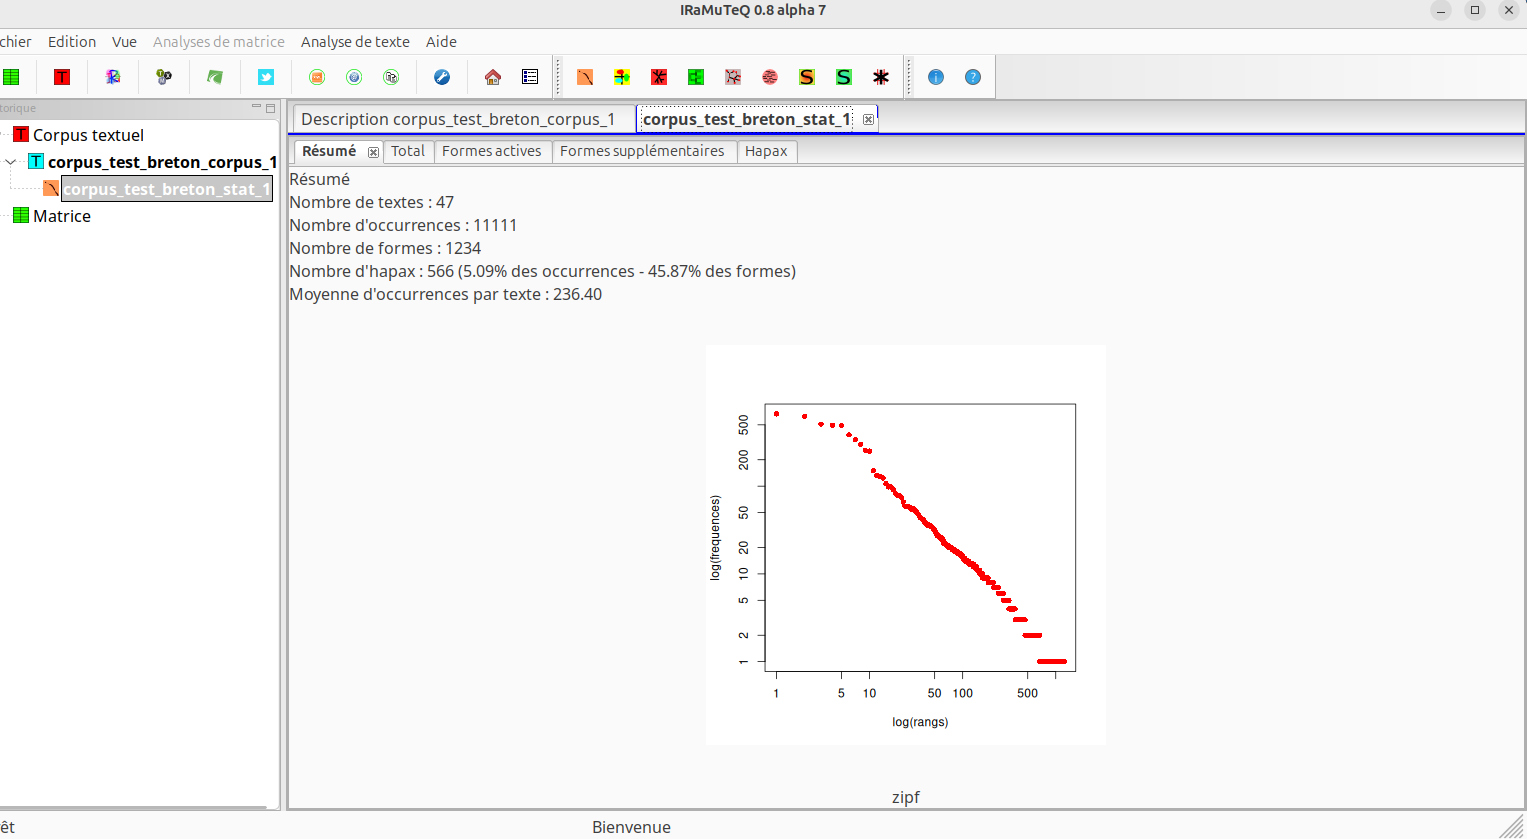
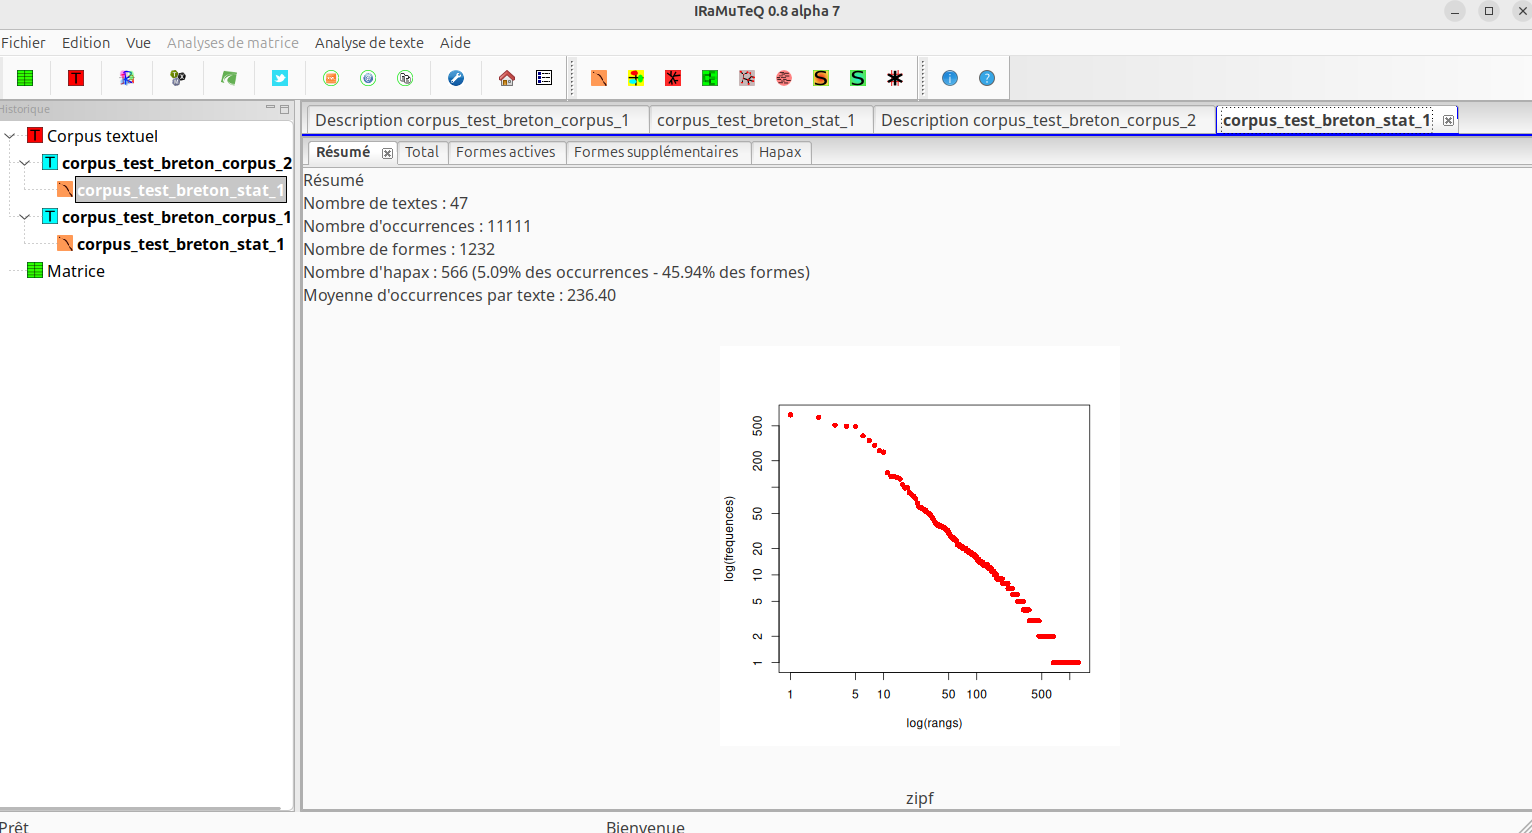
Les totaux bougent à peine : deux formes de moins, le même nombre de hapax. C’est attendu. Les fusions de verbes retirent quelques lemmes (monet, gellout, lavarout, gelver), mais les pronoms en gagnent, puisque prpers et direct se répartissent maintenant entre me, te, eñ, hi, ni, c’hwi et int. Et les formes fusionnées étant fréquentes, aucune n’était un hapax. Les corrections ne se voient pas dans les totaux : elles se voient dans la liste des formes actives.
Les formes actives les plus fréquentes
| Rang | v1 | v2 |
|---|---|---|
| 1 | ket 300 (adv) | ober 251 |
| 2 | ober 251 | gallout 146 |
| 3 | dont 107 | mont 133 |
| 4 | gallout 91 | dont 107 |
| 5 | gouzout 82 | lavaret 86 |
| 6 | monet 78 | gouzout 82 |
| 7 | gwelet 59 | gwelet 59 |
| 8 | komz 59 | komz 59 |
| 9 | debriñ 57 | debriñ 57 |
| 10 | mont 55 | chom 55 |
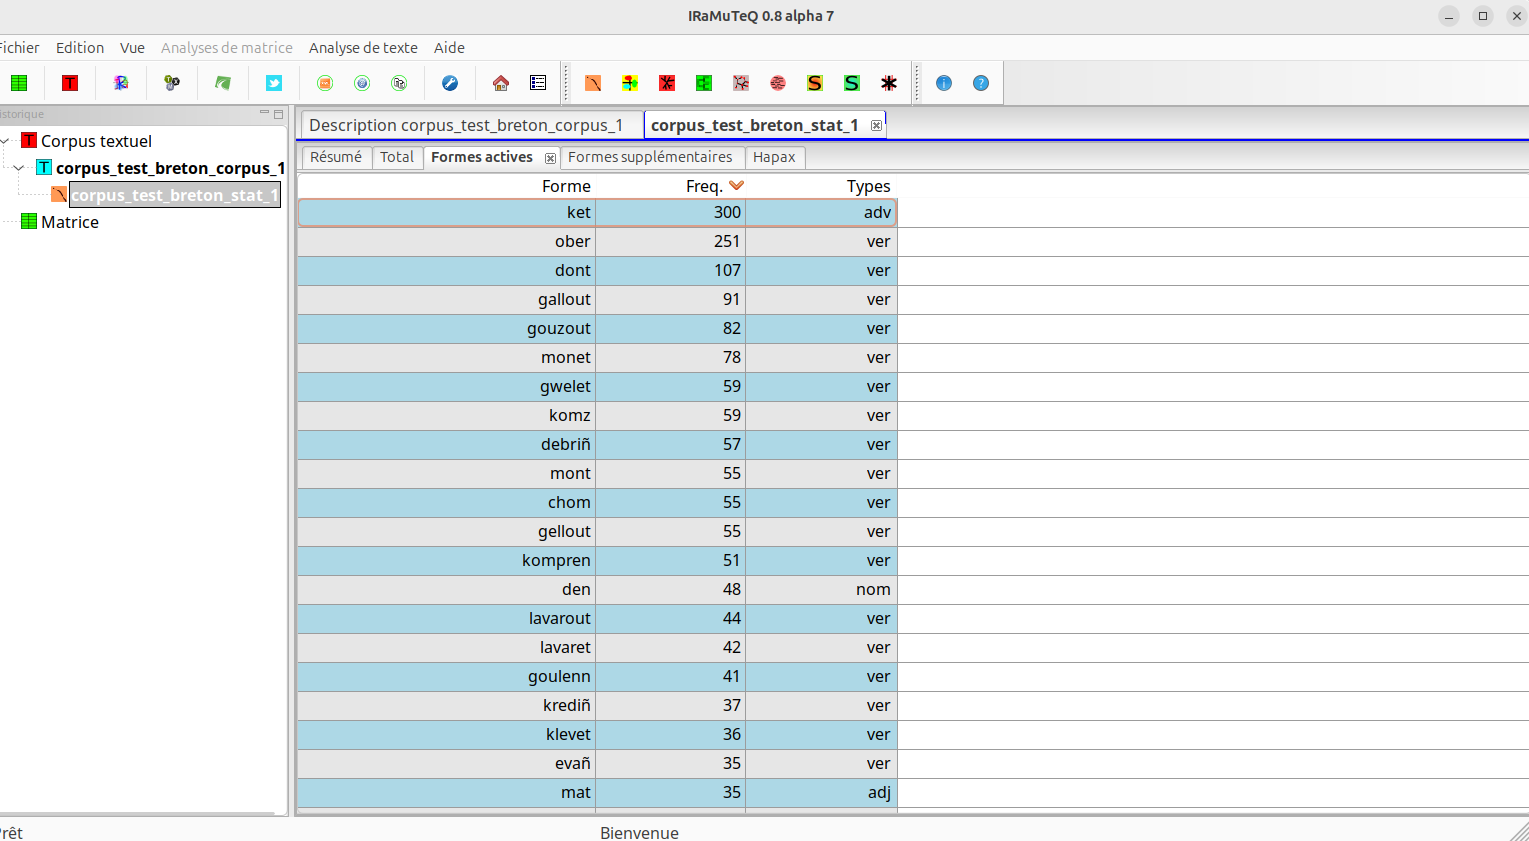
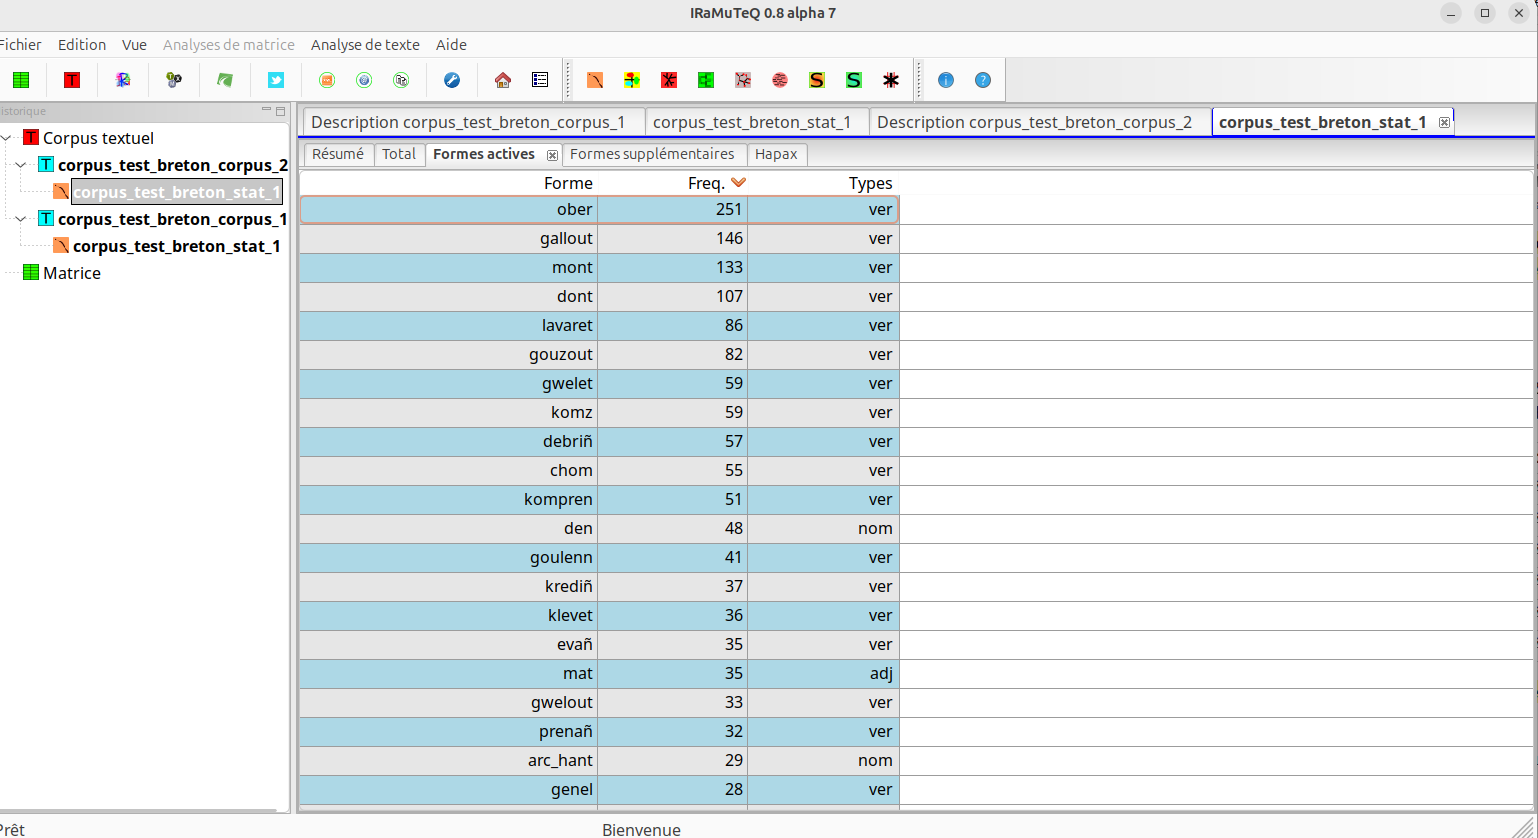
Ici, la différence saute aux yeux. Dans la v1, la négation ket est la forme active la plus fréquente du corpus, et trois verbes apparaissent deux fois : monet (78) et mont (55), gallout (91) et gellout (55), lavarout (44) et lavaret (42). Dans la v2, ket est passé dans les formes supplémentaires, et chaque verbe est réuni sous un seul lemme : gallout (146) et mont (133) montent aux 2e et 3e rangs, lavaret (86) au 5e. Ces fréquences sont exactement celles que le script de comparaison avait prévues.
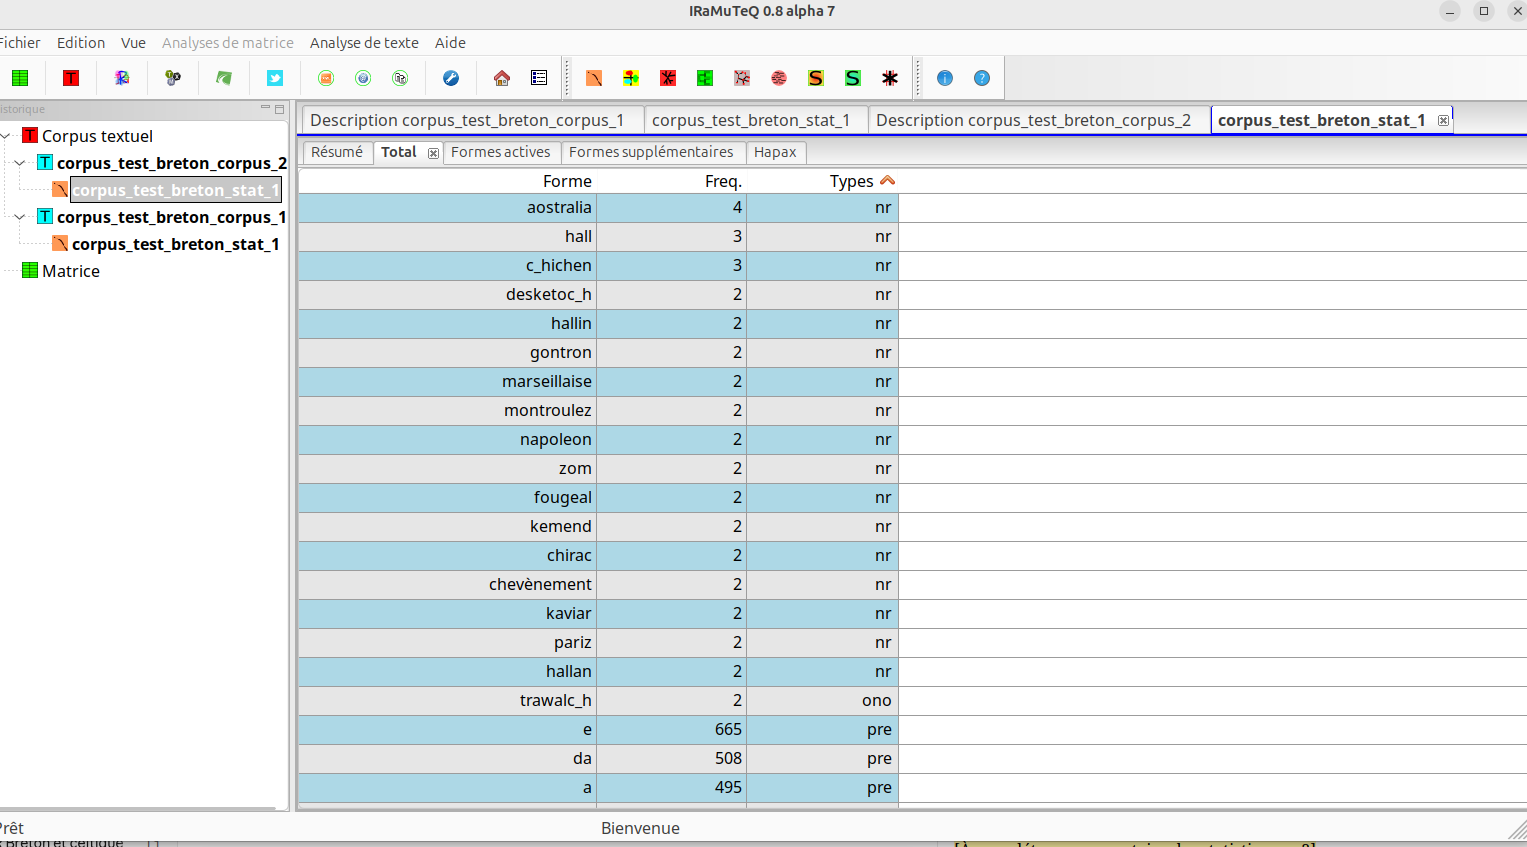
Dans les formes non reconnues, deze (5 occurrences), en tête dans la v1, a disparu de la liste v2. Il ne reste en tête que des noms propres (aostralia, montroulez, chirac…), que le dictionnaire, comme celui du français, ne contient pas.
Classification de Reinert
Les deux classifications retiennent un nombre de formes actives et une part de segments classés très proches. La différence est ailleurs : la v1 aboutit à cinq classes, la v2 à six.
| v1 | v2 | |
|---|---|---|
| Formes actives (fréquence ≥ 3) | 372 | 365 |
| Segments classés | 237 sur 312 (76,0 %) | 239 sur 312 (76,6 %) |
| Classes | 5 | 6 |
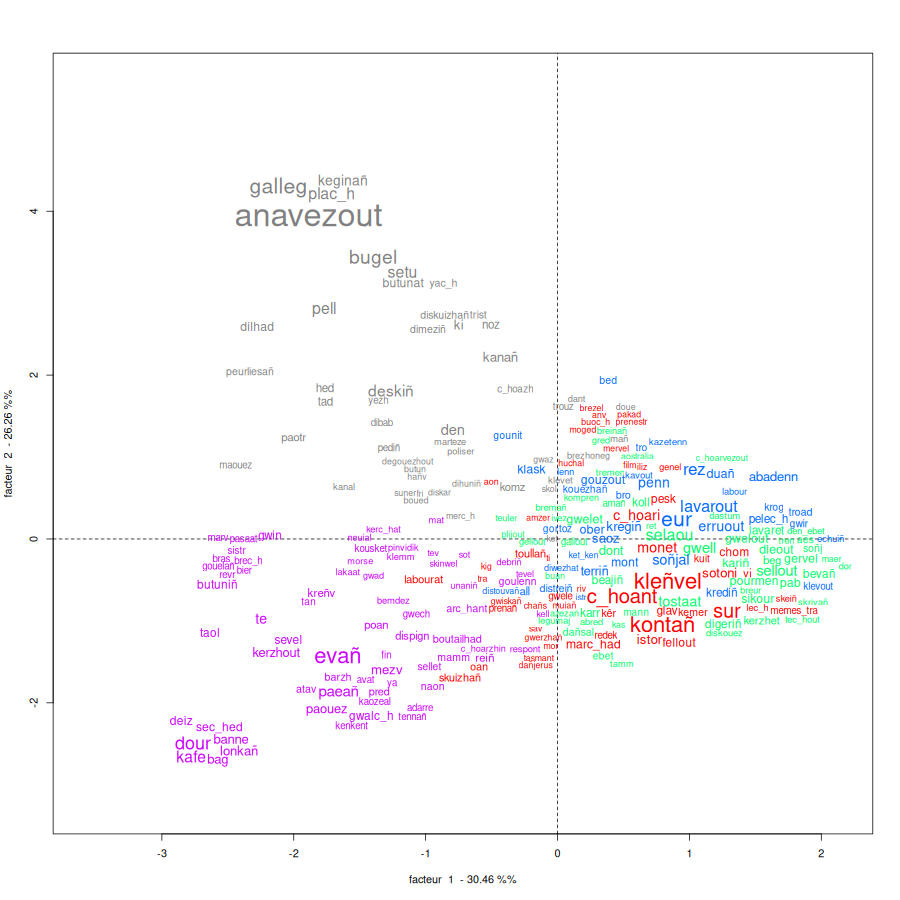
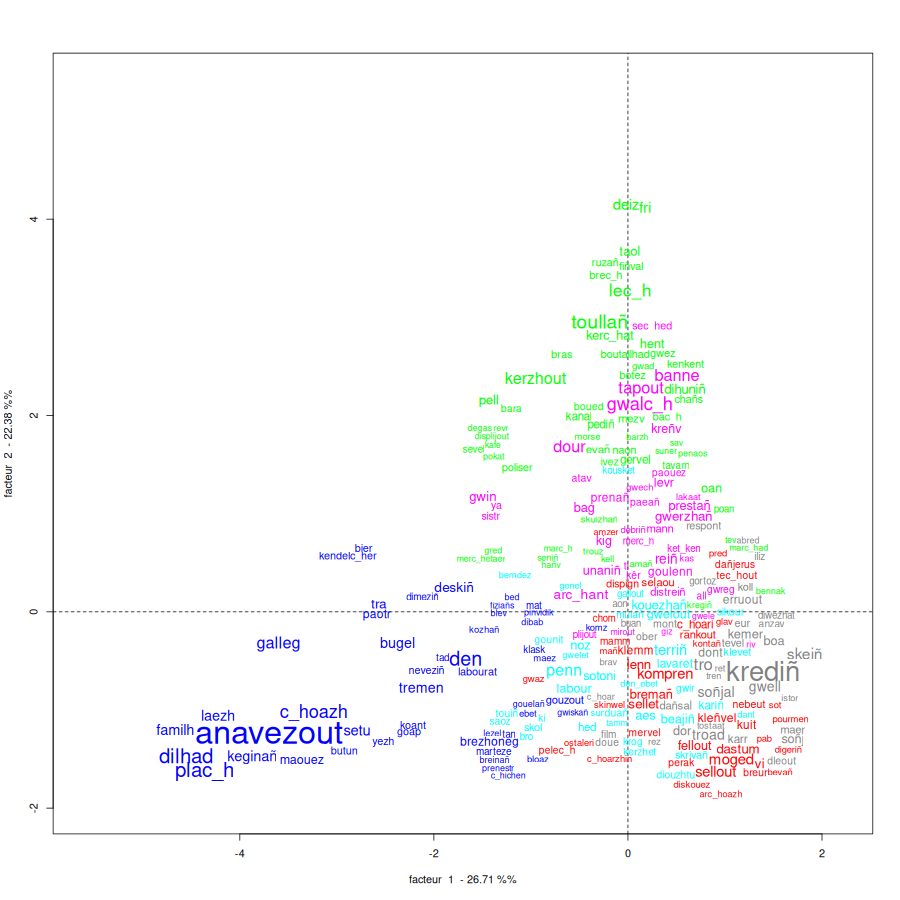
| Inertie des deux premiers facteurs de l’AFC | 30,5 % + 26,3 % = 56,7 % | 26,7 % + 22,4 % = 49,1 % |
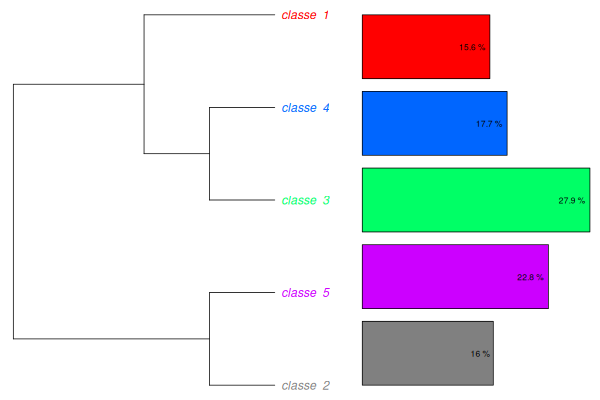
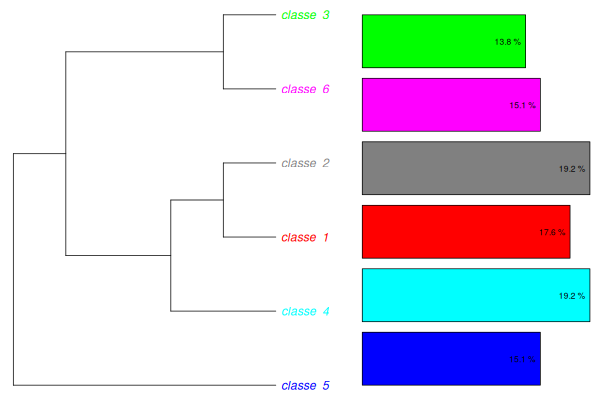
Le tableau suivant met en regard les classes des deux versions, rapprochées d’après leurs formes et leurs textes caractéristiques. Les numéros de classes sont attribués par IRaMuTeQ et ne se correspondent pas d’une version à l’autre.
| v1 | Formes caractéristiques v1 | v2 | Formes caractéristiques v2 |
|---|---|---|---|
| 2 (16,0 %) | anavezout, galleg, bugel, pell, setu, plac’h, deskiñ, den | 5 (15,1 %) | anavezout, dilhad, plac’h, den, c’hoazh, galleg, setu, familh, brezhoneg |
| 5 (22,8 %) | evañ, dour, kafe, paeañ, te, mezv, bag, lonkañ, banne | 6 (15,1 %) | gwalc’h, tapout, banne, dour, reiñ, arc’hant, gwerzhañ, gwin, prestañ |
| 3 (13,8 %) | toullañ, lec’h, kerzhout, deiz, fri, dihuniñ, pell, hent, evañ | ||
| 4 (17,7 %) | eur, rez, lavarout, soñjal, erruout, penn, ober, gouzout, mont, monet | 2 (19,2 %) | krediñ, tro, skeiñ, soñjal, troad, gwell, kemer, dont, erruout |
| 3 (27,9 %) | selaou, gwell, sellout, tostaat, dont, gwelet, dleout, kariñ, lavaret | 4 (19,2 %) | penn, terriñ, kouezhañ, noz, sotoni, gwelout, lavaret, klevet, skol, skrivañ |
| 1 (15,6 %) | kleñvel, kontañ, c’hoant, sur, monet, c’hoari, sotoni, istor | 1 (17,6 %) | moged, kompren, sellout, lenn, sellet, bremañ, fellout, kleñvel |
Plusieurs observations ressortent de cette comparaison.
- Une classe stable. La classe de la famille et des langues (anavezout, galleg, bugel, plac’h, textes 3 à 8) se retrouve presque à l’identique. C’est la plus nette des deux analyses : dans la v2, elle se sépare la première dans le dendrogramme et occupe seule le côté gauche du premier axe de l’AFC. Une classe qui résiste à un changement de dictionnaire est un résultat solide.
- Le « thé » disparaît. Dans la v1, te caractérisait la classe du boire et du manger (8 segments sur 11), comme s’il s’agissait du thé ; c’était presque toujours le pronom « tu ». Dans la v2, il n’apparaît plus parmi les formes actives. Cette classe se partage maintenant en deux : l’argent, l’achat et la boisson (classe 6 : arc’hant, gwerzhañ, prestañ, gwin) d’un côté, les déplacements et les moments de la journée (classe 3 : kerzhout, hent, deiz, dihuniñ) de l’autre.
- lavaret trouve sa place. Dans la v1, le verbe « dire » était partagé : lavarout caractérisait la classe 4, lavaret les classes 3 et 4. Réuni, lavaret caractérise nettement une seule classe dans la v2 (classe 4, χ² 10,1), aux côtés de klevet (entendre), skol et skrivañ (école, écrire).
- mont et gallout restent dispersés. On aurait pu attendre de ces verbes, désormais parmi les plus fréquents, qu’ils caractérisent une classe. Ce n’est pas le cas : mont (aller) et gallout (pouvoir) apparaissent faiblement dans trois classes chacun. Ce sont des verbes généraux, employés partout ; la fusion corrige leur fréquence, elle ne les rend pas plus spécifiques. C’est plutôt rassurant : la v1 leur faisait jouer un rôle, monet figurant parmi les formes de la classe 1, que le lemme réuni ne confirme pas.
- Une classe de la v1 se dissout. La classe 1 de la v1 (kleñvel, kontañ, c’hoant, textes 22, 10 et 39) n’a pas d’équivalent dans la v2 : ses formes se répartissent entre les classes 1 et 2, et le texte 22, celui des phrases en pa, ne caractérise plus aucune classe. En revanche krediñ (croire) devient la forme la plus caractéristique de la classe 2 (χ² 55,6), avec soñjal (penser) : la classe « parole et pensée » est plus nette.
- ket passe en forme supplémentaire. Dans la v1, ses 300 occurrences actives ne caractérisaient aucune classe : réparties partout, elles ne pouvaient que brouiller le calcul. Dans la v2, ket apparaît parmi les formes supplémentaires des classes 1 et 3, comme ne, sans peser sur la classification.
Une précaution s’impose : la classification de Reinert est sensible aux petites variations. Retirer une forme très fréquente comme ket et en regrouper quelques autres suffit à déplacer des segments d’une classe à l’autre, et donc à changer le nombre de classes. Toutes les différences ne sont pas des améliorations : il faut les lire classe par classe, comme ci-dessus, en revenant aux formes et aux textes.
Analyse factorielle des correspondances
Dans la v1, les deux premiers facteurs expliquent 56,7 % de l’inertie. Le premier axe oppose la classe du boire et du manger et la classe de la famille (à gauche) aux trois autres ; le second isole la classe de la famille et des langues (en haut).
Dans la v2, les deux premiers facteurs expliquent 49,1 % de l’inertie, l’information étant répartie sur six classes au lieu de cinq. Le premier axe isole la classe de la famille et des langues (à gauche) ; le second sépare les classes du boire, de l’argent et des déplacements (en haut) des classes de la parole, de la pensée et de la perception (en bas).
Ce qu’il faut retenir
- Corriger un dictionnaire, c’est d’abord trouver la cause d’une erreur, pas seulement son symptôme : le cas de kaout l’a montré, avec un premier diagnostic faux et une correction abandonnée parce qu’elle créait d’autres erreurs.
- Toutes les corrections n’ont pas le même poids. Une seule étiquette (ket) touche plus d’occurrences actives que toutes les autres corrections réunies.
- Comparer deux lexiques sur un corpus, avant toute analyse statistique, permet de savoir ce que l’on va mesurer, et de vérifier qu’une règle raisonnable sur le papier ne crée pas d’erreurs sur un texte réel.
- Un meilleur lemme ne fait pas forcément une meilleure classe : réunir mont et monet donne la bonne fréquence d’« aller », mais ce verbe reste trop général pour caractériser un thème. Les gains se lisent surtout dans ce qui disparaît (te lu comme « thé », ket actif) et dans les lemmes qui retrouvent une place nette, comme lavaret.
- Un lexique sans contexte a des limites qu’aucune table ne lèvera : ma, o et e resteront ambigus tant qu’on n’étiquettera pas les textes en contexte.
Le dictionnaire est maintenant prêt pour le prochain article de la série : comparer les sujets traités sur le numérique par les Wikipédia bretonne et française, à partir des corpus constitués dans le premier article.
Le code et le dictionnaire de la version 2 sont disponibles sur GitHub : Anakeyn/Apertium2iramuteq-bretonV2. Le dictionnaire est dérivé d’apertium-bre et distribué, comme lui, sous licence GNU GPL version 3.