Partager la publication "Le numérique vu par Wikipédia en breton et en français : comparer deux corpus avec IRaMuTeQ"
Introduction
De quoi parlent les contributeurs de Wikipédia en breton quand ils parlent de numérique ? Les mêmes sujets sont-ils abordés en français, ou y a-t-il des particularismes locaux ?
Pour y répondre, nous avons repris IRaMuTeQ, le logiciel libre d’analyse de textes que nous utilisons depuis le début de cette série, et en particulier sa classification de Reinert, qui fait émerger les thèmes d’un corpus à partir de son vocabulaire.
C’est le cinquième article de la série « IRaMuTeQ et Wikipédia », et celui qui utilise ou plutôt devait utiliser les outils construits dans les précédents :
- wiki2iramuteq, un script Python qui extrait des articles de Wikipédia au format d’IRaMuTeQ ;
- le dictionnaire breton pour IRaMuTeQ tiré d’Apertium version 2.
En effet, nous pensions au départ utiliser ces outils directement sur nos corpus.
Mais il s’est avéré, après un premier test du corpus breton issu de Wikipedia avec le dictionnaire version 2 que ce dernier comportait encore des erreurs que nous n’avions pas vu avec le corpus de test d’Apertium
Ceci nous a conduit à créer une version 3, du dictionnaire, présentée dans la section 3.
Nous avons aussi été obligés de revoir plusieurs choix en cours de route : des articles écartés après coup, un terme de recherche oublié, une classe qui apparaît ou disparaît selon un réglage. Nous avons préféré raconter ces détours plutôt que de les cacher : ils font partie de la méthode, et vous les rencontrerez sans doute aussi.
Tout le matériel dont vous aurez besoin se trouve dans le dépôt GitHub wiki-numerique-br-fr-iramuteq : corpus prêts à ouvrir dans IRaMuTeQ, scripts, listes d’exclusion et résultats. Vous pouvez reproduire les analyses sans taper une seule commande en récupérant les fichiers. Le dictionnaire est dans le dépôt Apertium2iramuteq-bretonV3, et aussi dans le dépôt wiki-numerique-br-fr-iramuteq.
La démarche en résumé : nous commençons par constituer des corpus comparables dans les deux langues (section 1), puis nous jetons un premier regard sur ces corpus avec quelques lignes de Python, sans IRaMuTeQ (section 2). Nous préparons ensuite l’analyse et corrigeons le dictionnaire breton (section 3), avant de classer le corpus breton (section 4), puis les mêmes sujets en français, pour les comparer (section 5). Nous terminons par ce que nous avons appris, et par les limites de la démarche (section 6).
1. Constituer des corpus comparables
Comparer deux Wikipédia, c’est d’abord décider de ce que l’on compare. Wikipédia en français compte plus de deux millions et demi d’articles, Wikipédia en breton moins de 100 000 : comparer les deux encyclopédies entières n’aurait pas grand sens. Nous nous sommes donc limités à un thème, le numérique, en gardant à l’esprit cette énorme différence de taille.
Chercher par termes plutôt que par catégories
Dans les articles précédents, nous avions travaillé sur la catégorie « Humanités numériques » de Wikipédia en français. Nous comptions faire de même avec le breton.
Malheureusement cette catégorie n’existe pas en breton, et plus généralement, les arbres de catégories des deux Wikipédia sont trop différents pour être comparés : Wikipédia en breton en a peu, et l’équivalent breton d’une catégorie française est souvent absent ou presque vide.
Nous avons donc utilisé le mode recherche de wiki2iramuteq, qui garde les articles contenant certains termes, quelle que soit leur catégorie. Voici les termes du numérique que nous avons retenus :
| Langue | Termes de recherche |
|---|---|
| Breton | stlenneg (informatique), urzhiataer (ordinateur), kenrouedad et genrouedad (internet), niverel (numérique), meziant frank et meziantoù frank (logiciel libre) |
| Français | informatique, ordinateur, internet, numérique, logiciel libre |
En breton, il faut aussi donner les formes mutées : Kenrouedad (internet) devient ar Genrouedad (« l’internet »), car la recherche de Wikipédia ne sait pas regrouper les mutations.
Il faut enfin penser aux synonymes, et nous en avons oublié un. Le breton a deux mots pour « logiciel » : meziant et poellad. Meziant est le plus courant dans notre corpus (44 occurrences, contre 20), mais l’article breton sur le logiciel libre s’intitule justement Poellad frank ! Nous ne nous en sommes aperçus qu’en toute fin en relisant cet article.
Une recherche de contrôle sur poellad frank ramène deux articles absents du corpus : Richard Stallman et Tux, la mascotte de Linux. Avec environ 900 mots, un peu plus de 1 % du corpus breton, ils ne changeraient pas sensiblement les résultats, et nous avons décidé de garder le corpus tel quel. plutôt que de recommencer tout le travail. Mais la leçon vaut pour toute recherche en breton (et dans d’autres langues) : il faut penser aux mutations et aux synonymes.
Partir du breton, puis prendre les articles français correspondants
Une première idée serait de lancer la même recherche dans les deux langues et de comparer les deux corpus obtenus. Mais les termes ne donnent pas les mêmes résultats d’une langue à l’autre, et la recherche française, beaucoup plus abondante, aurait dû être plafonnée (nous y revenons plus bas). Les deux corpus n’auraient donc pas porté sur les mêmes sujets : leurs différences seraient venues autant de notre façon de chercher que du contenu des encyclopédies.
Nous avons donc défini le périmètre une seule fois, à partir du breton. Nous avons ensuite récupéré la version française de chaque article breton retenu, grâce aux liens entre langues de Wikipédia : c’est le rôle du mode --aligner de wiki2iramuteq. Chaque article français reçoit le même identifiant *id_ que son article breton, ce qui nous permettra de rapprocher les résultats des deux analyses.
Nous avons aussi gardé les articles bretons qui n’ont pas d’équivalent français, car ils montrent ce qui n’intéresse que les contributeurs bretonnants. La variable *equiv_fr_oui ou *equiv_fr_non, ajoutée par l’option --marquer fr, permet de les repérer.
Attention toutefois : wiki2iramuteq calcule à partir des liens interlangues de l’article Wikipédia en breton. La liste des autres langues tirée de Wikidata. « Sans équivalent » veut donc dire « sans lien vers un article français », ce qui ne veut pas dire que les articles équivalents n’existent pas , c’est juste qu’ils n’ont pas été reliés, comme nous le verrons dans la section 4.
Nous avons fait l’extraction bretonne le 20 octobre 2026 :
python3 wiki2iramuteq.py --lang br \
    --recherche "stlenneg,urzhiataer,kenrouedad,genrouedad,niverel,meziant frank,meziantoù frank" \
    --marquer fr --nom numerique --contact "votre@courriel" --sortie ./brut/num_br
Après le filtrage décrit plus bas, nous avons récupéré les versions françaises le 30 octobre 2026 :
python3 wiki2iramuteq.py --lang fr \
    --aligner ./corpus/br/wikipedia_br_numerique_filtre_metadonnees.csv \
    --recherche "informatique,ordinateur,internet,numérique,logiciel libre" \
    --contact "votre@courriel" --sortie ./corpus/paires
Les termes de recherche ne servent ici qu’à calculer la variable *terme_ des articles français, c’est-à-dire le terme le plus fréquent dans l’article : tous les articles alignés sont gardés.
Wikipédia évolue tous les jours : une nouvelle extraction donnerait des résultats proches, mais pas identiques. Si vous voulez repartir exactement des mêmes textes, prenez les corpus du dépôt.
Filtrer avec la même règle dans les deux langues
La recherche bretonne ramène 190 articles, et tous ne parlent pas de numérique. Le script filtrer_corpus.py, repris de wiki2iramuteq avec un petit ajout, écarte d’abord ceux où les termes de recherche sont trop rares, moins de 2 occurrences pour 1 000 mots. Pour le reste, il faut trier à la main.
C’est là que la comparaison peut être faussée sans qu’on s’en aperçoive. Si nous sommes plus tolérants dans une langue que dans l’autre, les différences entre les corpus viendront de notre tri, et non des encyclopédies. Nous nous sommes donc fixé une règle commune :
Nous écartons un article quand son sujet n’est pas le numérique, même s’il lui consacre une section.
Cette règle, nous ne l’avions pas appliquée d’emblée. Côté français, nous avions écarté Photographie, Télévision ou Cartographie, alors que notre premier tri breton gardait leurs équivalents. En reprenant le corpus breton, nous avons donc écarté aussi Luc’hskeudennerezh, Skinwel, Kartennouriezh…, ainsi que les articles qui ne citent le numérique que de façon anecdotique : des siècles (XXvet kantved), des préfixes du système international (Kilo-, Mega, Giga), le jeu de go, des langues…
Restaient les faux amis, où le terme de recherche est pris dans un autre sens : niverel au sens des nombres, ou kenrouedad au sens de « réseau non informatique ». C’est ainsi que Kenstroll, un réseau de librairies bretonnes, s’était glissé dans le corpus ! Nous avons enfin écarté la fonction mathématique (Kevreizhenn), comme Fonction numérique en français.
À l’inverse, nous avons gardé, dans les deux langues, ce qui parle de la place du numérique dans la culture : Terminator (robotoù), Skynet, Battlestar Galactica, le festival Scopitone, ou l’Agence Bretagne Presse, agence de presse née sur le Web.
Les listes d’exclusion sont dans des fichiers texte, un titre par ligne, et une option que nous avons ajoutée à filtrer_corpus.py les lit directement :
python3 filtrer_corpus.py brut/num_br/wikipedia_br_numerique_metadonnees.csv --min-densite 2 \
    --exclure @corpus/br/exclure.txt --garder @corpus/br/garder.txt
Au bout du compte, il reste 121 articles bretons sur 190, environ 78 000 mots. 109 ont un lien vers un article français, 12 n’en ont pas. Parmi ces derniers figurent Treiñ e brezhoneg (traduire en breton) et Raktres Translate (brezhoneg), le projet translate.bzh, qui rassemble des textes et des enregistrements en breton pour outiller la traduction automatique. Mais on y trouve aussi Skoroù treuzkas (supports de transmission) et OSI, dont Wikipédia en français a pourtant l’équivalent : les contributeurs n’ont simplement jamais relié les deux articles.
Un corpus français de contexte, qui n’est qu’un échantillon
Partir du breton a un prix : nous ne voyons que les sujets choisis par les contributeurs bretons. Ce que Wikipédia en français traite et que Wikipédia en breton ignore reste hors champ.
Pour en avoir au moins un ordre de grandeur, nous avons aussi extrait un corpus français à partir de sa propre recherche, avec les cinq termes français. Nous l’avons nettoyé avec la même règle, en écartant 73 articles à la main : surtout des pages d’homonymie, des articles où numérique est pris au sens des nombres (Analyse numérique, et même Infériorité numérique, au sens sportif) et des articles hors sujet. Il compte 1 159 articles et 2,34 millions de mots.
Ce corpus n’est pas comparable au corpus breton, pour une raison technique. En breton, la recherche ramène sans doute presque tout ce qui contient nos termes (jusqu’à 2 000 résultats par terme). En français, nous avons dû la limiter à 500 résultats par terme, sinon le corpus aurait été énorme. Le corpus français n’est donc qu’un échantillon : les 500 articles que le moteur de Wikipédia juge les plus pertinents pour chaque terme. Nous le vérifierons plus loin : 54 versions françaises des paires, comme Unix ou Bitcoin, n’ont jamais été ramenées par la recherche française.
Nous n’avons donc pas fait de classification sur ce corpus : il sert seulement aux statistiques descriptives de la section 2.
Les fichiers prêts à l’emploi
Le dépôt contient tous les corpus, déjà filtrés et préparés :
| Fichier | Contenu | Articles |
|---|---|---|
corpus/br/wikipedia_br_numerique_pret.txt |
Analyse 1 : corpus breton, préparé pour le dictionnaire breton | 121 |
corpus/paires/wikipedia_fr_aligne_sur_br_numerique_filtre.txt |
Analyse 2 : versions françaises des articles bretons qui ont un équivalent | 109 |
corpus/fr/wikipedia_fr_numerique_nettoye.txt |
Contexte : échantillon de Wikipédia en français sur le numérique | 1 159 |
dictionnaire/lexique_br.txt |
Dictionnaire breton pour IRaMuTeQ, version 3 |
Pour récupérer un fichier sur GitHub, cliquez dessus, puis sur Download raw file. Pour tout récupérer : Code → Download ZIP.
Voici à quoi ressemble le début du corpus breton, au format d’IRaMuTeQ. Chaque article commence par une ligne étoilée qui porte ses variables :
**** *art_Kenrouedad *id_Kenrouedad *cat_recherche *prof_0 *terme_genrouedad *equiv_fr_oui *lang_br
Ar Genrouedad, pe Internet, zo ur rouedad urzhiataerel bedel. Diazezet eo war daou gomenad kehentiñ, TCP (Transmission Control Protocol) hag IP (Internet Protocol) lakaet asambles dindan an anv TCP/IP. Implijet e vez evit dispakañ meur_a servij war skramm evel al lizheroù elektronek ("posteloù" e brezhoneg) hag ar World Wide Web.
On y voit déjà une trace de la préparation pour le dictionnaire : meur a (« plusieurs ») est soudé en meur_a. Nous y revenons dans la section 3.
2. Un premier regard, sans IRaMuTeQ
Avant de lancer des analyses, nous avons voulu connaître la forme de nos corpus : combien d’articles, de quelle longueur, ramenés par quels termes. Quelques lignes de Python suffisent. Le script comparer_corpus.py du dépôt est découpé en neuf blocs # %%. Dans Spyder ou VS Code, chaque bloc s’exécute à part (Ctrl+Entrée dans Spyder), ce qui permet de regarder les résultats au fur et à mesure, comme nous le faisons ici.
Le script comparer_corpus.pya besoin de trois bibliothèques :
pip install pandas matplotlib tabulate
Blocs 1 et 2 : lire un corpus IRaMuTeQ
Le premier bloc déclare les chemins des fichiers ; le second lit un corpus et en fait un tableau, avec une ligne par article.
# %% 1. Chemins et bibliothèques
import re
from pathlib import Path

import matplotlib.pyplot as plt
import pandas as pd

ICI = Path(__file__).resolve().parent
CORPUS = {
    "br": ICI / "corpus/br/wikipedia_br_numerique_filtre.txt",
    "fr": ICI / "corpus/fr/wikipedia_fr_numerique_nettoye.txt",
}
PAIRES = {
    "br": ICI / "corpus/paires/wikipedia_br_numerique_filtre_aligne_sur_fr.txt",
    "fr": ICI / "corpus/paires/wikipedia_fr_aligne_sur_br_numerique_filtre.txt",
}
SORTIE = ICI / "resultats"
SORTIE.mkdir(exist_ok=True)

MOT = re.compile(r"\w+(?:['’]\w+)*")  # garde « c'hoari » d'un seul tenant
L’expression régulière MOT définit ce qu’est un mot pour le comptage : une suite de lettres ou de chiffres, éventuellement reliée par une apostrophe. Sans elle, c’hoari compterait pour deux mots, et les articles bretons paraîtraient plus longs qu’ils ne sont.
Nous comptons les mots sur les corpus tels qu’ils sortent du filtrage (les fichiers _filtre), avant la préparation du texte breton pour IRaMuTeQ, que nous verrons à la section 3. Cette préparation ne concerne que le breton : elle soude par exemple certains mots-outils à trait d’union (e-barzh, « dedans »), alors que le corpus français n’est pas transformé. Compter après elle aurait donc faussé la comparaison des longueurs. Avant préparation, les deux langues sont traitées de la même façon : notre comptage coupe les mots au trait d’union, et chou-fleur compte pour deux mots, comme e-barzh.
La fonction lire_corpus parcourt le fichier ligne par ligne. Une ligne qui commence par **** ouvre un nouvel article, dont elle découpe les variables : *equiv_fr_oui devient la colonne equiv, de valeur fr_oui. Les lignes suivantes forment le texte de l’article, dont on compte les mots.
# %% 2. Lire un corpus IRaMuTeQ : une ligne par article
def lire_corpus(chemin):
    """Renvoie un DataFrame : variables étoilées + nombre de mots du texte."""
    articles, courant = [], None
    for ligne in chemin.read_text(encoding="utf-8").splitlines():
        if ligne.startswith("****"):
            courant = {"texte": []}
            for var in ligne.split()[1:]:            # « *equiv_fr_oui »
                nom, _, modalite = var[1:].partition("_")
                courant[nom] = modalite              # equiv -> « fr_oui »
            articles.append(courant)
        elif courant is not None:
            courant["texte"].append(ligne)
    for a in articles:
        a["mots"] = len(MOT.findall(" ".join(a.pop("texte"))))
    return pd.DataFrame(articles)


tables = []
for lang, chemin in CORPUS.items():
    d = lire_corpus(chemin)
    d["langue"] = lang
    # titres exacts (accents, apostrophes) pris dans le fichier de métadonnées
    meta = pd.read_csv(chemin.with_name(chemin.stem + "_metadonnees.csv"))
    d = d.merge(meta[["id", "titre"]], on="id", how="left")
    # « fr_oui » -> « oui » : la langue de l'équivalent est l'autre langue
    d["equivalent"] = d["equiv"].str.rsplit("_", n=1).str[-1]
    tables.append(d)
articles = pd.concat(tables, ignore_index=True)
articles.drop(columns=["equiv"]).to_csv(SORTIE / "comparaison_corpus.csv", index=False)
Les deux corpus sont ensuite réunis dans un seul tableau, articles, avec une colonne langue. Il est enregistré dans resultats/comparaison_corpus.csv, que vous pouvez ouvrir dans un tableur.
Bloc 3 : la taille des corpus
# %% 3. Taille des deux corpus
taille = articles.groupby("langue").agg(
    articles=("id", "count"),
    mots=("mots", "sum"),
    mediane=("mots", "median"),
    moyenne=("mots", "mean"),
).round(0).astype(int)
print("Taille des corpus\n", taille, "\n")
| Langue | Articles | Mots | Médiane | Moyenne |
|---|---|---|---|---|
| br | 121 | 77 951 | 419 | 644 |
| fr | 1 159 | 2 342 607 | 1 164 | 2 021 |
Le corpus français compte près de dix fois plus d’articles et trente fois plus de mots. Un article breton typique fait environ 400 mots, soit une page. Dans les deux langues, la moyenne dépasse nettement la médiane, car quelques articles très longs la tirent vers le haut. C’est pourquoi nous regardons plutôt la médiane : si l’on range les articles du plus court au plus long, c’est la longueur de celui qui se trouve au milieu de la liste. La moitié des articles sont plus courts, l’autre moitié plus longs, et quelques articles très longs ne la déplacent pas.
Bloc 4 : qui a un équivalent dans l’autre langue ?
# %% 4. Part des articles qui ont un équivalent dans l'autre langue
equiv = pd.crosstab(articles["langue"], articles["equivalent"], margins=True,
                    margins_name="total")
equiv["% avec équivalent"] = (100 * equiv["oui"] / equiv["total"]).round(1)
print("Articles avec un équivalent dans l'autre Wikipédia\n", equiv, "\n")
| Langue | Sans équivalent | Avec équivalent | Total | % avec équivalent |
|---|---|---|---|---|
| br | 12 | 109 | 121 | 90,1 |
| fr | 1 057 | 102 | 1 159 | 8,8 |
L’asymétrie saute aux yeux. Neuf articles bretons sur dix ont un équivalent en français, mais moins d’un article français sur dix en a un en breton. Sur le numérique, Wikipédia en breton traite donc surtout des sujets que Wikipédia en français traite aussi. Y a-t-il malgré tout des thèmes propres au breton ? C’est ce que nous chercherons avec les classifications.
Attention, ces deux chiffres, 109 et 102, ne comptent pas les mêmes paires vues des deux côtés : ils portent sur deux corpus différents. 109 articles du corpus breton ont un lien vers le français, 102 articles du corpus français un lien vers le breton, mais seuls 50 articles sont communs aux deux listes. D’un côté, 59 des 109 versions françaises ne sont pas dans le corpus français : la recherche française, plafonnée, ne les a pas ramenées, ou le filtre les a écartées (bloc 8). De l’autre, 52 des 102 articles français ont une version bretonne absente de notre corpus breton : Algorithme, Adresse IP, Android, Bill Gates, ChatGPT, Google… Ces articles existent bien en breton, mais ils n’emploient pas, ou trop peu, nos termes de recherche.
Notre corpus breton n’est donc pas « tout ce que Wikipédia en breton dit du numérique », mais l’ensemble des articles qui en parlent avec nos mots-clés. Un article breton sur ChatGPT qui ne dit ni stlenneg, ni urzhiataer, ni niverel passe entre les mailles du filet.
Bloc 5 : quels termes ont ramené les articles ?
La variable *terme_ indique le terme de recherche le plus fréquent dans chaque article.
# %% 5. Termes de recherche qui ont ramené les articles
termes = (articles.groupby(["langue", "terme"]).size()
          .rename("articles").reset_index()
          .sort_values(["langue", "articles"], ascending=[True, False]))
print("Articles par terme de recherche\n", termes.to_string(index=False), "\n")
| Terme français le plus fréquent | Articles | Terme breton le plus fréquent | Articles |
|---|---|---|---|
| ordinateur | 308 | urzhiataer | 65 |
| informatique | 231 | stlenneg | 28 |
| numérique | 334 | niverel | 18 |
| internet | 258 | genrouedad / kenrouedad | 9 + 1 |
| logiciel libre | 28 | meziant frank / meziantoù frank | 0 |
| Total | 1 159 | 121 |
En breton, l’ordinateur domine : urzhiataer est le terme principal de plus de la moitié des articles. En français, les quatre premiers termes font jeu égal, et numérique arrive en tête ; le mot breton niverel semble moins installé que son équivalent français. Plus surprenant, meziant frank (logiciel libre) n’est le terme dominant d’aucun article breton : les articles sur le logiciel libre emploient plus souvent un autre de nos termes, comme stlenneg ou urzhiataer. C’est le cas de Linux, d’Inkscape, un logiciel libre de dessin, et même de l’article Poellad frank, « logiciel libre » en breton. Quant à genrouedad et kenrouedad, c’est le même mot, avec ou sans mutation.
Bloc 6 : la longueur des articles
# %% 6. Longueur des articles selon la langue et l'existence d'un équivalent
longueur = (articles.groupby(["langue", "equivalent"])["mots"]
            .agg(["count", "median", "mean"]).round(0).astype(int))
print("Longueur selon *equiv_\n", longueur, "\n")

fig, ax = plt.subplots(figsize=(8, 4.5))
groupes = [(l, e) for l in ("br", "fr") for e in ("oui", "non")]
donnees = [articles.query("langue == @l and equivalent == @e")["mots"] for l, e in groupes]
ax.boxplot(donnees, showfliers=False)
ax.set_xticks(range(1, 5), [f"{l}\néquivalent {e}" for l, e in groupes])
ax.set_ylabel("mots par article")
ax.set_title("Longueur des articles (valeurs extrêmes masquées)")
fig.tight_layout()
fig.savefig(SORTIE / "wikipedia-numerique-br-fr-longueurs.png", dpi=150)
| Langue | Équivalent | Articles | Médiane | Moyenne |
|---|---|---|---|---|
| br | non | 12 | 388 | 477 |
| br | oui | 109 | 422 | 663 |
| fr | non | 1 057 | 997 | 1 752 |
| fr | oui | 102 | 3 938 | 4 814 |
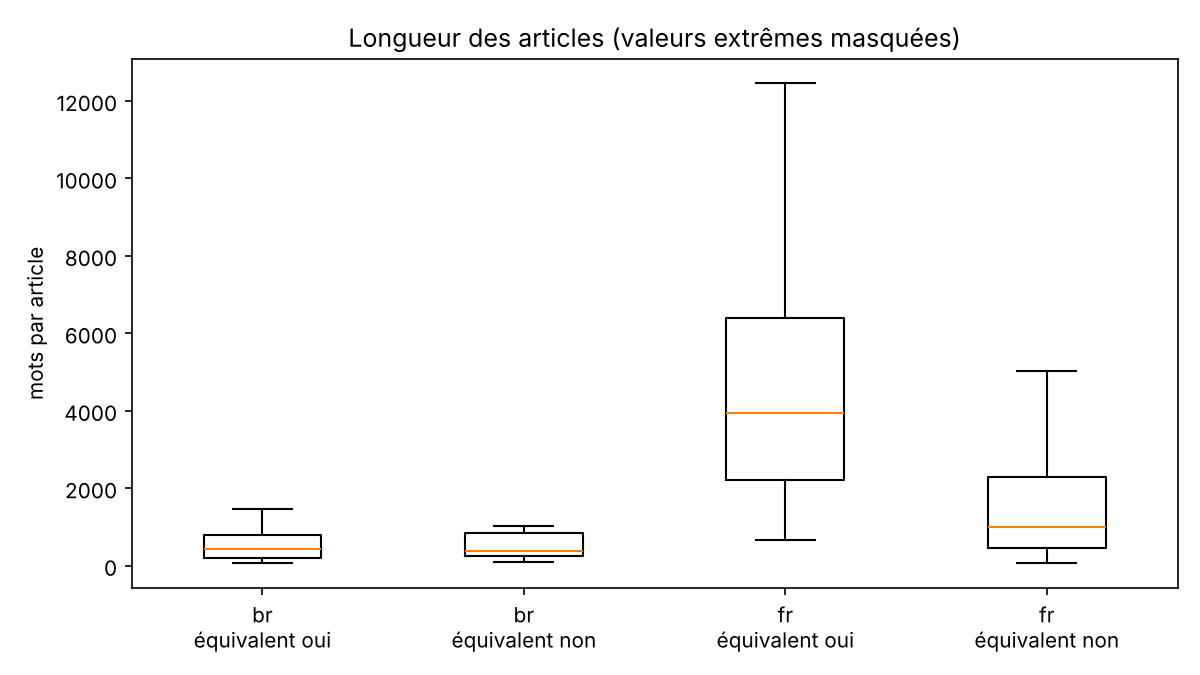
Une boîte à moustaches résume une distribution : le trait central est la médiane, la boîte contient la moitié des articles, et les moustaches s’étendent vers les valeurs plus éloignées. Nous avons masqué les valeurs extrêmes pour garder une échelle lisible.
Côté breton, les articles qui ont un lien vers le français et ceux qui n’en ont pas ont presque la même longueur : 422 mots en médiane pour les premiers, 388 pour les seconds. Les deux boîtes de gauche du graphique se ressemblent.
Côté français, en revanche, l’écart est net : les articles français qui ont une version bretonne sont quatre fois plus longs que les autres (médiane de 3 938 mots contre 997). Ce chiffre ne dit rien de la longueur des articles bretons : il dit quels sujets ils traitent. Les contributeurs bretons ont choisi les grands sujets, ceux qui ont en français des articles longs et développés : Internet, Ordinateur, Unix, Wikipédia… Mais ils les traitent plus brièvement : nous le verrons au bloc 7, l’article breton fait en médiane un cinquième de sa version française.
Pourquoi un tel écart ? Nos données ne permettent pas de le mesurer. L’explication la plus simple tient au nombre de contributeurs : Wikipédia en français en compte beaucoup plus, qui complètent les grands articles au fil des années.
Bloc 7 : les mêmes sujets dans les deux langues
Comparons maintenant les 109 paires, article par article, grâce à leur identifiant commun.
# %% 7. Les mêmes sujets dans les deux langues : comparer les paires
pbr, pfr = lire_corpus(PAIRES["br"]), lire_corpus(PAIRES["fr"])
paires = pbr[["id", "mots"]].merge(pfr[["id", "mots"]], on="id", suffixes=("_br", "_fr"))
paires["rapport_br_fr"] = paires["mots_br"] / paires["mots_fr"]
print(f"{len(paires)} paires : {paires['mots_br'].sum()} mots en breton, "
      f"{paires['mots_fr'].sum()} en français")
print(f"L'article breton fait en médiane "
      f"{paires['rapport_br_fr'].median():.0%} de l'article français")
print("Paires où le breton est plus long :",
      (paires["rapport_br_fr"] > 1).sum(), "\n")

fig, ax = plt.subplots(figsize=(6, 6))
ax.scatter(paires["mots_fr"], paires["mots_br"], s=12, alpha=0.6)
borne = max(paires["mots_fr"].max(), paires["mots_br"].max())
ax.plot([10, borne], [10, borne], linestyle="--", linewidth=1, color="grey")
ax.set_xscale("log"); ax.set_yscale("log")
ax.set_xlabel("mots, version française"); ax.set_ylabel("mots, version bretonne")
ax.set_title("Mêmes articles, deux langues (diagonale : même longueur)")
fig.tight_layout()
fig.savefig(SORTIE / "wikipedia-numerique-br-fr-paires.png", dpi=150)
109 paires : 72230 mots en breton, 444238 en français
L'article breton fait en médiane 20% de l'article français
Paires où le breton est plus long : 10
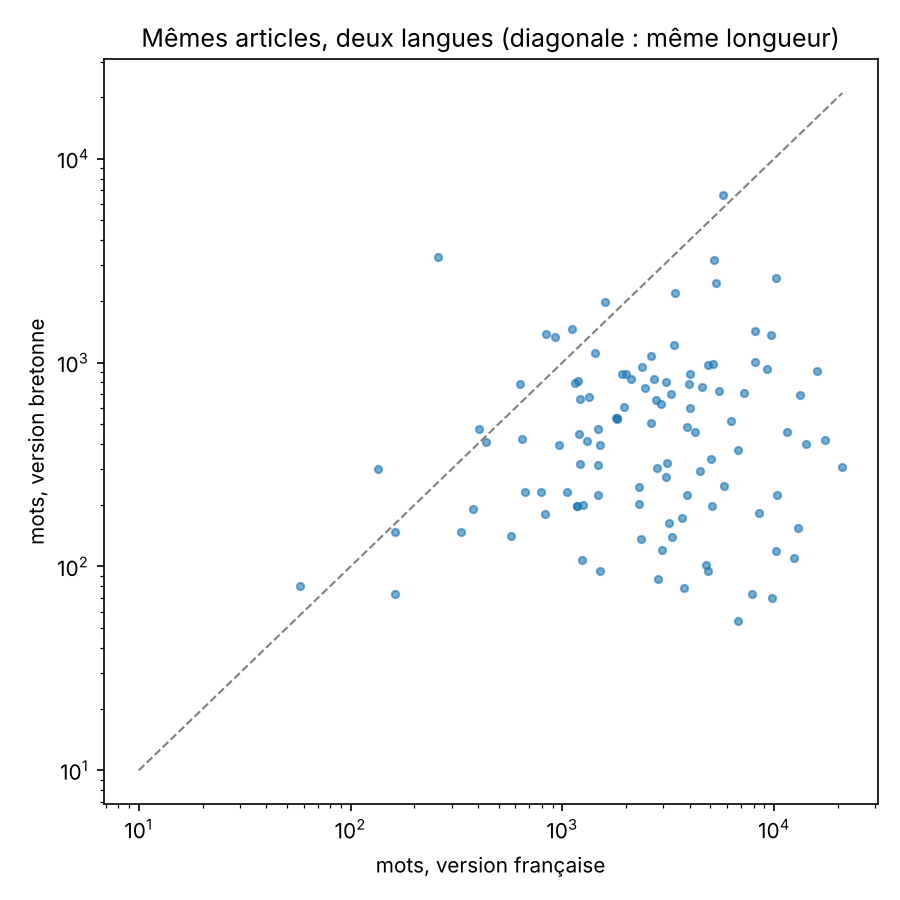
Chaque point est un sujet. La diagonale en pointillés marque l’égalité des longueurs : un point au-dessus, et l’article breton est plus long. Les axes sont en échelle logarithmique, où chaque graduation multiplie la longueur par dix ; sans elle, quelques très longs articles écraseraient tous les autres dans un coin du graphique.
Pour un même sujet, l’article breton fait en médiane un cinquième de l’article français. Les écarts les plus forts opposent de courtes ébauches bretonnes à de longs articles français : Steve Jobs (110 mots contre 12 456), Macintosh, Amiga, Microsoft. Mais il y a des exceptions : l’article breton est plus long dans 10 cas, dont Unix (6 642 mots contre 5 751), An Drouizig, une association qui traduit des logiciels en breton, ou Humble Bundle, un site qui vend des lots de jeux vidéo, de livres numériques et de logiciels à prix libre, dont une partie est reversée à des associations caritatives.
Le point isolé en haut à gauche nous a d’abord intrigués. C’est Listennad kodoù-statud HTTP, la liste des codes HTTP : 3 281 mots en breton, 258 en français. L’article français, Liste des codes HTTP, n’est pourtant pas plus court : il présente les codes dans des tableaux, que l’API de Wikipédia utilisée par wiki2iramuteq ne restitue pas. Il suffit d’ouvrir les deux pages pour s’en rendre compte. Un comptage de mots mesure ce que l’outil a extrait, pas toujours ce que l’article contient.
Bloc 8 : avoir un équivalent n’est pas être dans l’autre corpus
Les versions françaises des 109 paires figurent-elles dans le corpus français issu de sa propre recherche ? Vérifions-le.
# %% 8. Avoir un équivalent n'est pas être dans l'autre corpus
# Les versions françaises des paires sont-elles dans le corpus français ?
# On compare les titres exacts, pris dans les fichiers de métadonnées.
meta_paires = pd.read_csv(PAIRES["fr"].with_name(PAIRES["fr"].stem + "_metadonnees.csv"))
titres_fr = set(articles.query("langue == 'fr'")["titre"])
meta_paires["dans_corpus_fr"] = meta_paires["titre"].isin(titres_fr)
n_dedans = int(meta_paires["dans_corpus_fr"].sum())
print(f"Versions françaises des paires présentes dans le corpus français : "
      f"{n_dedans} sur {len(meta_paires)}")
absentes = sorted(meta_paires.loc[~meta_paires["dans_corpus_fr"], "titre"])
print("Exemples d'absentes :", " ; ".join(absentes[:10]), "\n")
Seules 50 sur 109 y figurent. Parmi les 59 absentes, 54 n’ont jamais été ramenées par la recherche française : Unix, Bitcoin, Facebook, Compilateur, Tim Berners-Lee… Les 5 autres ont été ramenées, puis écartées par le filtre.
Nous le savions par les réglages, nous le mesurons ici : le corpus français de contexte n’est qu’un échantillon, et non un relevé complet.
Bloc 9 : écrire la synthèse
Le dernier bloc écrit tous ces tableaux dans resultats/comparaison_synthese.md, au format Markdown, avec la liste des paires absentes et celle des articles bretons sans équivalent. C’est la méthode to_markdown() de pandas qui les met en forme, grâce à la bibliothèque tabulate.
# %% 9. Écrire la synthèse en Markdown
with open(SORTIE / "comparaison_synthese.md", "w", encoding="utf-8") as f:
    f.write("# Synthèse de la comparaison\n\n## Taille des corpus\n\n")
    f.write(taille.to_markdown() + "\n\n## Équivalents dans l'autre langue\n\n")
    f.write(equiv.to_markdown() + "\n\n## Articles par terme de recherche\n\n")
    f.write(termes.to_markdown(index=False) + "\n\n## Longueur selon *equiv_\n\n")
    f.write(longueur.to_markdown() + "\n\n## Paires fr/br\n\n")
    # … (suite dans le dépôt : chiffres des paires, listes d'articles)
Avant toute analyse lexicale, nous savons donc déjà trois choses. Sur le numérique, Wikipédia en breton est petit, et presque entièrement « doublé » en français. Il porte sur les grands sujets, mais les traite plus brièvement, avec un article médian cinq fois plus court. Et l’ordinateur y occupe une place centrale.
Reste à savoir de quoi parlent ces articles. C’est là qu’IRaMuTeQ entre en jeu.
3. La méthode : IRaMuTeQ, Reinert et le dictionnaire breton
La classification de Reinert, en quelques mots
La méthode de Reinert, du nom du chercheur qui l’a conçue pour le logiciel Alceste, classe des segments de texte d’après leur vocabulaire. IRaMuTeQ découpe d’abord chaque article en segments d’environ 40 mots. Il partage ensuite l’ensemble des segments en deux groupes aux vocabulaires aussi différents que possible, puis recommence sur le plus gros groupe, et ainsi de suite. C’est ce qu’on appelle une classification descendante hiérarchique.
On obtient ainsi des classes : des groupes de segments qui emploient les mêmes mots. Pour chaque classe, IRaMuTeQ donne les mots qui la caractérisent, classés par leur chi² : plus le chi² est élevé, plus le mot est surreprésenté dans la classe par rapport au reste du corpus. Les variables étoilées sont traitées de la même façon, ce qui permet de voir, par exemple, si les articles *equiv_fr_non sont surreprésentés dans une classe.
Ce qui est intéressant dans cette méthode, c’est qu’on ne donne pas de thèmes au logiciel : il les fait émerger du vocabulaire. C’est ensuite à nous de les nommer, en lisant les mots caractéristiques et les segments les plus typiques de chaque classe. Nous verrons que c’est la partie la plus délicate.
Deux analyses séparées, puis une comparaison
Pourquoi ne pas classer ensemble les textes bretons et français ? Parce que les deux langues n’ont presque aucun mot en commun. Une classification sur un corpus mélangé séparerait d’abord les langues, et nous apprendrait seulement que le breton n’est pas du français :-).
Nous avons donc fait deux analyses :
- le corpus breton complet (121 articles,
corpus/br/wikipedia_br_numerique_pret.txt). On croise ses classes avec*equiv_fret*terme_: de quoi parle Wikipédia en breton, et que traite-t-il seul ? - les versions françaises des 109 articles bretons qui ont un équivalent (
corpus/paires/wikipedia_fr_aligne_sur_br_numerique_filtre.txt). On compare leurs classes à celles du breton, grâce à l’identifiant*id_commun : un même article tombe-t-il dans des classes de même thème dans les deux langues ?
Nous n’avons pas analysé à part le corpus breton des paires, c’est-à-dire les 109 articles bretons qui ont un équivalent français. C’est le corpus breton complet moins ses 12 articles sans équivalent, qui ne pèsent que 7 % des mots. Nous nous attendons donc à des classes voisines, mais ce n’est pas sûr car nous avons vu qu’un petit changement peut suffire à faire apparaître ou disparaître une classe.
C’est une vérification que nous n’avons pas faite. Si vous souhaitez l’effectuer, le corpus est dans le dépôt, déjà préparé pour IRaMuTeQ (corpus/paires/wikipedia_br_paires_pret.txt).
Préparer le texte breton
IRaMuTeQ ne connaît pas le breton. C’est le dictionnaire tiré d’Apertium qui lui apprend à rattacher chaque forme à son lemme : tud et dud à den (« personne »), graet à ober (« faire »). Mais le texte doit d’abord être préparé, car IRaMuTeQ coupe les mots à l’apostrophe : c’hoari deviendrait c + hoari. Le script preparer_corpus_breton.py s’en charge :
- réécrit c’h en c_h, comme dans le dictionnaire ;
- soude les mots-outils à trait d’union (e-barzh →
e_barzh) ; - sépare les autres mots à trait d’union ;
- soude les expressions (meur a →
meur_a, en doa →en_doa).
python3 preparer_corpus_breton.py corpus/br/wikipedia_br_numerique_filtre.txt \
    -o corpus/br/wikipedia_br_numerique_pret.txt
Les articles précédents détaillent le fonctionnement de ce script. Une étape est nouvelle, la deuxième de la liste : elle est née de ce corpus, comme nous allons le voir.
Ce que le vrai corpus a révélé : la version 3 du dictionnaire
Nous avions d’abord préparé le corpus avec la version 2 du dictionnaire, celle que nous venions de publier (la version 3 n’existait pas encore), et lancé les statistiques textuelles d’IRaMuTeQ. Cette étape liste les formes du corpus, leur lemme et leur fréquence. Surprise : parmi les mots pleins les plus fréquents, quatre n’avaient rien à faire dans un corpus sur le numérique :
| Lemme lu | Sens | Occurrences | Forme d’origine |
|---|---|---|---|
| unaniñ | unir | 158 | unan, « un » |
| kell | cellule | 135 | c’hell, « peut » (e c’hell, « il peut ») |
| barzh | poète | 127 | e-barzh, « dedans », coupé au tiret |
| touiñ | jurer | 61 | e-touez, « parmi » (en o zouez, « parmi eux ») |
A priori Les contributeurs de Wikipédia en breton sur le numérique ne parlent pas de poètes qui jurent 🙂 ! Ces lemmes auraient pourtant pesé dans la classification de Reinert, car ce sont des mots pleins, donc actifs, et fréquents.
En cherchant d’où venaient ces erreurs, nous leur avons trouvé deux causes.
La première vient de la construction du dictionnaire. Une forme bretonne peut avoir plusieurs lectures, et IRaMuTeQ n’en accepte qu’une. Quand plusieurs lectures sont possibles, le script de construction suit un ordre de préférence et, à rang égal, préfère le verbe à l’adjectif, à l’adverbe et au numéral. Pour quelques formes très fréquentes, ce choix est faux. Nous les avons corrigées une à une, dans le dictionnaire AJOUTS de construire_lexique_br.py :
AJOUTS = {
    "deze": ("kaout", "aux"),       # contraction de « deveze » (en deze)
    # v3 : erreurs révélées par le corpus Wikipédia « numérique ».
    # Quand plusieurs lectures ont le même rang, le verbe l'emporte sur
    # l'adjectif, l'adverbe et le numéral : on corrige les formes fréquentes.
    "c_hell": ("gallout", "ver"),   # « e c'hell » (il peut) ; lu « kell », cellule
    "unan": ("unan", "adj_num"),    # « un » ; lu « unaniñ », unir
    "du": ("du", "adj"),            # « noir » ; lu « duañ », noircir
    "ra": ("ober", "ver"),          # « a ra » (il fait) ; lu particule optative
    "mui": ("mui", "adv"),          # « plus » ; lu « muiañ », verbe
    "muiañ": ("mui", "adv"),
    # … (variantes mutées : vuiañ, muioc_h, vuioc_h)
    "pennañ": ("pennañ_adj", "adj"),  # « principal » ; lu verbe « pennañ »
    "bennañ": ("pennañ_adj", "adj"),
    # « en o zouez » (parmi eux) : lu « touiñ », jurer
    "touez": ("e-touez", "pre"),
    "zouez": ("e-touez", "pre"),
    "douez": ("e-touez", "pre"),
    "ebarzh": ("e-barzh", "pre"),   # graphie soudée ; lu « ebarzhiñ »
}
Chaque entrée associe une forme à son lemme et à sa catégorie grammaticale. La catégorie compte : pre (préposition) fait de e-touez un mot-outil, qu’IRaMuTeQ traite comme supplémentaire, c’est-à-dire qu’il ne participe pas à la classification.
La seconde vient de la préparation des textes. Notre script coupait tous les mots à trait d’union, et e-barzh devenait e + barzh, le poète. La version 3 ajoute au fichier d’expressions les 320 mots-outils et adverbes à trait d’union d’Apertium (e-barzh, e-touez, dreist-holl, war-dro…). Le script les soude avant de couper, mais seulement quand ils sont écrits avec le tiret : a fell (« que veut »), en deux mots, reste séparé, car a-fell n’existe pas.
Pour cela, la classe Soudeur range à part, à la lecture du fichier d’expressions, les entrées qui contiennent un tiret :
class Soudeur:
    """Soude les expressions (mots séparés par des espaces ou un trait d'union)."""

    def __init__(self, chemin):
        self.expressions = {}
        self.tirets = {}           # mots à trait d'union : « e-barzh » -> « e_barzh »
        with open(chemin, encoding="utf-8") as f:
            for ligne in f:
                champs = ligne.rstrip("\n\r").split("\t")
                if len(champs) >= 2 and " " in champs[0]:
                    self.expressions[champs[0]] = champs[1]
                elif len(champs) >= 2 and "-" in champs[0]:
                    self.tirets[champs[0]] = champs[1]
L’effet sur le corpus est net : 1 718 occurrences changent de lecture. Kell tombe de 135 occurrences à 1, barzh de 127 à 12, et unaniñ de 158 à 31 (il ne reste que de vraies formes du verbe, comme unanet, « unifié »). Touiñ disparaît. Les occurrences retrouvent leur vrai verbe : ober (« faire ») passe de 562 à 737, et gallout (« pouvoir ») de 346 à 480.
La leçon dépasse le breton. Le corpus de test d’Apertium, qui nous avait servi à valider les versions 1 et 2, ne faisait pas ressortir ces erreurs : sur ce corpus, la version 3 ne change que 74 occurrences. Un dictionnaire se juge sur des textes réels, et les statistiques textuelles d’IRaMuTeQ sont le moyen le plus simple de le faire.
Les versions 1 et 2 restent en ligne, inchangées, pour rester conformes à leurs articles. La version 3 a son propre dépôt, Apertium2iramuteq-bretonV3, et une copie du lexique se trouve dans le dépôt de cet article.
Les réglages dans IRaMuTeQ
Nos analyses ont été faites avec IRaMuTeQ 0.8 alpha 7 et R 4.5.2.
Ouvrir le corpus breton préparé, corpus/br/wikipedia_br_numerique_pret.txt (Fichier → Ouvrir un corpus). Sous Windows, prenez plutôt corpus/br/wikipedia_br_numerique_pret_windows.txt, le même corpus encodé en Windows-1252, et choisissez l’encodage cp1252 au lieu d’utf-8 :
- encodage : utf-8 (ou cp1252 pour la version
_windowsdu fichier) ; - langue : autre ;
- dictionnaire : Autre, en désignant
dictionnaire/lexique_br.txt; - décochez Utiliser le dictionnaire des expressions : le script de préparation a déjà soudé les expressions dans le texte (e-barzh est devenu
e_barzh), et le dictionnaire de lemmes contient ces formes soudées. IRaMuTeQ les reconnaît donc sans passer par sa propre liste d’expressions.
Dans la description du corpus qui s’affiche ensuite, vérifiez le chemin du lexique et que la ligne des expressions indique 0. Si votre version d’IRaMuTeQ ne propose pas le dictionnaire « Autre », suivez la méthode B décrite dans le dépôt du dictionnaire.
Ouvrir le corpus français des paires, corpus/paires/wikipedia_fr_aligne_sur_br_numerique_filtre.txt (Fichier → Ouvrir un corpus) : encodage utf-8, langue français, avec le dictionnaire et les expressions françaises fournis par IRaMuTeQ. Vérifiez bien la langue : IRaMuTeQ reprend celle du corpus ouvert précédemment, ici « autre ».
Lancer la classification (Analyse → Classification → Méthode Reinert) avec les réglages par défaut :
- classification simple sur segments de texte ;
- segments de 40 mots (taille par défaut) ;
- 10 classes en phase 1 (on verra dans la section 4 pourquoi on passe ensuite à 12) ;
- formes actives de fréquence 3 au moins.
Nous avons gardé les mêmes réglages dans les deux langues, pour que les différences viennent des textes et non des paramètres.
4. Le corpus breton : cinq façons de parler du numérique
Vérifier le dictionnaire avant de classer
Avant de classer quoi que ce soit, nous avons relancé les statistiques textuelles (Analyse → Statistiques textuelles) sur le corpus préparé avec la version 3, pour vérifier que les corrections avaient bien fonctionné. C’était le cas : les lemmes les plus fréquents parmi les formes actives sont désormais ober (faire, 737 occurrences), gallout (pouvoir, 480), puis reizhiad (système, 311), urzhiataer (ordinateur, 290) et rouedad (réseau, 271). On reconnaît enfin un corpus sur le numérique ! Kell (cellule) n’apparaît plus qu’une fois, barzh (poète) 12 fois, et touiñ (jurer) a disparu.
| Indicateur | Valeur |
|---|---|
| Textes | 121 |
| Segments de texte | 2 068 |
| Occurrences | 75 457 |
| Lemmes | 8 340 |
| Formes actives de fréquence ≥ 3 | 2 468 |
| Hapax (formes vues une seule fois) | 52 % des formes, 6 % des occurrences |
Un hapax (du grec hapax legómenon, « dit une seule fois ») est une forme qui n’apparaît qu’une fois dans tout le corpus : un nom propre cité en passant, un terme rare, une faute de frappe. Ici, une forme sur deux est un hapax, mais ces formes ne pèsent que 6 % des occurrences. C’est beaucoup, mais habituel pour un corpus encyclopédique, riche en noms propres, termes techniques et sigles. Et les hapax ne pèsent pas dans la classification, qui ne garde que les formes vues au moins trois fois.
Un résultat à vérifier : la stabilité des classes
Nous avons d’abord lancé la classification de Reinert avec les réglages par défaut (10 classes en phase 1). Elle a donné 4 classes, avec 76 % des segments classés, juste au-dessus des 75 % que l’on considère généralement comme un minimum.
Ce résultat nous a surpris, et même un peu inquiétés. Un premier essai, sur un corpus qui comptait encore deux articles écartés depuis (Kenstroll et Kevreizhenn, 8 segments sur plus de 2 000), donnait 5 classes et 92 % de segments classés. La classe en plus réunissait Wikipedia, l’Agence Bretagne Presse et Brezhoweb ; dans l’analyse à 4 classes, ces articles n’étaient presque plus classés. Comment 8 segments pouvaient-ils changer autant le résultat ?
Pour en avoir le cœur net, nous avons fait deux vérifications. Nous avons d’abord relancé la même analyse, sans rien changer, pour savoir si la classification comporte une part de hasard : si deux lancements sur le même corpus pouvaient donner des résultats différents, l’écart pouvait venir de là, et non des deux articles retirés. Le résultat était identique, segment par segment. Sur un même corpus, la classification d’IRaMuTeQ est donc reproductible, et la différence venait bien du corpus. Nous avons ensuite changé un seul réglage, 12 classes en phase 1 au lieu de 10 : nous avons retrouvé 5 classes et 83 % de segments classés, avec les mêmes thèmes que dans le premier essai et presque les mêmes articles.
Conclusion : les quatre grandes classes sont présentes dans tous les essais, avec les mêmes articles. La cinquième, plus petite, n’apparaît qu’avec certains réglages : elle existe, mais elle est fragile. C’est un défaut connu de la classification simple, où une petite classe peut se maintenir ou se dissoudre pour très peu. D’où un conseil : relancez toujours l’analyse en faisant varier un paramètre avant d’interpréter une petite classe.
Nous avons retenu pour la suite l’analyse à 12 classes en phase 1, qui classe davantage de segments.
Le résultat de la classification
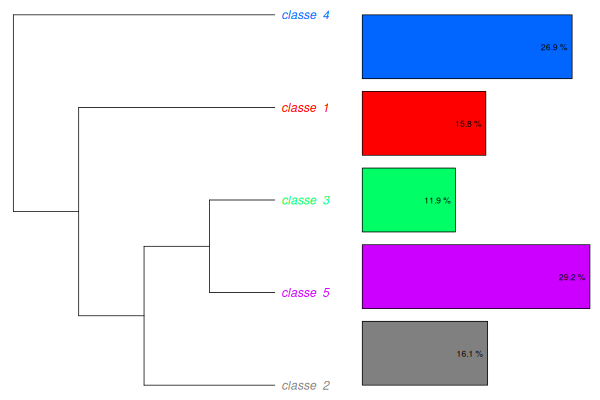
Le dendrogramme se lit de gauche à droite, dans l’ordre des partitions. La première isole la classe 4 (27 % des segments classés) de tout le reste ; la deuxième sépare la classe 1 (16 %), la troisième la classe 2 (16 %). Les classes 3 (12 %) et 5 (29 %) sont les plus proches : elles ne se séparent qu’à la fin.
Ne vous fiez pas aux numéros des classes : IRaMuTeQ les attribue dans l’ordre de son calcul. C’est l’ordre des partitions qui compte.
Pour nommer les classes, nous avons lu leurs profils (onglet Profils du résultat, ou fichier profiles.csv) : les mots les plus surreprésentés, classés par chi², et les variables étoilées associées. Puis nous avons lu les segments les plus caractéristiques de chaque classe (clic droit sur la classe, puis Segments de texte caractéristiques).
Voici les cinq classes, dans l’ordre des partitions :
| Classe | Segments | Nom proposé | Mots caractéristiques (chi² le plus fort) | Articles typiques |
|---|---|---|---|---|
| 4 | 462 (26,9 %) | Réseaux et matériel | arverañ (utiliser), rouedad (réseau), treuzkas (transmettre), fun (câble), komenad (protocole), kehentiñ (communiquer), USB, porzh (port), trobarzhell (périphérique), memor (mémoire), Ethernet, TCP | Rouedad stlennegel (réseau informatique), Reizhiad korvoiñ (système d’exploitation), Ethernet, OSI, Routaer (routeur), BIOS |
| 1 | 272 (15,9 %) | Unix et les systèmes d’exploitation | Unix, reizhiad (système), Linux, BSD, korvoiñ (reizhiad korvoiñ : système d’exploitation), aozadenn (version), kraoñell (noyau), kod (code), GNU | Unix, Linux, Microsoft Windows, Linus Torvalds |
| 2 | 276 (16,1 %) | Jeux vidéo, entreprises et marché | c’hoari (jeu, jouer), Humble Bundle, embregerezh (entreprise), c’hoari video, c’hoarier (joueur), Steam, prenañ (acheter), dollar, Elon Musk, arc’hant (argent), Apple, gwerzhañ (vendre) | Humble Bundle, Elon Musk, Steam, Tetris, Apple, Battlefield 3 |
| 3 | 205 (11,9 %) | Wikipédia et le Web breton | Wikipedia, holloueziadur (encyclopédie), raktres (projet), Breizh (Bretagne), wiki, ABP, pennad (article), Nupedia, bzh, lec’hienn (site), Brezhoweb | Wikipedia, Agence Bretagne Presse, Brezhoweb, .bzh, Facebook |
| 5 | 501 (29,2 %) | Langues, langages et usages | den (personne), treiñ (traduire), ger (mot), skeudenn (image), yezh (langue), troidigezh (traduction), brezhoneg (breton), levr (livre), Go, geek | Treiñ e brezhoneg, Go (langage), Geek, An Drouizig, Traitement automatique des langues, Poellad frank (logiciel libre) |
Les noms des classes sont les nôtres : IRaMuTeQ ne fournit que les profils. Nommer une classe, c’est déjà interpréter.
Réseaux et matériel (classe 4)
C’est la classe la plus nettement séparée des autres, puisque la première partition l’isole. Elle décrit le numérique comme un ensemble de machines reliées entre elles : câbles, ports, protocoles, périphériques. Le segment le plus caractéristique de l’article Skoroù treuzkas en donne le ton :
evit lakaat ar roadennoù da redek eus un drobarzhell d’unan all e-barzh ur rouedad stlennegel e ranker ober gant skoroù treuzkas
>
(pour faire circuler les données d’un périphérique à un autre dans un réseau informatique, il faut utiliser des supports de transmission)
On y lit le vocabulaire d’un manuel technique, avec beaucoup de mots bretons forgés pour l’occasion : trobarzhell (périphérique), stlennvon (base de données), routaer (routeur). Les articles sont nombreux (30 ont la plupart de leurs segments dans cette classe), mais courts : aucun ne fournit plus de 10 % de la classe.
Unix (classe 1)
La classe 1 parle des systèmes d’exploitation, et surtout d’un seul :
hiziv, pelloc’h eget ar reizhiadoù testeniekaet diouzh Unix, reizhiadoù korvoiñ unix-like, heñvel ouzh Unix, evel Linux ha BSD, zo deuet da vezañ boutin kenañ
>
(aujourd’hui, au-delà des systèmes certifiés Unix, les systèmes d’exploitation de type Unix, comme Linux et BSD, sont devenus très courants)
Ici, il faut être prudent. 167 des 272 segments de la classe, soit 61 %, viennent du seul article Unix, le plus long du corpus (6 642 mots, plus long que sa version française). La classe 1 est donc en grande partie « la classe de l’article Unix ». Elle dit quelque chose de réel, puisqu’un contributeur a beaucoup écrit sur Unix en breton, mais elle ne dit pas que les systèmes d’exploitation sont un grand thème de Wikipédia en breton.
Pourquoi Unix et pas Linux, plus connu aujourd’hui ? Linux et Windows sont bien rangés dans cette classe, mais leurs articles bretons ne font que 1 004 et 784 mots, contre 6 642 pour Unix (Mac OS, lui, n’a pas d’article dans notre corpus). L’historique de la page montre que l’article Unix a été porté dès 2006 à près de 29 000 octets par un même contributeur. Son texte semble suivre de près l’article anglais de l’époque, et il parle aussi de Linux et des systèmes « Unix-like ». C’est donc le travail d’un contributeur sur un seul article, plus qu’un intérêt particulier pour Unix, qui donne son vocabulaire à la classe. Nous reviendrons sur ce biais dans la section 6.
Jeux vidéo, entreprises et marché (classe 2)
La classe 2 parle d’argent : acheter, vendre, entreprises, dollars. Les jeux vidéo y dominent (Humble Bundle, Steam, Battlefield, Tetris), avec les grandes entreprises et leurs dirigeants (Apple, Elon Musk, Steve Jobs). C’est aussi là que l’on trouve l’adjectif niverel (numérique) au sens commercial, celui de la distribution numérique :
Steam zo ur savenn niverel dre internet savet gant Valve Corporation evit embann, brudañ ha diwall gwirioù ar c’hoarioù video
>
(Steam est une plateforme numérique sur internet créée par Valve Corporation pour publier, promouvoir et protéger les droits des jeux vidéo)
Wikipédia et le Web breton (classe 3)
C’est la petite classe fragile dont nous parlions. Elle réunit deux sujets que le vocabulaire rapproche : Wikipédia lui-même (holloueziadur, raktres, Nupedia, Larry Sanger) et la présence bretonne sur Internet, avec l’Agence Bretagne Presse, la chaîne de télévision en ligne Brezhoweb ou l’extension .bzh.
Brezhoweb a zo ur chadenn skinwel e brezhoneg war ar Genrouedad
>
(Brezhoweb est une chaîne de télévision en breton sur Internet)
L’article Wikipedia fournit à lui seul 57 des 205 segments (28 %), et l’Agence Bretagne Presse 26. La classe repose donc sur peu d’articles, ce qui explique sa fragilité.
Langues, langages et usages (classe 5)
La classe 5 est la plus diffuse : ses chi² sont plus faibles, et ses articles plus variés. Son fil conducteur est le langage, sous toutes ses formes : langues humaines et traduction, langages de programmation, argot (Leet speak), traitement automatique des langues. On y trouve aussi le logiciel libre, la culture geek et l’intelligence artificielle.
kalz nebeutoc’h a skridoù a vez troet e brezhoneg eget er yezhoù amezek ofisiel
>
(on traduit beaucoup moins de textes en breton que dans les langues voisines officielles)
Le mot brezhoneg (breton) est surreprésenté dans cette classe 5 (chi² 37) et dans la classe 3, « Wikipédia et le Web breton » (chi² 25), et ces deux classes sont les plus proches dans le dendrogramme. Ensemble, elles forment le versant « humain » du corpus : qui fait le numérique, dans quelle langue, pour qui. C’est là que Wikipédia en breton parle du numérique en Bretagne et en breton. Les classes 4 et 1, elles, en forment le versant technique. La classe 2, sur les jeux vidéo et le marché, se trouve entre les deux : dans le dendrogramme, elle reste du côté des classes 3 et 5, et elle parle des machines à travers ceux qui les vendent et les achètent.
Nous y avons retrouvé, avec un certain plaisir, plusieurs objets des humanités numériques, le sujet qui nous intéressait au départ : le traitement automatique des langues, l’outillage d’une langue minoritaire, les encyclopédies et la cartographie collaboratives.
Le champ lui-même n’est pourtant jamais nommé dans le corpus breton, ni « humanités numériques », ni « humanités digitales », alors que Wikipédia en français lui consacre plusieurs articles (Humanités numériques, Histoire numérique, Littérature numérique…). On peut y voir le signe d’une communauté qui pratique les humanités numériques sans les nommer : le terme, récent et universitaire (vers 2010), s’est diffusé en français, langue dans laquelle se fait aussi l’essentiel de la recherche sur le breton, par exemple au Centre de recherche bretonne et celtique (CRBC) de l’université de Bretagne occidentale, à Brest, ou à l’université Rennes 2.
Le breton n’est d’ailleurs pas un cas isolé : parmi les langues celtiques, seul Wikipédia en gallois a un article sur le sujet, Dyniaethau digidol, très court, relié à l’article anglais Digital humanities ; le gallois est aussi une langue d’enseignement et de recherche à l’université : depuis 2011, le Coleg Cymraeg Cenedlaethol finance des postes d’enseignants et des bourses pour étudier en gallois, et il a une antenne dans chaque université du pays de Galles.
Wikipédia en irlandais n’en a pas, alors même que le terme irlandais, daonnachtaí digiteacha, est employé dans la recherche universitaire, par exemple par l’école Fiontar & Scoil na Gaeilge de la Dublin City University, qui présente ses projets numériques menés en irlandais. Quant aux projets numériques en gaélique écossais, en cornique ou en mannois (corpus, dictionnaires, archives sonores), ils sont eux aussi présentés en anglais.
Le plan factoriel
L’analyse factorielle des correspondances (AFC), produite avec la classification, place les mots dans un plan selon leurs classes.
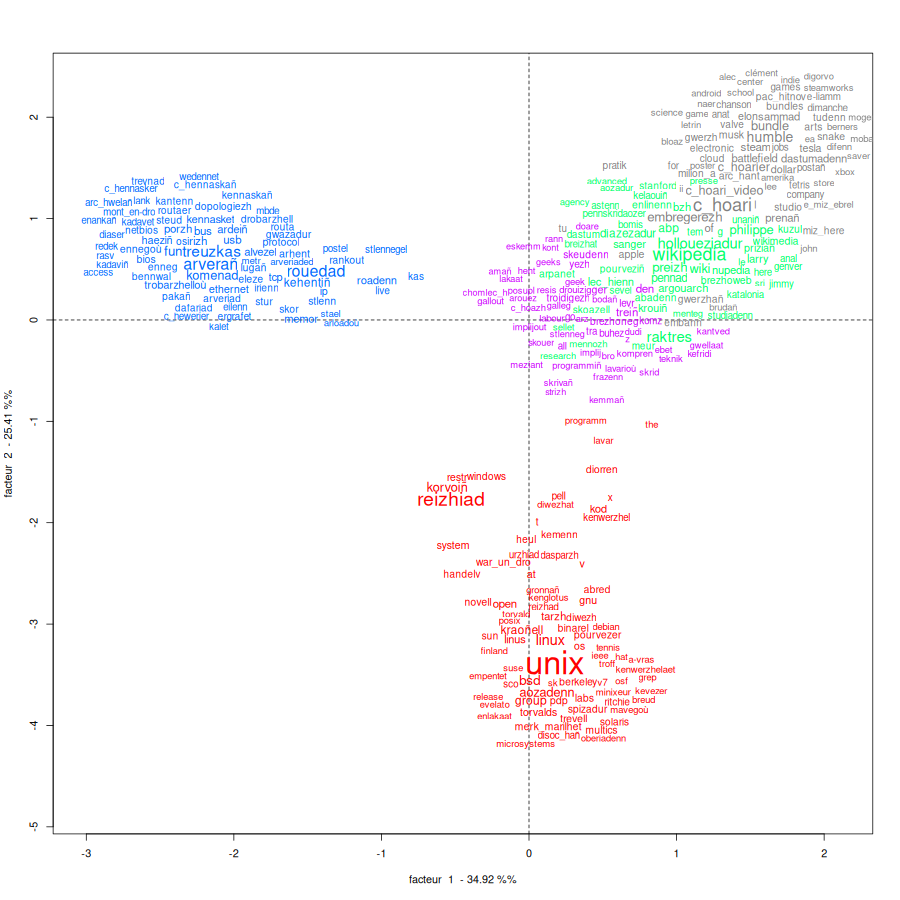
Elle confirme le dendrogramme. Le premier facteur (35 % de l’information) oppose, à gauche, le vocabulaire des réseaux et du matériel (classe 4, en bleu) à tout le reste. Le second facteur (25 %) isole, en bas, le vocabulaire d’Unix (classe 1, en rouge). Les classes 2, 3 et 5 (gris, vert, violet) se chevauchent en haut à droite : leurs vocabulaires se mélangent sur ces deux axes, ce qui ne veut pas dire qu’elles forment un seul thème. Le dendrogramme, plus fiable pour cela, montre que la classe 2 se sépare des classes 3 et 5 (« Humanités numériques ») avant que celles-ci ne se séparent entre elles.
Des segments aux articles
IRaMuTeQ classe des segments, pas des articles. Pour savoir dans quelle classe tombe chaque article, il faut ramener les segments à leurs articles. Heureusement, IRaMuTeQ garde tout ce qu’il faut dans le dossier du corpus. Le fichier corpus.db associe chaque segment à son texte et à ses variables : c’est une base de données SQLite, c’est-à-dire une base entière contenue dans un seul fichier, sans serveur à installer, que vous pouvez explorer avec le logiciel libre DB Browser for SQLite (Linux, Windows, macOS) ou depuis Python avec le module sqlite3. Le fichier uce.csv de l’analyse, lui, donne la classe de chaque segment.
Nous avons écrit un petit script, classes_par_article.py, pour faire ce rapprochement. Il lit d’abord les variables de chaque texte et le texte d’origine de chaque segment :
# 1. Les variables de chaque texte, et le texte de chaque segment
base = sqlite3.connect(Path(args.corpus) / "corpus.db")
variables = {}
for uci, ligne, _ in base.execute("SELECT uci, et, paras FROM etoiles"):
    # « **** *art_Unix *equiv_fr_oui » -> {"art": "Unix", "equiv": "fr_oui"}
    variables[uci] = dict(v[1:].split("_", 1) for v in ligne.split()[1:] if "_" in v)
texte_du_segment = {uce: uci for uci, _, uce in base.execute("SELECT uci, para, uce FROM luces")}
Dans le vocabulaire d’IRaMuTeQ, un uci est un texte (ici un article) et un uce, un segment. Le script lit ensuite la classe de chaque segment, puis compte, article par article :
# 2. La classe de chaque segment : uce.csv a une ligne par segment, dans l'ordre
with open(Path(args.alceste) / "uce.csv", encoding="utf-8") as f:
    classes = [int(ligne[1]) for ligne in list(csv.reader(f, delimiter=";"))[1:]]
nb_classes = max(classes)

# 3. Compter les segments de chaque classe, article par article
comptes = {uci: Counter() for uci in variables}
for uce, classe in enumerate(classes):
    comptes[texte_du_segment[uce]][classe] += 1
La classe 0 regroupe les segments non classés. Le script écrit un tableau avec une ligne par article, le nombre de segments dans chaque classe et la classe dominante :
python3 classes_par_article.py \
    corpus/br/wikipedia_br_numerique_pret_corpus_1 \
    corpus/br/wikipedia_br_numerique_pret_corpus_1/wikipedia_br_numerique_pret_alceste_2 \
    -o resultats/classes_par_article_br.csv
La plupart des articles sont homogènes : plus de la moitié ont au moins 85 % de leurs segments dans une seule classe. Les plus mélangés sont les articles généraux, comme Kenrouedad (Internet) ou Urzhiataer (ordinateur), qui touchent à tout.
Ce que disent les variables
Les variables étoilées reçoivent elles aussi un chi² dans chaque classe. Deux d’entre elles nous ont particulièrement intéressés.
*terme_ : le terme de recherche dominant. Chaque terme renvoie à une classe :
| Terme dominant de l’article | Classe où il est surreprésenté | chi² |
|---|---|---|
| genrouedad (Internet) | 3, Wikipédia et le Web breton | 293 |
| niverel (numérique) | 2, jeux vidéo et marché | 137 |
| urzhiataer (ordinateur) | 1, Unix | 70 |
| kenrouedad (Internet) | 3, Wikipédia et le Web breton | 53 |
| stlenneg (informatique) | 4, réseaux et matériel | 19 |
En breton, les mots ne se partagent pas le numérique au hasard. Niverel (numérique) est celui du commerce et des produits, kenrouedad (Internet) celui des projets en ligne. Le lien de stlenneg (informatique) avec la technique est plus faible (chi² 19) : nous verrons dans la section 5 que ses articles sont très variés. Quant au lien entre urzhiataer et Unix, il tient surtout au poids de l’article Unix, ramené par ce terme.
*equiv_fr_non : les articles sans équivalent français. Ils sont surreprésentés dans la classe 4, réseaux et matériel (chi² 18) : 34 % de leurs segments y tombent, contre 21 % pour les autres articles. Le tableau par article précise les choses :
| Classe dominante | Articles sans équivalent français |
|---|---|
| 4, réseaux et matériel | OSI, Skoroù treuzkas (supports de transmission), Porzh a-steud |
| 5, langues, langages et usages | Treiñ e brezhoneg (traduire en breton), Raktres Translate (brezhoneg), Ardivink, Ajañs vruderezh |
| 3, Wikipédia et le Web breton | Imran Awan |
| 1, 2 ou non classé | Rainlendar, Snake (c’hoari video), Terminator (robotoù), Luc’hreüser |
Ce tableau nous a d’abord fait conclure un peu vite. La variable *equiv_fr vient des liens interlangues de l’article breton, tirés de Wikidata. Or Wikipédia en français a bien un article Modèle OSI, un article Support de transmission et un article Port série (Porzh a-steud), et sans doute aussi des équivalents d’Ajañs vruderezh (agence de publicité) ou de Snake. Ces articles bretons ne traitent donc pas de sujets absents du français : ils ne sont simplement pas reliés à leur équivalent. Ce sont eux qui font monter le chi² de *equiv_fr_non dans la classe « réseaux et matériel ».
Les articles vraiment propres à Wikipédia en breton sont ceux qui concernent la langue bretonne elle-même : traduire en breton, outiller le breton pour la traduction automatique. Ceux-là n’ont pas d’équivalent français parce qu’ils concernent d’abord les bretonnants.
C’est en soi une observation : une partie des articles techniques de Wikipédia en breton n’est pas reliée à leurs équivalents dans les autres langues, et reste donc invisible depuis eux. Relier ces articles serait une contribution simple et utile.
Une limite cependant : avec seulement 12 articles, ces résultats sont des pistes, pas des preuves.
Une autre vue : les spécificités
La classification passe par des classes de segments. Pour vérifier ce qu’elle dit des articles sans équivalent, nous avons aussi comparé directement leur vocabulaire à celui des autres articles, avec l’outil Spécificités et AFC d’IRaMuTeQ (Analyse → Spécificités et AFC).
Il faut choisir la variable equiv, ce qui nous a d’abord déroutés : IRaMuTeQ coupe le nom d’une variable au premier _. Dans *equiv_fr_oui, la variable s’appelle donc equiv, et ses modalités sont fr_oui et fr_non. Nous avons gardé les réglages par défaut : lemmes, indice hypergéométrique, formes de fréquence 10 au moins.
Une note pratique, apprise à nos dépens. Les spécificités utilisent le paquet R textometry, qui n’est pas toujours installé avec IRaMuTeQ. S’il manque, IRaMuTeQ affiche « aucun package nommé ‘textometry’ n’est trouvé », puis plante, au point de refuser de se fermer. Pour l’installer, lancez R dans un terminal et tapez :
install.packages("textometry")
Si R vous demande d’utiliser une bibliothèque personnelle, répondez bien oui, en toutes lettres si R est en français : yes ou une simple pression sur Entrée valent « non ».
Pour chaque forme, IRaMuTeQ calcule un indice de spécificité, qui mesure à quel point la forme est plus fréquente (indice positif) ou moins fréquente (indice négatif) dans un groupe d’articles que si les mots étaient répartis au hasard entre les groupes.
Ici, les groupes sont les articles avec un équivalent français (fr_oui) et ceux qui n’en ont pas (fr_non) : ce sont les deux valeurs, ou modalités dans le vocabulaire d’IRaMuTeQ, de la variable equiv.
Nous avons retenu un seuil de 2, en positif ou en négatif : l’indice étant l’exposant de la probabilité que l’écart soit dû au hasard, un indice de 2 signifie que l’écart a moins d’une chance sur cent d’être dû au hasard, un indice de 3 moins d’une chance sur mille.
C’est le seuil de 1 % courant en statistique, mais ce choix est le nôtre.
Les résultats sont dans l’onglet Formes du résultat, ou dans le fichier tablespecf.csv, qu’IRaMuTeQ range dans le dossier de l’analyse, à côté des classifications : corpus/br/wikipedia_br_numerique_pret_corpus_1/wikipedia_br_numerique_pret_spec_1/ pour notre première analyse de spécificités.
Une fois l’analyse lancée, que disent ces spécificités ? Les 12 articles sans équivalent ne pèsent que 5 554 occurrences, contre près de 70 000 pour les autres. 58 formes y sont pourtant nettement surreprésentées, et les plus spécifiques forment trois groupes :
| Groupe | Formes surreprésentées (indice) | Articles d’où elles viennent |
|---|---|---|
| La langue bretonne | treiñ (traduire, 20), brezhoneg (breton, 14), troer (traducteur, 7), troidigezh (traduction, 7), skrid (écrit, 6), levr (livre, 5) | Treiñ e brezhoneg, Raktres Translate (brezhoneg) |
| La technique | fun (câble, 13), gwiskad (couche, 9), live (niveau, 7), gorreenn (surface, 6), luc’hreüser (4) | Skoroù treuzkas, OSI, Luc’hreüser |
| La fiction | terminator (19), robot (18), film (6), denelezh (humanité, 5), skynet (4), lazhañ (tuer, 3) | Terminator (robotoù) |
À l’inverse, les formes les plus sous-représentées sont unix (−7), reizhiad (système, −6), memor (mémoire, −3) et kod (code, −3) : ces articles ne parlent pas des systèmes d’exploitation.
Les spécificités confirment donc la classification : la langue bretonne d’un côté, la technique de l’autre, sachant que le groupe technique vient surtout d’articles mal reliés à leur équivalent français. Elles ajoutent un troisième groupe, la fiction, que la classification laissait de côté parce que l’article Terminator (robotoù) n’était pas classé.
Elles montrent aussi leurs limites : chaque groupe repose sur un ou deux articles. Robot vient à 100 % de Terminator (robotoù), et gwiskad (couche) de l’article OSI. Avec 12 articles, les spécificités décrivent ces articles plus qu’une tendance générale.
Un dernier résultat nous a surpris. Il porte sur les catégories grammaticales (onglet Types) : les articles sans équivalent contiennent nettement moins de formes non reconnues (indice −17), c’est-à-dire surtout de noms propres et de mots étrangers, avec 115 pour 1 000 occurrences contre 155 dans les autres articles. Ils contiennent aussi moins de nombres. Ce sont des textes rédigés en breton courant, plutôt que des fiches pleines de noms de produits, de sigles et de dates.
Pourquoi n’avons-nous pas d’AFC, comme pour la classification ? L’outil Spécificités et AFC en propose une, mais elle n’a de sens qu’avec au moins trois modalités. Une AFC place les groupes et les mots sur un graphique à deux axes, chaque axe résumant une façon dont les groupes s’opposent. Avec deux groupes seulement, ici fr_oui et fr_non, il n’y a qu’une opposition possible : un mot est plus fréquent d’un côté ou de l’autre. C’est un peu comme deux points, qui tiennent toujours sur une seule ligne : il en faut trois pour dessiner un plan. Or cette unique opposition, l’indice de spécificité la mesure déjà pour chaque mot, par son signe et sa valeur : le tableau dit donc tout ce qu’une AFC pourrait montrer.
Ce qui n’est pas classé
Reste ce que la classification ne range nulle part : 352 segments (17 %). Ils sont très concentrés, puisque 16 articles en ont la majorité, et forment trois groupes. Le premier est la liste des codes HTTP, dont 80 segments sur 87 ne sont pas classés : une liste de codes et de définitions brèves ne ressemble à aucun autre texte. Le deuxième rassemble les machines de bureau : Luc’heilerez (photocopieur), Pelleiler (télécopieur), Moullerez (imprimante), Skanner et Luc’hreüser, le tambour photosensible des photocopieurs et des imprimantes laser ; dans l’analyse à 10 classes, ils étaient rattachés aux réseaux et au matériel. Le troisième réunit la fiction et la culture populaire : Terminator (robotoù), Skynet, Battlestar Galactica, Polandball, dont le vocabulaire narratif (robots, guerre, personnages) ne se retrouve nulle part ailleurs dans le corpus.
S’y ajoutent les articles sur la chaîne de blocs et les cryptomonnaies (Chadenn vloc’hoù, Bitcoin, Kriptomoneiz).
Ces groupes sont trop petits pour former des classes, mais chacun a son vocabulaire propre. La place du numérique dans la culture, que nous avions tenu à garder dans les deux langues, ne forme donc pas un thème à part entière dans Wikipédia en breton : elle reste à la marge de la classification.
5. Les mêmes sujets en français
La classification des versions françaises
Venons-en aux versions françaises des 109 articles bretons qui ont un équivalent. Nous les avons classées avec les mêmes réglages : classification simple sur segments de texte, 12 classes en phase 1, formes de fréquence 3 au moins.
Attention à la langue à l’ouverture du corpus. IRaMuTeQ reprend les réglages de la dernière ouverture : après le corpus breton, il nous a donc proposé la langue « autre », sans que nous y prenions garde. Notre premier essai s’est arrêté sur une erreur de R peu parlante (« la duplication de ‘row.names’ est interdite »). Vérifiez donc, dans le fichier Corpus.cira du corpus ou dans sa description, que la langue est bien french.
| Indicateur | Breton (121 articles) | Français (109 versions) |
|---|---|---|
| Segments de texte | 2 068 | 12 799 |
| Occurrences | 75 457 | 464 271 |
| Lemmes | 8 340 | 20 591 |
| Formes actives de fréquence ≥ 3 | 2 468 | 7 660 |
| Classes | 5 | 4 |
| Segments classés | 83 % | 81 % |
Pour les mêmes sujets, le corpus français est six fois plus gros. La classification donne 4 classes, avec 81 % de segments classés.
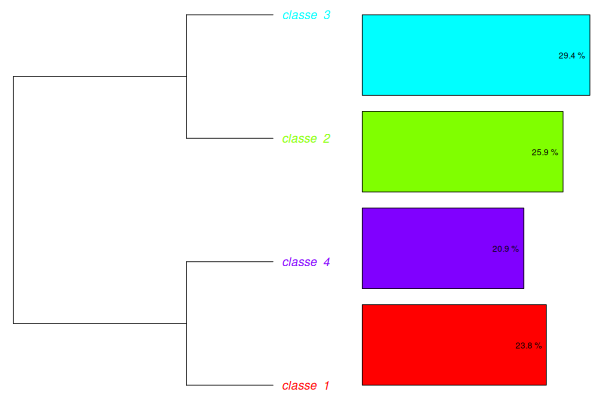
Dès la première partition, le corpus se coupe en deux moitiés : d’un côté la technique (classes 1 et 4), de l’autre les personnes et la société (classes 2 et 3).
| Classe | Segments | Nom proposé | Mots caractéristiques (chi² le plus fort) | Articles typiques |
|---|---|---|---|---|
| 1 | 2 470 (23,8 %) | Matériel et systèmes | USB, Windows, périphérique, carte, Linux, clavier, souris, ordinateur, écran, mémoire, exploitation, câble | USB, Imprimante, Carte mère, Linux, Souris, Microsoft Windows, Unix |
| 4 | 2 168 (20,9 %) | Logiciels et données | logiciel, donnée, programme, fichier, bloc, utilisateur, transaction, base, exécuter, serveur, instruction | Rootkit, Système d’exploitation, Base de données, Pair-à-pair, Rançongiciel, Logiciel libre |
| 2 | 2 695 (25,9 %) | Personnes, entreprises et culture | Jobs, jeu, Steve, Apple, Turing, science, studio, société, personnage, Gates, histoire, film, succès, lancement | Steve Jobs, Alan Turing, Tetris, Battlefield 3, Geek, Jeu vidéo, Apple |
| 3 | 3 055 (29,4 %) | Société, économie et droit | Musk, bitcoin, monnaie, Facebook, cryptomonnaies, financier, social, européen, banque, État, loi, politique, Trump | Elon Musk, Facebook, Cryptomonnaie, Bitcoin, Blockchain, Troll (Internet), Wikipédia |
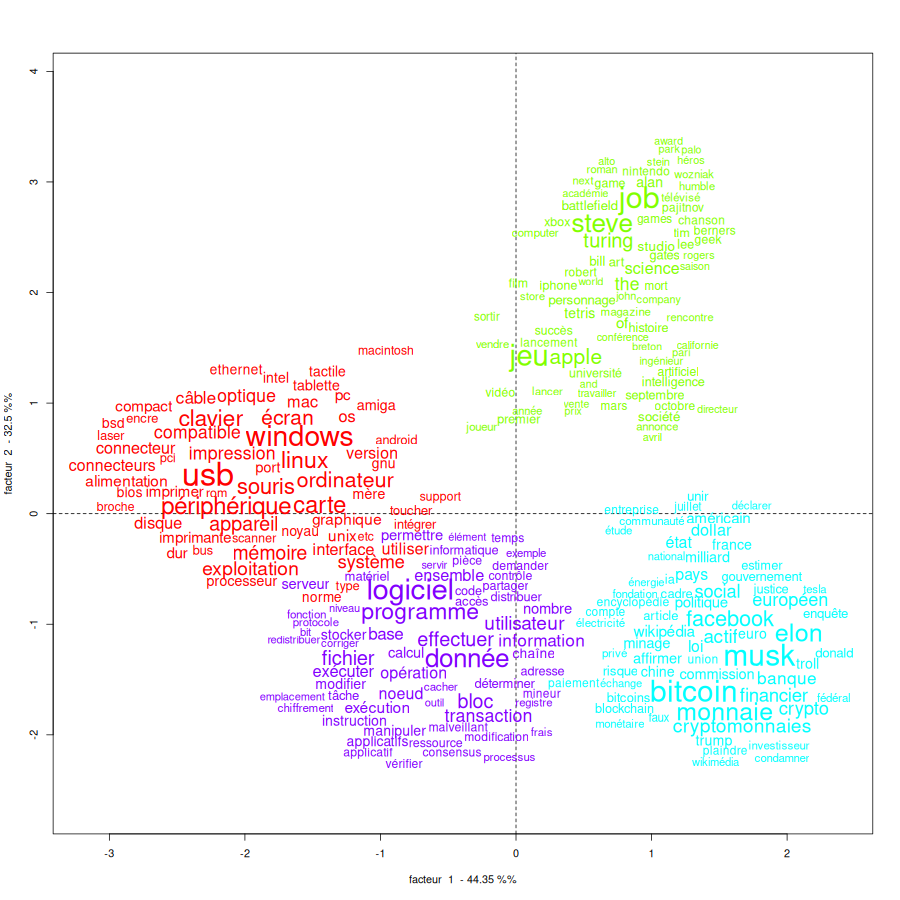
L’AFC montre bien ces deux moitiés : à gauche, le matériel (rouge) et les logiciels (violet) ; à droite, les personnes (vert) et la société (bleu).
Nous n’avons lancé qu’une classification en français, à 12 classes en phase 1. Ses quatre classes sont de taille voisine, entre 21 % et 29 % des segments, ce qui les rend moins fragiles qu’une petite classe ; un second lancement, à 10 classes, permettrait de le vérifier.
Rapprocher les classes des deux langues
Les deux classifications sont indépendantes : les classes bretonnes et françaises n’ont ni les mêmes numéros, ni le même vocabulaire. Pour les comparer, nous sommes passés par les articles. Le script classes_par_article.py de la section 4 donne, pour chaque article, le nombre de segments dans chaque classe. Nous l’avons lancé sur l’analyse française, puis nous avons rapproché les deux tableaux grâce à l’identifiant commun *id_ :
# 1. Rapprocher les articles des deux langues par leur identifiant commun
paires = br.merge(fr, on="id", suffixes=("_br", "_fr"))

# 2. Pour chaque classe bretonne (classe dominante de l'article breton),
#    additionner les segments français de chaque classe française
classes_fr = [c for c in fr.columns if c.startswith("classe_") and c != "classe_0"]
colonnes = [c + "_fr" for c in classes_fr]
tableau = paires.groupby("dominante_br")[colonnes + ["classe_0_fr"]].sum()

# 3. En pourcentage des segments français classés, plus la part de non classés
pourcents = 100 * tableau[colonnes].div(tableau[colonnes].sum(axis=1), axis=0)
C’est le rôle du script comparer_classes.py :
python3 comparer_classes.py resultats/classes_par_article_br.csv \
    resultats/classes_par_article_fr.csv
Nous comptons les segments plutôt que les articles, car un article français touche souvent plusieurs thèmes : seul un sur cinq a au moins 85 % de ses segments dans une même classe, contre plus de la moitié en breton. Le tableau se lit ligne par ligne : pour les articles d’une classe bretonne, comment se répartissent les segments de leurs versions françaises ?
| Classe bretonne de l’article | Matériel et systèmes | Logiciels et données | Personnes, entreprises et culture | Société, économie et droit | Segments français non classés |
|---|---|---|---|---|---|
| Réseaux et matériel | 56 % | 33 % | 4 % | 8 % | 26 % |
| Unix | 48 % | 15 % | 19 % | 17 % | 12 % |
| Jeux vidéo, entreprises et marché | 18 % | 8 % | 50 % | 24 % | 3 % |
| Wikipédia et le Web breton | 2 % | 10 % | 18 % | 70 % | 5 % |
| Langues, langages et usages | 13 % | 31 % | 29 % | 27 % | 35 % |
Les pourcentages des quatre classes portent sur les segments français classés ; la dernière colonne donne la part des segments non classés.
Ce que montre la comparaison
La technique se retrouve, mais découpée autrement. Les articles bretons sur les réseaux, le matériel et Unix tombent, en français, surtout dans « Matériel et systèmes » et « Logiciels et données ». Mais les deux langues ne coupent pas au même endroit. Le breton sépare les réseaux et Unix, parce que l’article Unix breton est très long ; le français sépare le matériel des logiciels et des données, et Unix y rejoint Windows et Linux, parmi les systèmes.
Les mêmes entreprises et les mêmes jeux, racontés autrement. La moitié des segments français des articles bretons « Jeux vidéo, entreprises et marché » tombent dans « Personnes, entreprises et culture ». Le vocabulaire breton de cette classe est celui de l’achat et de la vente : prenañ (acheter), gwerzhañ (vendre), arc’hant (argent), dollar. Le vocabulaire français est plutôt celui du récit : des noms (Jobs, Gates, Wozniak), des dates (septembre, octobre), histoire, lancement, succès. Pour le dire simplement, la version bretonne dit ce que l’on achète, la version française raconte qui l’a fait et quand.
Wikipédia et Facebook : des projets en breton, des controverses en français. 70 % des segments français des articles « Wikipédia et le Web breton » tombent dans « Société, économie et droit ». En breton, l’article Wikipedia raconte la création d’une encyclopédie et ses projets ; en français, il traite aussi de ses critiques et de sa place dans la société, et l’on y lit critiques, fiabilité, vandalisme, controverses, censure. La version française de Facebook, elle, parle d’enquêtes, de lois et de commissions européennes.
La société, l’économie et le droit : la grande absente du breton. C’est la plus grosse classe française (29 % des segments classés), et elle n’a pas d’équivalent en breton. Ses articles phares sont Bitcoin, Intelligence artificielle, Elon Musk, Blockchain, Cryptomonnaie et Facebook. Leurs versions bretonnes existent, mais elles sont courtes : 307 mots pour Bitcoin, contre 21 010 en français ! Elles décrivent le sujet sans entrer dans la régulation, la finance ou la politique.
Il faut toutefois nuancer : cette classe repose en partie sur quelques très longs articles. Bitcoin, Intelligence artificielle, Elon Musk et Blockchain totalisent à eux seuls 1 966 segments, soit 15 % du corpus français. C’est le pendant français de l’article Unix en breton : un article long peut peser sur toute une classe.
Les langues et les langages : un thème breton. La classe bretonne « Langues, langages et usages » n’a pas d’équivalent en français. Les segments de ses articles se dispersent entre les quatre classes françaises, et 35 % ne sont pas classés du tout. En français, les articles Langage de programmation, Compilateur, Traitement automatique des langues ou Linguistique informatique sont pour la plupart non classés : chacun a son vocabulaire technique, sans thème commun. En breton, ces sujets se rejoignent dans une même classe, avec les articles sur la traduction en breton. C’est peut-être le résultat qui nous a le plus frappés : pour un Wikipédia écrit dans une langue minoritaire, la langue est un sujet en soi. Les articles les plus proches des humanités numériques, comme Treiñ e brezhoneg ou Raktres Translate, n’ont d’ailleurs pas d’équivalent français : ils ne peuvent pas figurer dans le corpus des paires.
Les termes de recherche, dans les deux langues
La variable *terme_ existe dans les deux corpus, et ses chi² permettent de comparer le sens que prennent les mots du numérique d’une langue à l’autre :
| Terme | En breton : classe où il est surreprésenté | En français : classe où il est surreprésenté |
|---|---|---|
| informatique / stlenneg | Réseaux et matériel (19) | Logiciels et données (157) |
| numérique / niverel | Jeux vidéo, entreprises et marché (137) | Société, économie et droit (571) |
| internet / genrouedad, kenrouedad | Wikipédia et le Web breton (293) | Société, économie et droit (320) |
| ordinateur / urzhiataer | Unix (70) | Matériel et systèmes (763) |
Sur deux points, les deux langues se ressemblent. Numérique et niverel sont du côté de l’économie et de la société, pas de la technique. Et l’internet est, dans les deux langues, le lieu de projets et de débats publics, plus qu’un réseau de machines. En revanche, si le lien d’informatique avec la technique est net en français (chi² 157), celui de stlenneg l’est beaucoup moins en breton (chi² 19).
Pour aller plus loin, nous avons lancé les spécificités sur la variable terme dans les deux corpus (Analyse → Spécificités et AFC, réglages par défaut). Elles comparent directement le vocabulaire des articles ramenés par chaque terme.
Il faut les lire avec précaution : chaque article n’a qu’un terme dominant, et les formes les plus spécifiques sont souvent les noms des articles eux-mêmes. Les articles ramenés par internet en français sont dominés par Facebook et Wikipédia, ceux de genrouedad en breton par Wikipedia. Les spécificités disent donc d’abord quels articles chaque terme a ramenés.
Elles apportent pourtant deux précisions. D’abord, dans les deux langues, le numérique s’oppose à l’analogique. Les articles ramenés par niverel parlent de photocopieurs, de télécopieurs et de scanners (luc’heilerezioù, pelleiler, skanniñ), où le numérique s’oppose au kemblac’hel (analogique) ; les articles français ramenés par numérique parlent de télévision numérique terrestre : on y trouve TNT, mais aussi analogique, car ces articles racontent le passage de la diffusion analogique à la diffusion numérique. À côté de ce sens technique, le numérique est l’affaire de l’argent : Humble Bundle et Steam en breton, Bitcoin, monnaie et banque en français. Ensuite, stlenneg ramène des articles très variés : Windows, la traduction en breton (treiñ, An Drouizig), les geeks, les bases de données, Linus Torvalds et Elon Musk. En breton, stlenneg est le mot général, celui de la discipline, plus que celui d’un domaine, ce qui explique son lien faible avec la classe technique.
6. Enseignements et limites
Ce que l’on a appris
Sur le numérique, Wikipédia en breton est petit : 121 articles, moins de 80 000 mots. Neuf articles sur dix ont un équivalent en français. Nous nous attendions donc à trouver une version abrégée de Wikipédia en français. Ce n’est pas ce que nous avons trouvé.
D’abord, il est plus technique et plus pratique. Ses grands thèmes sont le matériel, les réseaux et les systèmes, décrits avec un vocabulaire breton souvent forgé pour l’occasion. Il explique comment les choses fonctionnent, et ce que l’on achète.
Ensuite, il parle de sa propre langue. La traduction, les langues et les langages forment une classe à part, qui n’existe pas en français, et les articles propres à Wikipédia en breton sont surtout consacrés au breton lui-même. Il parle aussi de la Bretagne : l’Agence Bretagne Presse, Brezhoweb ou .bzh forment, avec Wikipédia, une petite classe, fragile mais bien réelle.
Enfin, il laisse de côté la société, l’économie et le droit, qui forment pourtant la plus grosse classe française. Bitcoin, l’intelligence artificielle ou Facebook y ont bien leur article, mais en quelques centaines de mots, sans les débats qui occupent la version française. On peut y voir le reflet d’une communauté de contributeurs peu nombreuse, qui écrit d’abord ce qui lui est utile : des définitions, du vocabulaire, des outils pour vivre le numérique en breton.
Les limites de la démarche
Ces résultats ont leurs limites, et nous préférons les dire franchement.
La première tient au périmètre, qui est breton. En partant de la recherche en breton, nous comparons bien les mêmes sujets, mais nous ne voyons pas ce que Wikipédia en français traite et que Wikipédia en breton ignore ; le corpus français issu de sa propre recherche n’en donne qu’un ordre de grandeur, et nous ne l’avons pas classé.
Le corpus breton lui-même ne rassemble que les articles qui emploient nos termes de recherche : Algorithme, Android ou ChatGPT existent en breton, mais n’y sont pas entrés. Nous avons aussi découvert en cours de route que poellad frank, synonyme de meziant frank, aurait ajouté Richard Stallman et Tux.
La deuxième tient aux longueurs, très inégales. Les versions françaises sont six fois plus longues, et les articles les plus longs pèsent lourd : Unix fait 61 % d’une classe bretonne, et quatre articles font 15 % du corpus français. Une classification sur des corpus plus équilibrés, par exemple en limitant la longueur de chaque article, donnerait peut-être d’autres classes.
La troisième tient à la fragilité des petites classes. Nous l’avions vécu en breton : la classe « Wikipédia et le Web breton » apparaissait ou disparaissait selon un seul réglage. La classification double aurait pu nous aider : IRaMuTeQ y découpe le corpus deux fois, avec des segments de longueurs différentes, classe chaque découpage, puis ne garde que les classes qui se retrouvent dans les deux. Une classe qui survit à ce croisement est plus solide qu’une classe obtenue une seule fois. Nous n’avons pas pu la tester, car l’option était grisée dans notre version d’IRaMuTeQ ?, et nous n’avons lancé qu’une classification en français.
La lemmatisation du breton, ensuite, reste imparfaite. Le dictionnaire tiré d’Apertium ne donne qu’une lecture par forme ; la version 3 corrige les erreurs les plus fréquentes, mais il en reste sûrement.
Les spécificités, de leur côté, reposent sur peu d’articles : avec 12 articles sans équivalent français, chaque groupe de formes spécifiques vient d’un ou deux articles. Et « sans équivalent » veut seulement dire « sans lien interlangue vers le français » : plusieurs articles techniques bretons (OSI, supports de transmission, port série) ont en fait un équivalent, qui n’y est pas relié.
L’extraction a aussi ses angles morts : les tableaux de Wikipédia sont écartés, comme nous l’avons vu avec la liste des codes HTTP. Et Wikipédia évolue : nos corpus datent du 20 octobre 2026.
Enfin, les noms des classes sont les nôtres. IRaMuTeQ fournit des listes de mots et de segments ; les nommer, et les rapprocher d’une langue à l’autre, reste une interprétation, que vous pouvez discuter en refaisant l’analyse avec le matériel du dépôt.
Conclusion
En commençant ce travail, nous pensions passer l’essentiel du temps dans IRaMuTeQ. Comme souvent en analyse de textes, et plus largement en analyse de données, c’est plutôt la préparation qui nous a occupés : définir un périmètre commun, appliquer les mêmes règles d’exclusion dans les deux langues, préparer le texte breton, et vérifier le dictionnaire sur le « vrai » corpus. Cette dernière étape nous a d’ailleurs conduits à une troisième version du dictionnaire breton.
Si nous devions résumer les résultats en une phrase, ce serait celle-ci : sur les mêmes sujets, Wikipédia en breton décrit les machines et parle de sa langue, Wikipédia en français raconte les personnes et débat de la société.
Nous retenons aussi trois habitudes, apprises parfois à nos dépens, qui valent pour toute analyse de ce type. Lancer les statistiques textuelles avant la classification, pour repérer les lemmes absurdes. Relancer une classification en changeant un réglage avant d’interpréter une petite classe. Et revenir aux articles, car les classes de segments ne disent pas tout, et un seul long article peut suffire à faire une classe.
Plusieurs pistes restent ouvertes. L’analyse des similitudes, que nous avons dû laisser de côté, mériterait une sélection des formes faite avec soin. Les sous-corpus par thématique d’IRaMuTeQ permettraient d’étudier une seule classe, par exemple celle des langues et des langages. Et l’on pourrait poser la question inverse : partir de Wikipédia en français, par une catégorie plutôt que par une recherche plafonnée, pour voir quels sujets du numérique n’ont pas d’équivalent en breton. Si vous tentez l’une de ces pistes, nous serons curieux de lire vos résultats.
Tout le matériel de cet article est dans le dépôt wiki-numerique-br-fr-iramuteq, et le dictionnaire dans Apertium2iramuteq-bretonV3.
Sources sur les autres langues celtiques
- What is the Coleg Cymraeg Cenedlaethol and what is its future? (Senedd Research)
- About the Coleg Cymraeg Cenedlaethol (Cardiff University)
- UWTSD Branch – Coleg Cymraeg Cenedlaethol
- DASG – History (University of Glasgow)
- Prof. Roibeard Ó Maolalaigh – School of Humanities, Glasgow
- Adapting a Welsh Terminology Tool to Develop a Cornish Dictionary (ACL Anthology)
- ARU – New project aims to REVIVE the Cornish language
- Culture Vannin – Grant supports major addition to Manx resources
A bientôt,
Pierre